实验二 遵守 robots 协议的友好爬虫
一 、 实验目的
1.掌握robots协议的指向请求方式。
2.掌握指定网页robots协议的解析方式。
2.掌握robots协议中不同的useragent爬取给定的网站,并进行保存。
二 、 实验内容
- 对网址url=https://www.gov.cn/yaowen/liebiao/202502/content_7004472.htm进行robots协议的友好爬虫。
三、 程序代码及分步功能解析
import urllib.robotparser
import requests
#读取robots.txt文件
rp = urllib.robotparser.RobotFileParser()
rp.set_url("https://item.taobao.com/robots.txt")
rp.read()
useragent='Googlebot' #模拟Googlebot,能生成文件
#useragent='Baiduspider' #模拟Baiduspider,不能生成文件
url='https://www.gov.cn/yaowen/liebiao/202502/content_7004472.htm'
if rp.can_fetch(useragent, url):
print("允许抓取")
file=requests.get(url)
data=file.content #读取全部
fb=open("C:/Users/Administrator/Desktop/爬虫实践三/bd-html","wb") #将爬取的网页保存在本地
fb.write(data)
fb.close()
else:
print("不允许抓取")
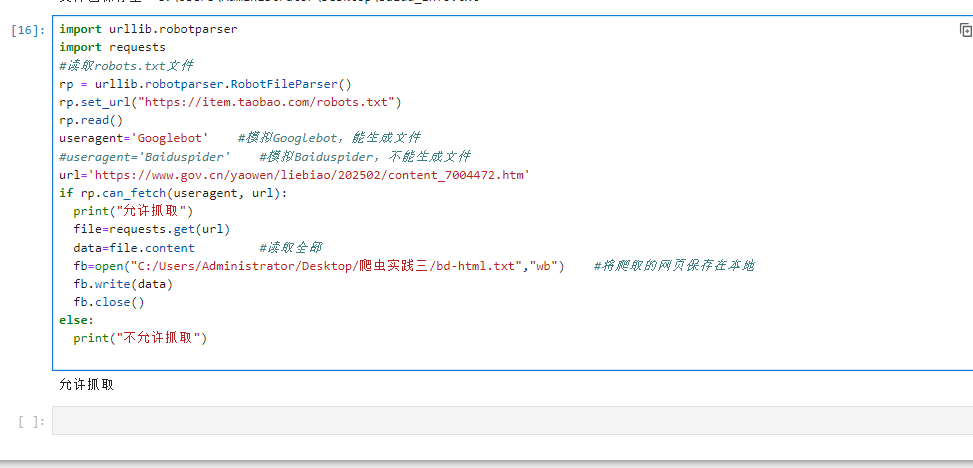
四、程序调试结果

五、 实验总结
本次友好爬虫实验基于 urllib.robotparser 与 requests 库实现,核心验证了遵守 robots 协议的合规爬取流程。实验中,首先通过 RobotFileParser 解析网站 robots.txt 文件,分别以 "Googlebot" 和 "Baiduspider" 为模拟 User - Agent,判断目标政府网站文章 URL 的爬取权限,结果显示仅 "Googlebot" 获允抓取;获允后通过 requests.get () 获取网页内容,以二进制形式保存至本地指定路径,成功完成合规数据采集。此次实验直观呈现了 robots 协议的权限管控逻辑,验证了模拟合规 User - Agent、先校验权限再爬取的操作流程可行性,既保障了爬取行为的合法性,也为基础友好爬虫的开发与实践积累了关键经验。