为了更清晰地说明困惑度的计算过程以及如何通过困惑度判断模型的优劣,我们可以通过一个简单的例子来演示。假设我们有一个非常简单的文本语料库和两个基础的语言模型进行比较。
示例文本
假设我们的文本数据包括以下两个句子:
"cat sits on the mat"
"dog sits on the log"
语言模型
我们构建两个不同的语言模型来预测句子中的下一个词:
模型 A:一个简单的统计模型,根据句子中词的实际出现频率来预测下一个词。
模型 B:一个随机预测模型,随机选择任何一个词作为下一个词的预测。
模型 A 的预测能力
对于句子 "cat sits on the mat":
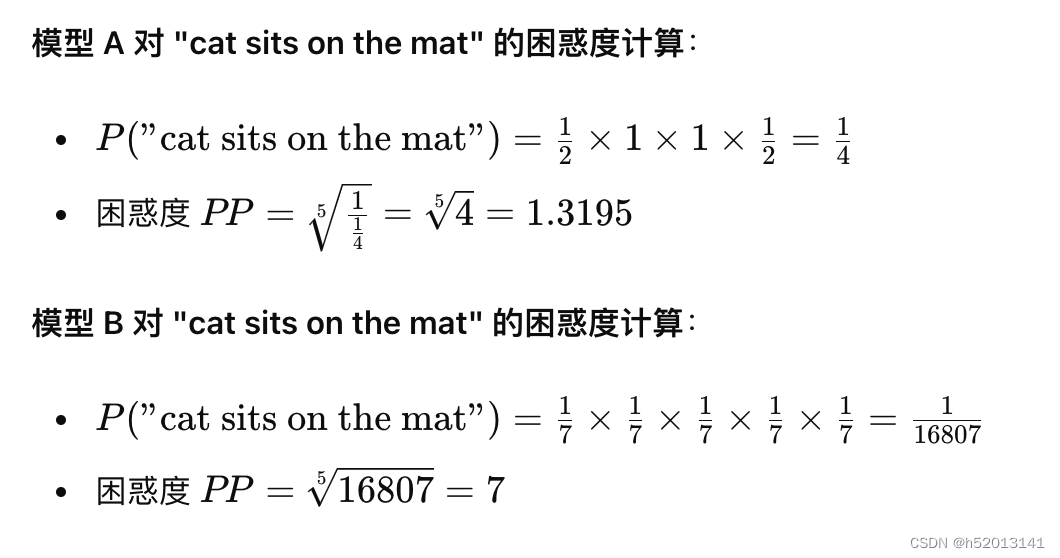
模型 A 观察到 "cat" 和 "dog" 各出现一次,因此预测 "sits" 的概率是 50%。
观察到 "sits" 后面跟着 "on" 的概率是 100%。
类似地,"on" 后 "the" 的概率是 100%,"the" 后 "mat" 或 "log" 的概率各为 50%。
模型 B 的预测能力
模型 B 不考虑以前的词,随机预测下一个词,假设词汇表有五个词(cat, dog, sits, on, the, mat, log),每个词的概率都是 1/7。
困惑度的计算
对于每个模型,我们可以计算困惑度如下:
模型评估
通过比较两个模型的困惑度:
模型 A 的困惑度约为 1.3195,远低于 模型 B 的 7。低困惑度表明模型 A 对文本结构的预测更加精确,因此是一个更好的模型。
模型 B 由于完全是随机预测,其困惑度高,预测能力差。
这个例子说明了困惑度如何帮助我们评估和比较不同语言模型的预测效果。低困惑度通常意味着模型具有更好的预测性能和更低的不确定性,因此在实际应用中更为可靠