技术性屏蔽百度爬虫已经一周了!

很久前明月就发现百度爬虫只抓取、只收录就是不给流量了,加上百度搜索体验越来越差,反正明月已经很久没有用过百度搜索,目前使用的浏览器几乎默认搜索都已经修改成其他搜索引擎了,真要搜索什么,一般都是必应+谷歌结合着使用。所以就一直在纠结要不好屏蔽百度爬虫,上周借助 CloudFlare 的【随机加密】先技术性的屏蔽百度爬虫了。
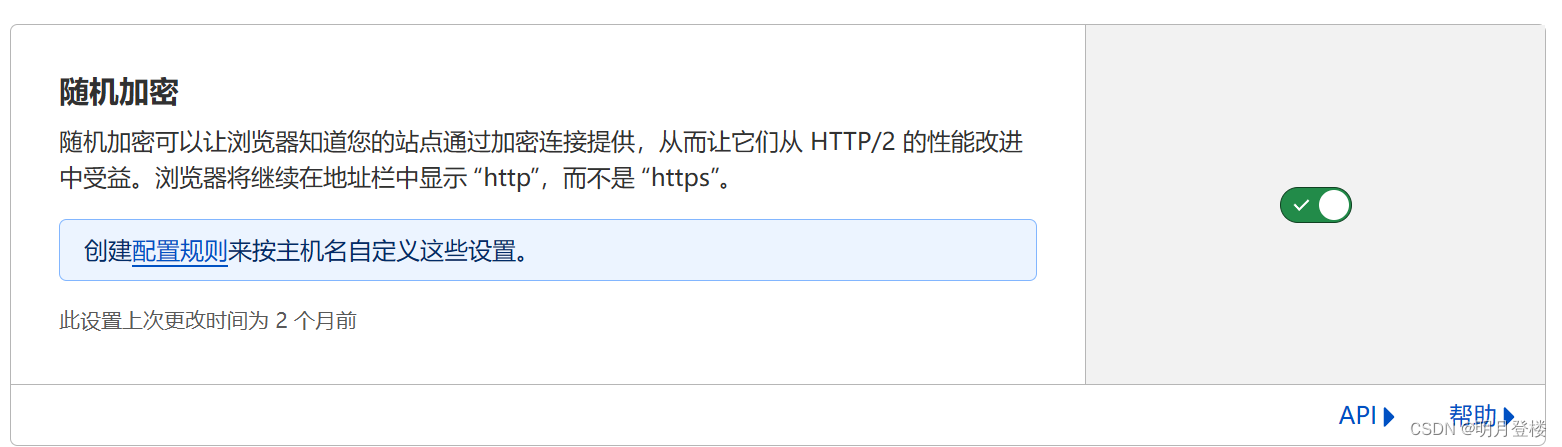
说起来比较好笑都 2024 年了,早就号称支持 HTTPS 的百度爬虫竟然不支持【随机加密 】(可参考【使用 CloudFlare 后百度抓取诊断抓取失败的解决办法】一文),就是这么神奇!

所以我这个所谓的技术性屏蔽百度爬虫说白了就是开启【随机加密】,让百度的爬虫抓取出现报错,今天又继续在 robots.txt 里屏蔽百度爬虫:

复制代码
User-agent: Baiduspider
Disallow: / 
User-agent: Baiduspider-image
Disallow: /

说实话,百度爬虫真的很 low,既然你都不给我流量,我也就没有"供养"你的必要了,反正我现在的感觉就是百度爬虫一直在利用网站养他的 AI,这是我不能接受的,所以必须屏蔽拦截掉。

相关推荐
如夏倾城16 小时前
百度文心(容易被忽略的好用AI)使用方式
人工智能·python·百度·语言模型·dubbo
wuyk55520 小时前
Spider-第07讲-JSON接口与正则提取
爬虫·python·json
feasibility.1 天前
一物降一物?AI逆向没有终局:REA拆App,BLA设套,LASIK清场
人工智能·爬虫·github·逆向·skill·rea
东姬AI3 天前
文心5.5 Flash今日发布:内容管线连配音都自动化了,最后卡住的为什么是「会表演」?
百度·大模型·数字人·ai视频·moe·文心5.5·联合生成
wuyk5553 天前
Spider-第03讲-HTTP速通与读懂响应
网络·爬虫·网络协议·http
xyzzklk9 天前
在Open-WebUI中提升向量化速度
网络·人工智能·爬虫·ai·语言模型·自然语言处理·安卓
严肃小白兔9 天前
Cloudflare 开始区分 AI 爬虫与个人 Agent:网站访问控制应该怎样设计?
人工智能·爬虫
傻啦嘿哟12 天前
高德地图POI爬虫:爬取商户与景点数据,做LBS应用
爬虫
weixin1997010801612 天前
官方授权通道和灰色爬虫,做数据服务该选哪条路(附 python 源码)
c++·爬虫·python
LaughingZhu12 天前
Product Hunt 热榜 2026-11-02:Screen Studio 4.0、ClawsGO Science、Riverside Agents
人工智能·深度学习·神经网络·数码相机·搜索引擎·百度