爬虫如何提高效率?
我们可以选择多线程,多进程,协程等操作完成异步爬取。
异步:把一个变成多个
线程:执行单位
进程:资源单位,每一个进程至少有一个线程
if name == 'main':
print("nihao")
相当于一个线程。
多线程
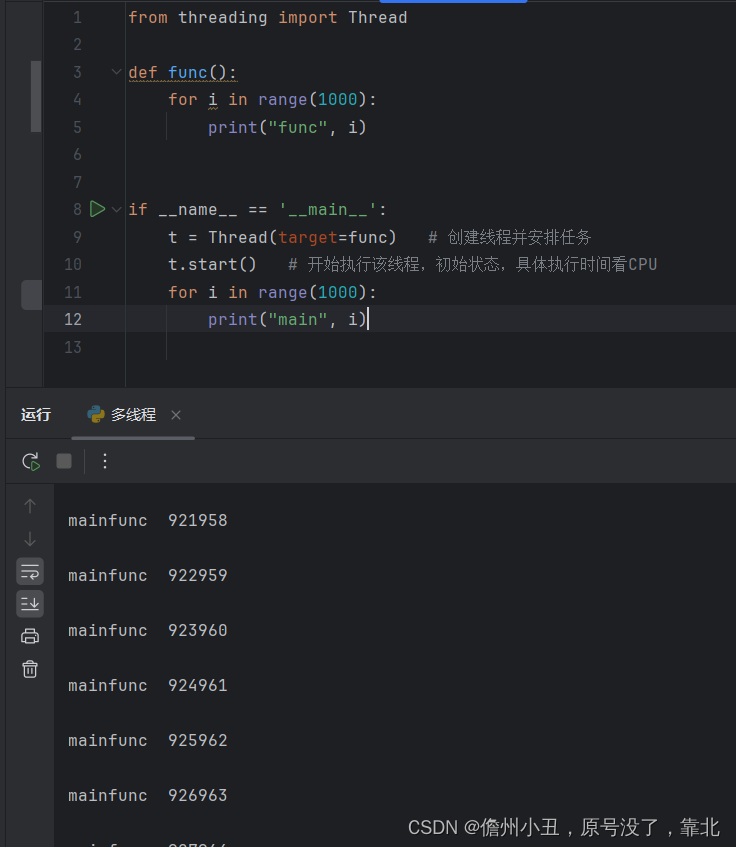
可以看到打印的是有两个,
mainfunc 921958
一个线程只打印一对,加入了一个线程后打印两对,有两个线程在工作。
原理:使用Thread库
第二个使用class类去继承
from threading import Thread

class MyThread(Thread):
    def run(self):
        for i in range(1000):
            print("子线程", i)

if __name__ == '__main__':
    t = MyThread()
    t.start()
    for i in range(1000):
        print("主线程", i)
运行结果:
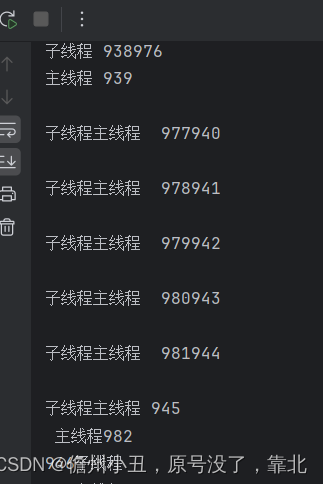
可以看到混在一起了,完成了多线程的操作。
多进程
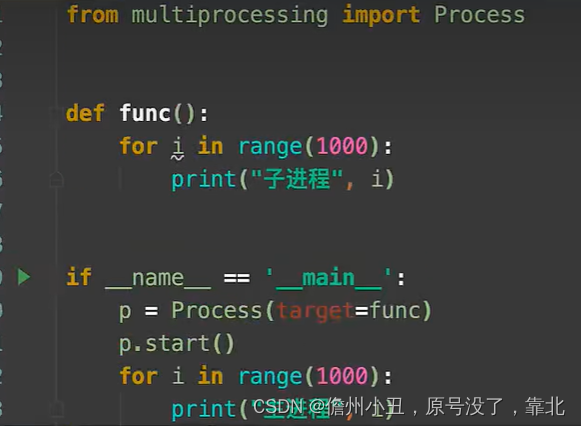
使用class一样。
线程池和进程池
线程池:一次性开辟一些线程,我们用户直接给线程池提交任务。线程任务的调度交给线程池来完成。
#线程池:一次性开一些线程,我们用户直接给线程池子提交任务,线程任务的调度交给线程池来完成
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor
def fn(name):
    for i in range(1000):
        print(name,i)

if __name__ == '__main__':
# 创建线程池
    with ThreadPoolExecutor(50) as t:
        for i in range(100):
            t.submit(fn, name=f"线程{i}")
            #等待线程池中的任务全部执行完毕,才继续执行(守护)

    print("123")
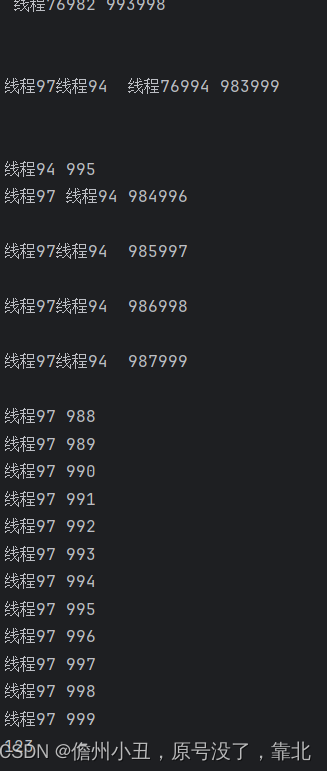
输出:
进程池
实战
- 如何提取单个页面的内容。
2 .上线程池,多个页面同时抓取。
import requests
from lxml import etree
import csv
from concurrent.futures import ThreadPoolExecutor

f = open("da.csv", mode="w", encoding='utf-8')
csvwriter = csv.writer(f)

def download_one_page(url):
    resp = requests.get(url)
    # print(resp.text)
    html = etree.HTML(resp.text)
    table = html.xpath("/html/body/div[2]/div[4]/div[1]/table")[0]
    trs = table.xpath("./tr[position()>1]")
    # 拿到每个str
    for tr in trs:
        txt = tr.xpath("./td/text()")
        txt = (item.replace("\\", "").replace("/", "") for item in txt)
        # 把数据存储到文件中
        csvwriter.writerow(txt)
    print(url, "提取完毕!")


if __name__ == '__main__':
    # for i in range(1, 14870):
     # download_one_page(f"http://www.xinfadi.com.cn/marketanalysis/0/list/{i}.shtml")

     with ThreadPoolExecutor(50) as t:
         for i in range(1, 200):
             t.submit(download_one_page, f"http://www.xinfadi.com.cn/marketanalysis/0/list/{i}.shtml")

     print("全部下载完毕!")
但是现在这个网址的话访问不了了,这个网址把数据改成客户端渲染了,在源代码是没有数据的,而且是通过post提交来改变页数,只要能够爬取一页数据,就可以多线程来爬取。