起因
昨天测试 使用"https://github.com/VikParuchuri/marker" 将 pdf 转 Markdown的过程中,发现转换后的文件中会保护一些背景图片,是转换过程中,程序把背景图识别为了内容。于是想着怎么把背景图片去掉。
背景水印图片的特征
我这里拿到的PDF图片都是文字类型的,背景水印应该都是后期加进去的。
总结出两个特征:
- 每页都存在相同的背景图片
- 作为背景覆盖了页面大部分区域
基于上面的特征,写代码将背景移除
- 代码:
python
import fitz

def scan_background_images(pdf_path):
    doc = fitz.open(pdf_path)
    num_pages = len(doc)
    image_usage = {}  # 字典来记录每个图片的使用情况和页面面积覆盖

    # 遍历文档中的每一页
    for page in doc:
        page_area = abs(page.rect)  # 计算页面面积
        images = page.get_images(full=True)

        for img in images:
            xref = img[0]
            img_rect = page.get_image_rects(xref)
            img_area = sum([abs(rect) for rect in img_rect])  # 计算该图片在当前页面的总覆盖面积

            if img_area / page_area >= 0.5:  # 判断是否覆盖了超过50%的页面面积
                if xref in image_usage:
                    image_usage[xref]['count'] += 1
                    image_usage[xref]['pages'].add(page.number)
                else:
                    image_usage[xref] = {'count': 1, 'pages': set([page.number])}

    # 确定在至少80%的页面上重复出现的图片
    background_images = []
    threshold = 0.8 * num_pages  # 计算至少需要出现在多少页面上

    for xref, data in image_usage.items():
        if data['count'] >= threshold:
            background_images.append(xref)

    # 移除背景图片
    for page in doc:
        for xref in background_images:
            page.clean_contents()  # 清理页面内容,准备删除操作
            page.delete_image(xref)

    # 保存修改后的PDF
    new_pdf_path = pdf_path.replace('.pdf', '_no_bg.pdf')
    doc.save(new_pdf_path)
    doc.close()

    return new_pdf_path

# 使用函数
pdf_path = "example.pdf"
new_pdf_path = scan_background_images(pdf_path)
print("Modified PDF saved to:", new_pdf_path)- 依赖
bash
pip install PyMuPDF效果
- 去背景前
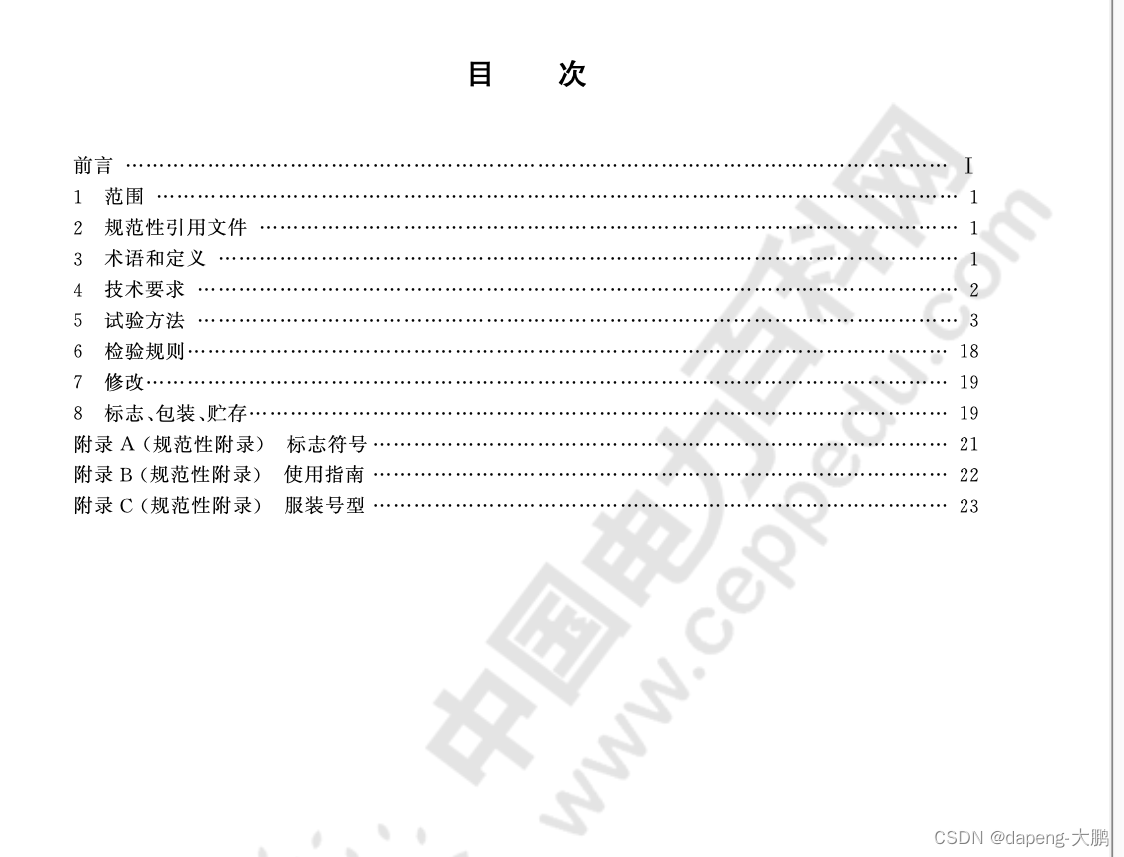
- 去背景后