目录
[1.1 ELK是什么](#1.1 ELK是什么)
[1.2 Elasticsearch](#1.2 Elasticsearch)
[1.3 Logstash](#1.3 Logstash)
[1.4 Kibana](#1.4 Kibana)
[1.5 为什么使用ELK](#1.5 为什么使用ELK)
[2.1 工作原理](#2.1 工作原理)
[2.2 ELK的应用架构图](#2.2 ELK的应用架构图)
[3.1 环境部署](#3.1 环境部署)
[3.2 前期环境](#3.2 前期环境)
[3.3 安装Elasticsearch](#3.3 安装Elasticsearch)
[3.3.1 修改配置](#3.3.1 修改配置)
[3.3.2 查看节点信息](#3.3.2 查看节点信息)
[3.4 安装Logstash](#3.4 安装Logstash)
[3.4.1 安装服务](#3.4.1 安装服务)
[3.4.2 使用Logstash](#3.4.2 使用Logstash)
[3.4.3 对接elasticsearch](#3.4.3 对接elasticsearch)
[3.5 安装kibana](#3.5 安装kibana)
[4.1 收集nginx日志](#4.1 收集nginx日志)
[4.1.1 环境介绍](#4.1.1 环境介绍)
[4.1.2 配置](#4.1.2 配置)
[4.2 收集tomcat日志](#4.2 收集tomcat日志)
[4.2.1 环境介绍](#4.2.1 环境介绍)
[4.2.2 配置](#4.2.2 配置)
[4.3 使用Redis接收tomcat日志](#4.3 使用Redis接收tomcat日志)
[4.3.1 环境介绍](#4.3.1 环境介绍)
[4.3.2 配置](#4.3.2 配置)
[4.3.3 其他logstash服务器从redis读取数据](#4.3.3 其他logstash服务器从redis读取数据)
一、ELK介绍
1.1 ELK是什么
通俗来讲,ELK 是由 Elasticsearch、Logstash、Kibana 三个开源软件的组成的一个组合体,ELK 是 elastic 公司研发的一套完整的日志收集、分析和展示的企业级解决方案,在这三个软件当中,每个软件用于完成不同的功能,ELK 又称为ELK stack,官方域名为 elastic.co,ELK stack 的主要优点有如下几个:处理方式灵活: elasticsearch 是实时全文索引,具有强大的搜索功能配置相对简单:elasticsearch 的 API 全部使用 JSON 接口,logstash 使用模块配置,kibana 的配置文件部分更简单。检索性能高效:基于优秀的设计,虽然每次查询都是实时,但是也可以达到百亿级数据的查询秒级响应。集群线性扩展:elasticsearch 和 logstash 都可以灵活线性扩展前端操作绚丽:kibana 的前端设计比较绚丽,而且操作简单。
1.2 Elasticsearch
一个高度可扩展的开源全文搜索和分析引擎,它可实现数据的实时全文搜索。
搜索、支持分布式可实现高可用、提供 API 接口,可以处理大规模日志数据,比如 Nginx、Tomcat、系统日志等功能。
Elasticsearch 使用 Java 语言开发,是建立在全文搜索引擎 Apache Lucene 基础之上的搜索引擎,Apache Lucene - Welcome to Apache Lucene。
Elasticsearch 的特点:
-
实时搜索、实时分析
-
分布式架构、实时文件存储
-
文档导向,所有对象都是文档
-
高可用,易扩展,支持集群,分片与复制
-
接口友好,支持 json
1.3 Logstash
Logstash 是一个具有实时传输能力的数据收集引擎,其可以通过插件实现日志收集和转发,支持日志过滤,支持普通 log、自定义 json 格式的日志解析,最终把经过处理的日志发送给 elasticsearch。
1.4 Kibana
Kibana 为 elasticsearch 提 供 一 个 查 看 数 据 的 web 界 面 , 其 主 要 是 通 过elasticsearch 的 API 接口进行数据查找,并进行前端数据可视化的展现,另外还可以针对特定格式的数据生成相应的表格、柱状图、饼图等。
1.5 为什么使用ELK
ELK 组件在海量日志系统的运维中,可用于解决以下主要问题:
-
分布式日志数据统一收集,实现集中式查询和管理
-
故障排查
-
安全信息和事件管理
-
报表功能
二、ELK原理
2.1 工作原理
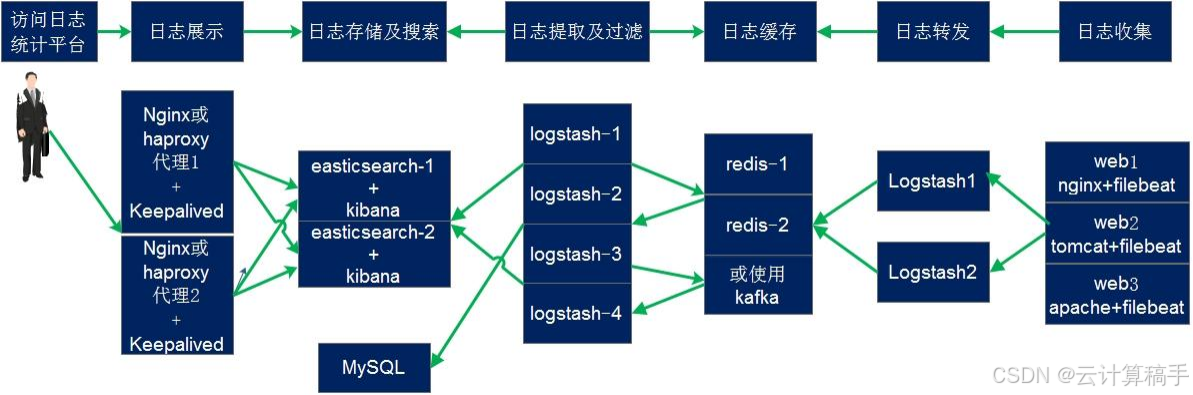
(1)在所有需要收集日志的服务器上部署Logstash;或者先将日志进行集中化管理在日志服务器上,在日志服务器上部署 Logstash。
(2)Logstash 收集日志,将日志格式化并输出到 Elasticsearch 群集中。
(3)Elasticsearch 对格式化后的数据进行索引和存储。
(4)Kibana 从 ES 群集中查询数据生成图表,并进行前端数据的展示。
总结:logstash作为日志搜集器,从数据源采集数据,并对数据进行过滤,格式化处理,然后交由Elasticsearch存储,kibana对日志进行可视化处理。
2.2 ELK的应用架构图
三、ELK的安装部署
3.1 环境部署
bash
Elasticsearch集群:
node1节点1:192.168.254.10    #内存4G及以上
node2节点2:192.168.254.20    #内存4G及以上

Logstash、Kibana节点:
应用程序节点3:192.168.254.100
3.2 前期环境
bash
#java环境
yum -y install java-1.8.0-openjdk.x86_64 java-1.8.0-openjdk-devel

#关闭防火墙
systemctl stop firewalld
setenforce 0
3.3 安装Elasticsearch
bash
#得到一个安装包,此链接可能无效,请自行获取
wget https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-6.7.2.rpm
rpm -ivh elasticsearch-6.7.2.rpm
#为配置文件做备份
cd /etc/elasticsearch/
mkdir bak
cp -a *.yml bak
3.3.1 修改配置
节点一:
bash
vim elasticsearch.yml

#修改集群名字
cluster.name: my-elk-cluster
node.name: node1
node.master: true
node.data: true
#设置 节点名称 主从之间不能一致  master作为主节点  data作为数据节点
bootstrap.memory_lock: true
#内存锁开启  禁止使用  swap
network.host: 0.0.0.0
#监听地址
http.port: 9200
#  默认使用端口
transport.tcp.port: 9300
#内部传输端口
discovery.zen.ping.unicast.hosts: ["192.168.254.10:9300", "192.168.254.20:9300"]
#自动集群发现,加入主机名  使用单播 类似心跳线
节点二:
bash
vim elasticsearch.yml

#修改集群名字
cluster.name: my-elk-cluster
node.name: node2
node.master: true
node.data: true
#设置 节点名称 主从之间不能一致  master作为主节点  data作为数据节点
bootstrap.memory_lock: true
#内存锁开启  禁止使用  swap
network.host: 0.0.0.0
#监听地址
http.port: 9200
#  默认使用端口
transport.tcp.port: 9300
#内部传输端口
discovery.zen.ping.unicast.hosts: ["192.168.254.10:9300", "192.168.254.20:9300"]
#自动集群发现,加入主机名  使用单播 类似心跳线
节点一与节点二:
bash
#性能调优参数
vim /etc/security/limits.conf
......
*  soft    nofile          65536
*  hard    nofile          65536
*  soft    nproc           32000
*  hard    nproc           32000
*  soft    memlock         unlimited
*  hard    memlock         unlimited


#修改systemd服务管理器
vim /etc/systemd/system.conf
DefaultLimitNOFILE=65536    #设置打开文件数量的默认限制
DefaultLimitNPROC=32000    #设置进程数量的默认限制
DefaultLimitMEMLOCK=infinity    #取消内存锁定限制:将内存锁定限制设置为无限制(infinity),允许服务或进程锁定尽可能多的内存。


vim /etc/sysctl.conf
#一个进程可以拥有的最大内存映射区域数,参考数据(分配 2g/262144,4g/4194304,8g/8388608)
vm.max_map_count=262144

sysctl -p

#重启
reboot

systemctl start elasticsearch.service
systemctl status elasticsearch.service
3.3.2 查看节点信息
bash
浏览器访问
http://192.168.254.10:9200
http://192.168.254.20:9200
查看节点 Node1、Node2 的信息
谷歌插件下载:去谷歌商店,搜索elasticsearch head,下载后可以在此插件页面添加节点IP即可可视化查看
3.4 安装Logstash
节点3:
3.4.1 安装服务
bash
#此处自行去网上获取安装rpm包
rpm -ivh logstash-6.7.2.rpm
#开启服务
systemctl start logstash.service
ln -s  /usr/share/logstash/bin/logstash   /usr/bin/
# 做软连接
3.4.2 使用Logstash
bash
Logstash 命令常用选项:
-f:通过这个选项可以指定 Logstash 的配置文件,根据配置文件配置 Logstash 的输入和输出流。
-e:从命令行中获取,输入、输出后面跟着字符串,该字符串可以被当作 Logstash 的配置(如果是空,则默认使用 stdin 作为输入,stdout 作为输出)。
-t:测试配置文件是否正确,然后退出。

#先在本地测试一下
logstash -e 'input { stdin{} } output { stdout{} }'
# 等待时间较长,要耐心
# 当出现[INFO ] 2024-07-16 00:42:10.635 [Api Webserver] agent - Successfully started Logstash API endpoint {:port=>9600},代表成功
#随便输入你想输入的信息后回车,软件会返回给你一些值
3.4.3 对接elasticsearch
bash
方式一:命令
logstash -e 'input { stdin{} } output { elasticsearch { hosts=>["192.168.254.10:9200"] } }'
//结果不在标准输出显示,而是发送至 Elasticsearch 中,可浏览器访问


方式二:配置文件
cd /etc/logstash/conf.d
vim system-log.conf

input {
    file {
      path => "/var/log/messages"
      type => "system"
      start_position => "beginning"
    }
}
output {
  elasticsearch {
  hosts => [ "192.168.254.10:9200","192.168.254.20:9200" ]
  index => "system-%{+YYYY.MM.dd}"
  }
}


chmod +r /var/log/messages
#添加权限
logstash   -f  system-log.conf
#读取配置文件

#进入浏览器即可查看
3.5 安装kibana
bash
rpm -ivh kibana-6.7.2-x86_64.rpm
cd /etc/kibana/
cp kibana.yml kibana.yml.bak -a

vim kibana.yml

2   		 server.port: 5601          		#打开端口
7    server.host: "0.0.0.0"      	#监听端口
28   elasticsearch.hosts: ["http://192.168.254.10:9200", "http://192.168.254.20:9200"]
     #elasticsearch服务器地址
37   kibana.index: ".kibana"         #打开索引,默认.kibana
96   logging.dest: /var/log/k.log      #指定日志文件, 需要手动建立文件
114  i18n.locale: "zh-CN"              #中文设置

chown kibana:kibana /var/log/k.log
systemctl start kibana
ss -nap |grep 5601

#浏览器测试
访问192.168.254.100:5601
四、Logstash配合其他软件
4.1 收集nginx日志
4.1.1 环境介绍
bash
logstash、nginx节点:192.168.254.20

elasticsearch:
node1:192.168.254.100
node2:192.168.254.120
4.1.2 配置
logstash、nginx节点:
bash
vim /etc/nginx/nginx.conf

http {
# 添加在 http  语句块中
log_format access_json '{"@timestamp":"$time_iso8601",'
'"host":"$server_addr",'
'"clientip":"$remote_addr",'
'"size":$body_bytes_sent,'
'"responsetime":$request_time,'
'"upstreamtime":"$upstream_response_time",'
'"upstreamhost":"$upstream_addr",'
'"http_host":"$host",'
'"url":"$uri",'
'"domain":"$host",'
'"xff":"$http_x_forwarded_for",'
'"referer":"$http_referer",'
'"status":"$status"}';

#修改默认日志格式
access_log  /var/log/nginx/access.log  access_json;

systemctl stop firewalld
setenforce 0
systemctl start nginx

vim /etc/logstash/conf.d/nginx-log.conf

input {
        file {
               path => "/var/log/nginx/access.log"
               type => "nginx"
               start_position => "beginning"
               codec => "json"    #转换格式为json
               stat_interval => 3    #自动检测,3秒间隔
}
}

output {
        elasticsearch {
        hosts => [ "192.168.254.100:9200", "192.168.254.120:9200"]
        index => "nginx-%{+YYYY.MM.dd}"
        }
}

logstash -f  nginx-log.conf
4.2 收集tomcat日志
4.2.1 环境介绍
bash
tomcat节点、logstash节点:192.168.254.20

elasticsearch:
node1:192.168.254.100
node2:192.168.254.120
4.2.2 配置
logstash、tomcat节点:
bash
vim /usr/local/tomcat/conf/server.xml
# 最后一行
<Valve className="org.apache.catalina.valves.AccessLogValve" directory="logs"
prefix="tomcat_access_log" suffix=".log"
pattern="{"clientip":"%h","ClientUser":"%l","authenticated":"%u","AccessTime":"%t","method":"%r","status":"%s","SendBytes":"%b","Query?string":"%q","partner":"%{Referer}i","AgentVersion":"%{User-Agent}i"}"/>
chmod +r /usr/local/tomcat/logs/*
#修改权限
bash
vim /etc/logstash/conf.d/tomcat-log.conf

input {
  file {
    path => "/usr/local/tomcat/logs/tomcat_access_log.*.log"
    type => "tomcat-acceslog"
    start_position => "beginning"
    stat_interval => "3"
  }
}

output {
  if [type] == "tomcat-acceslog" {
    elasticsearch {
      hosts => ["192.168.254.100:9200","192.168.254.120:9200"]
      index => "logstash-tomcat-accesslog-%{+YYYY.MM.dd}"
  }}
}


logstash -f tomcat-log.conf
4.3 使用Redis接收tomcat日志
4.3.1 环境介绍
bash
tomcat、logstash节点:192.168.254.20

elasticsearch:
node1:192.168.254.100
node2:192.168.254.120

redis:192.168.254.50
4.3.2 配置
logstash节点:
bash
vim /etc/logstash/conf.d/redis_tomcat-log.conf
input {
  file {
    path => "/usr/local/tomcat/logs/tomcat_access_log.*.log"
    type => "tomcat-acceslog"
    start_position => "beginning"
    stat_interval => "3"
  }

}

output {
  if [type] == "tomcat-acceslog" {
        redis {
        data_type => list
        key => "tomcat-accesslog-50"
        host => "192.168.254.50"
        port => "6379"
        db => "0"
}
}

}
redis节点:
bash
redis-cli

keys*
1) "tomcat-accesslog-50"
4.3.3 其他logstash服务器从redis读取数据
bash
vim /etc/logstash/conf.d/redis.conf

input {
   redis {
   data_type => "list"
   key => "tomcat-accesslog-50"
   host => "192.168.254.50"
   port => "6379"
   db => "0"
}
}


output {
  elasticsearch {
     hosts => ["192.168.254.100:9200", "192.168.254.120:9200"]
     index => "logstash-tomcat50-accesslog-%{+YYYY.MM.dd}"
}
}
读取后,redis中的数据就会消失