1.累加器类型:
- 数值累加器:用于计算总和、计数等。
- 布尔累加器:用于计算满足特定条件的次数。
- 自定义累加器:允许定义复杂的聚合逻辑和数据结构。
- 集合累加器:用于计算唯一元素的数量,处理去重操作。
在 Spark 中,累加器(Accumulators)是一种可以用来在任务执行过程中进行累积的变量。它们主要用于计算全局的汇总值,如计数或求和。累加器是只加 的变量(即只进行累加操作),并且是分布式的,适合于在多节点环境中进行汇总。
2.示例:
2.1(数值累加器):假设我们有一个包含整数的 RDD,我们希望计算这些整数的总和,并使用累加器来进行累积。
python
# -*- coding: utf-8 -*-
"""
-------------------------------------------------
   File Name:     1.测试累加器
   date:          2024/7/30
-------------------------------------------------
PRODUCT:PyCharm
-------------------------------------------------
"""
from pyspark import SparkContext

# 初始化 SparkContext
sc = SparkContext("local[*]", "测试累加器")
# 创建累加器
accumulator = sc.accumulator(0)


# 定义一个函数来增加累加器的值
def add_to_accumulator(x):
    global accumulator
    accumulator.add(x)


# 创建一个 RDD
rdd = sc.parallelize([1, 2, 3, 4])

# 使用 map 来应用函数,并累加值
rdd.foreach(lambda x: add_to_accumulator(x))

# 由于累加器的值在行动操作之后才会被更新,所以需要使用行动操作触发计算
rdd.count()  # 触发计算

# 打印累加器的值
print("Accumulated value:", accumulator.value)
2.2(自定义累加器):自定义累加器允许你定义自己的累加逻辑和数据结构。这些累加器可以包含复杂的聚合操作和自定义数据结构。
python
# -*- coding: utf-8 -*-
"""
-------------------------------------------------
   File Name:     4.自定义累加器测试
   date:          2024/7/30
-------------------------------------------------
PRODUCT:PyCharm
-------------------------------------------------
"""
from pyspark import SparkContext
from pyspark.accumulators import AccumulatorParam

sc = SparkContext("local[*]", "自定义累加器测试")


# 自定义累加器类
class ListAccumulatorParam(AccumulatorParam):
    def zero(self, value):
        return []

    def addInPlace(self, acc1, acc2):
        return acc1 + acc2


list_accumulator = sc.accumulator([], ListAccumulatorParam())


def add_to_list_accumulator(x):
    global list_accumulator
    list_accumulator.add([x])
    return x


rdd = sc.parallelize([1, 2, 3, 4])
rdd.foreach(lambda x: add_to_list_accumulator(x))

rdd.count()  # 触发计算

print("Accumulated list:", list_accumulator.value)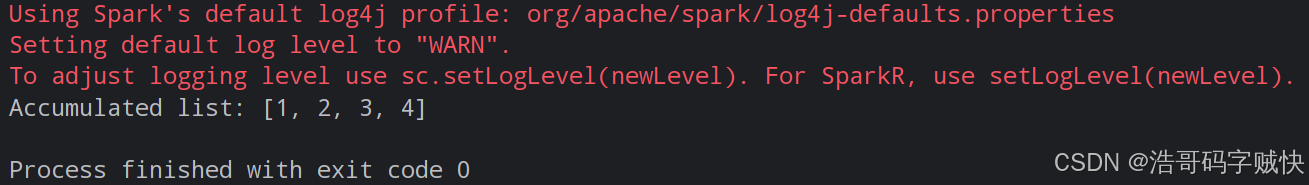
解释
- 自定义累加器类 :
ListAccumulatorParam定义了一个自定义累加器,zero方法返回一个空列表,addInPlace方法合并两个列表。 - 创建自定义累加器 :
list_accumulator = sc.accumulator([], ListAccumulatorParam())创建了一个自定义的累加器实例。 - 更新累加器 :
add_to_list_accumulator(x)函数将每个元素作为列表加到累加器中。 - 应用函数 :
rdd.foreach(lambda x: add_to_list_accumulator(x))将add_to_list_accumulator函数应用到 RDD 的每个元素。 - 触发计算 :
rdd.count()触发了 RDD 的计算,更新累加器的值。 - 查看结果 :
list_accumulator.value获取累加器的最终值,即累加的列表。
- RDD 中的每个元素
[1, 2, 3, 4]被转换为单元素列表[1],[2],[3],[4],并分别添加到累加器中。 - 累加器的
addInPlace方法将这些列表合并成一个完整的列表。
2.3(集合累加器):集合累加器用于跟踪独特的元素集合,例如计算唯一元素的数量。它可以用于去重操作。
python
# -*- coding: utf-8 -*-
"""
-------------------------------------------------
   File Name:     3.集合累加器测试
   date:          2024/7/30
-------------------------------------------------
PRODUCT:PyCharm
-------------------------------------------------
"""
from pyspark import SparkContext
from pyspark.accumulators import AccumulatorParam

sc = SparkContext("local[*]", "集合累加器测试")


# 自定义集合累加器类
class SetAccumulatorParam(AccumulatorParam):
    def zero(self, value):
        return set()

    def addInPlace(self, acc1, acc2):
        return acc1.union(acc2)


set_accumulator = sc.accumulator(set(), SetAccumulatorParam())


def add_to_set_accumulator(x):
    global set_accumulator
    set_accumulator.add(set([x]))
    return x


rdd = sc.parallelize([1, 2, 2, 3, 4, 4])
rdd.foreach(lambda x: add_to_set_accumulator(x))

rdd.count()  # 触发计算

print("Unique elements:", len(set_accumulator.value))
解释
- 自定义累加器类 :
SetAccumulatorParam定义了一个自定义累加器,zero方法返回一个空集合,addInPlace方法合并两个集合。 - 创建自定义累加器 :
set_accumulator = sc.accumulator(set(), SetAccumulatorParam())创建了一个自定义的累加器实例。 - 更新累加器 :
add_to_set_accumulator(x)函数将每个元素作为集合添加到累加器中。 - 应用函数 :
rdd.foreach(lambda x: add_to_set_accumulator(x))将add_to_set_accumulator函数应用到 RDD 的每个元素。 - 触发计算 :
rdd.count()触发了 RDD 的计算,更新累加器的值。 - 查看结果 :
len(set_accumulator.value)获取累加器的最终值,即唯一元素的数量。
- RDD 中的元素
[1, 2, 2, 3, 4, 4]被转换为集合形式,分别是{1},{2},{2},{3},{4},{4}。 - 每个元素的集合被添加到累加器中。由于累加器的合并逻辑是集合的并集,最终的累加器会包含所有唯一的元素,所以最后的计算结果是4。
3.累加器的特点:
- 只加操作:累加器只能执行加操作,不能进行减操作或其他类型的操作。
- 分布式支持:累加器在多节点环境下是分布式的,每个 Executor 都会在其本地更新累加器的值。最后,这些本地值会在 Driver 节点上进行合并。