重生之我们在ES顶端相遇第15 章 - ES 的心脏-倒排索引

文章目录

前言

上一章,简单介绍了 ES 的节点类型。

本章,我们要介绍 ES 中非常重要的一个概念:倒排索引。

ES 的全文索引就是基于倒排索引实现的。

本章内容建议重点学习,因为面试也常问。

为什么叫倒排索引

倒排索引指的是将每一个关键字映射到它出现的文档中。如下图所示

因为结构是倒着的,因此被称为倒排索引。

数据结构

倒排索引分为 2 部分:一部分叫 term directory(term 词典),一部分叫 posting list(倒排列表)。如下图所示

  • term directory

    term 字典,存放着每个单词到对应倒排列表的映射关系

  • posting list

    Docs 是一个数组。其中 1:2:2,6 意思如下

    • 1:文档ID
    • 2:词频(term frequency)
    • 2,6:出现在文档中的第 2,6 个 term。

如何生成

这里涉及到我们之前讲过的分词器。工作流程如下图所示

大体就包含2部分,根据分词器将文本分词,然后根据分词生成倒排索引。

如何查询

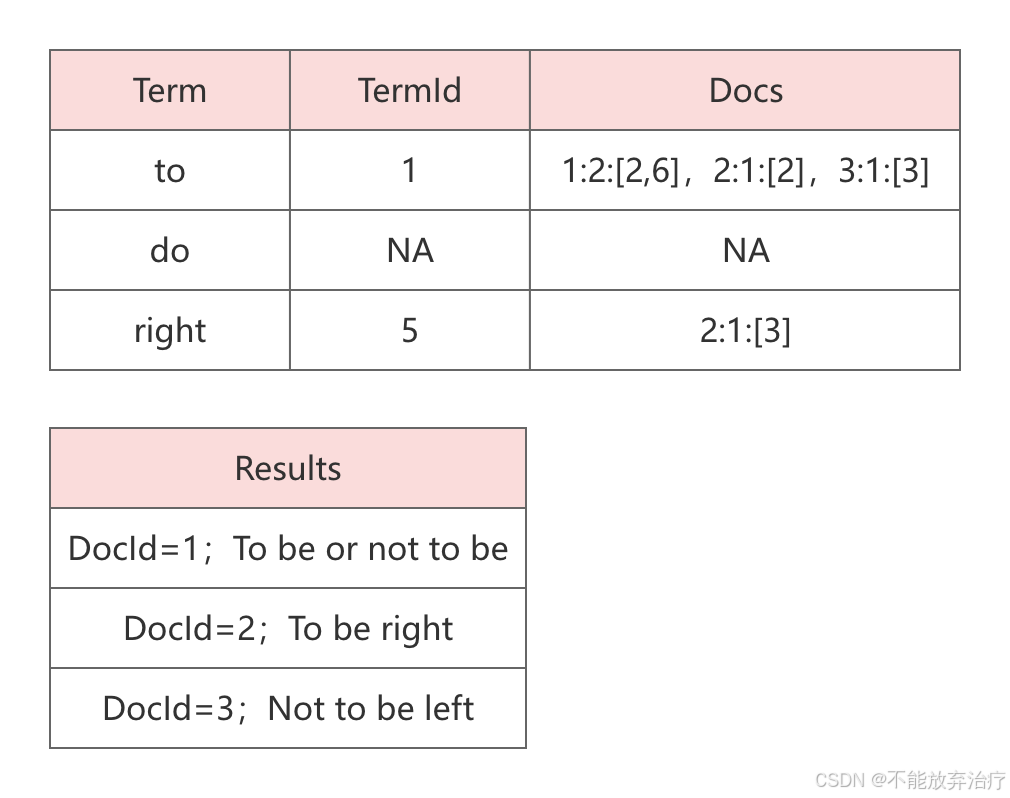
例如我们查询:To do right。

则该文本会先被分词为:to, do, right

对应的结果如下图所示:
TF、IDF

默认情况下,ES 会根据文档与搜索词的相关性得分对结果降序返回。相关性得分与以下 2 个概念有关(稍做了解,后续会出文章做更深入的介绍)

  • Term Frequency(TF):term 在文档中出现的频率,得分正相关。出现频率越高,得分越高
  • Inverted Document Frequency(IDF):term 在 所有文档 中出现的频率,得分负相关。出现频率越高,得分越低。

参考文档

Indexing: Inverted Index

相关推荐
Elasticsearch2 天前
对 OpenTelemetry Kafka 接收器的两项改动,避免一个缓慢的租户拖住其他租户
elasticsearch
全栈陈序员2 天前
Git】从入门到精通(八)—— git log:查看提交历史
大数据·git·elasticsearch
Percep_gan3 天前
Linux中安装gitea,很详细
linux·elasticsearch·gitea
木棉软糖3 天前
5 步确认 TiDB 历史抽数的 Logstash 有没有真的写进 ES
elasticsearch·oracle·tidb
全栈陈序员4 天前
【Git】从入门到精通(十一)—— git reset 三种模式详解
git·elasticsearch
Elasticsearch4 天前
Elasticsearch:稠密向量字段类型
elasticsearch
全栈陈序员4 天前
【Git】从入门到精通(五)—— git add:将文件加入暂存区
大数据·git·elasticsearch
全栈陈序员4 天前
【Git】从入门到精通(七)—— git status:查看仓库状态
大数据·git·elasticsearch
fengye2071614 天前
第三章 编译cpython
大数据·elasticsearch·搜索引擎
Elasticsearch5 天前
使用 Qoder 将 CSV 文件导入 Elasticsearch
elasticsearch