衍生相关 pika+mongo
很多平台不提供完整的数据展示, 翻页只能翻几页,不过提供相关推荐等方法可获取更多的数据;
使用 rabbitmq 是因为数据量可能有几十上百万, 且能持久化
mongo对于数据并不实时的更新到查询里
py
def main():
    # mongodb
    # client = MongoClient('localhost', 27017)
    client = MongoClient("mongodb://localhost:27017")
    db = client['renrendoc']
    # 保存衍生过的
    collection_derive = db['doc_derive']
    # 待衍生 (用于去重)
    collection_stack = db['doc_stack']
    # rabbitmq
    credentials = pika.PlainCredentials('guest', 'guest')
    parameters = pika.ConnectionParameters('localhost', 5672, '/', credentials)
    connection = pika.BlockingConnection(parameters)
    channel = connection.channel()
    queue_name = '123456789'  # 队列名称
    channel.queue_declare(queue=queue_name, durable=True)  # 声明一个队列, durable=True表示队列持久化
    # 初始队列, 保证存在一个符合的
    doc = {
        'doc_id': queue_name,
        'title': '标题名称',
    }
    channel.basic_publish(exchange='', routing_key=queue_name, body=json.dumps(doc))
    while True:
        try:
            # 出队
            method_frame, header_frame, body = channel.basic_get(queue=queue_name, auto_ack=True)
            if not body:
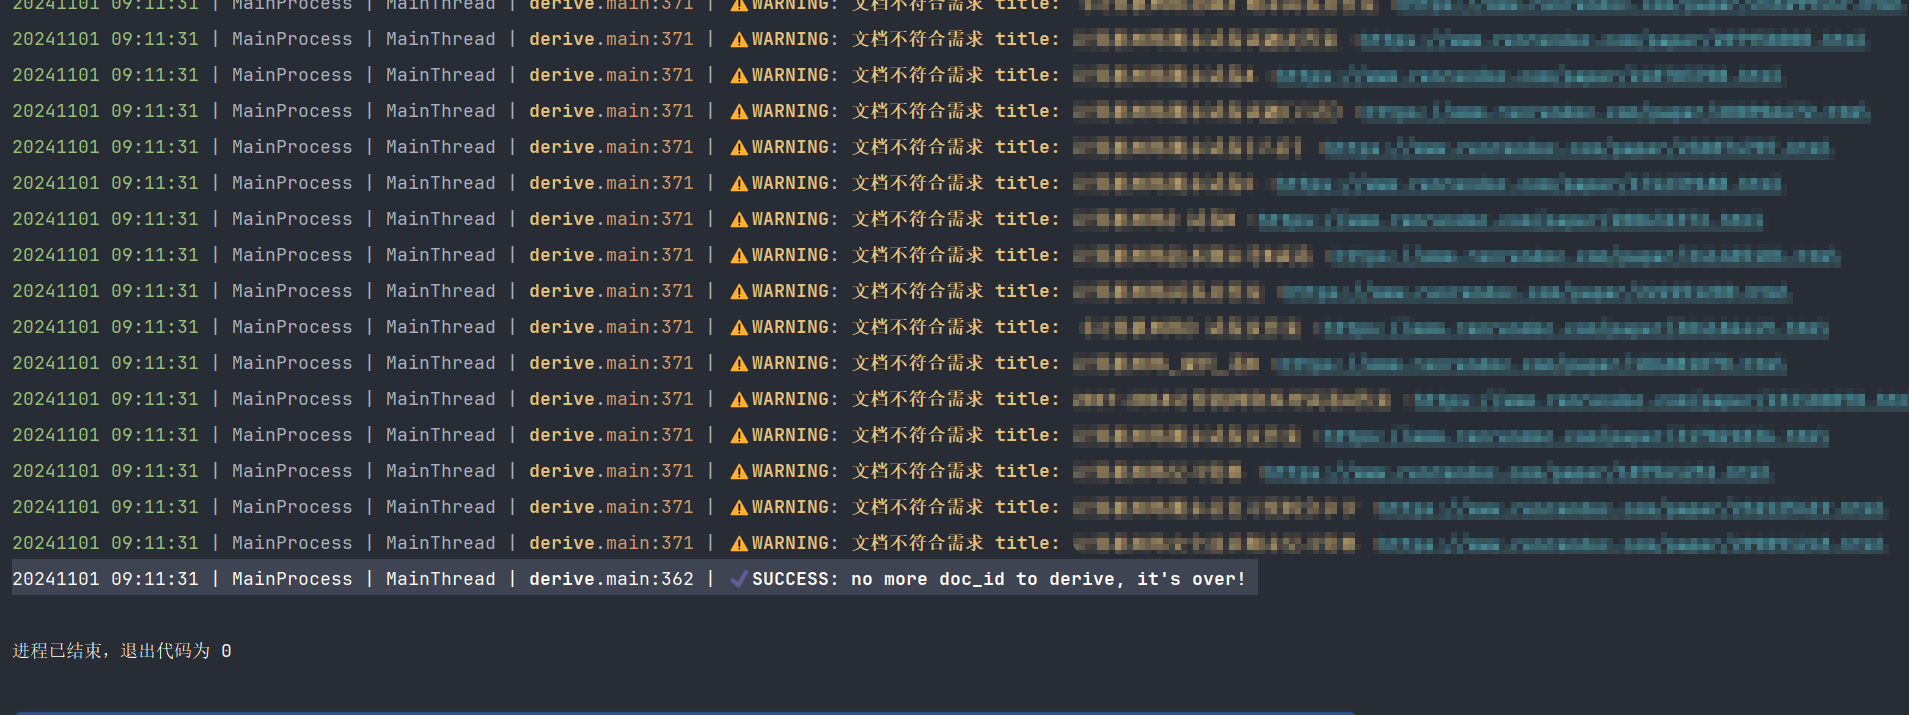
                logger.success("no more doc_id to derive, it's over! ")
                break
            doc = json.loads(body)
            doc_id = doc['doc_id']
            if collection_derive.find_one({'doc_id': doc_id}):
                logger.debug(f'文档已衍生过, doc_id: {doc_id}')
                continue
            # 检查判断是否符合需求
            if check_title(doc['title']) != 1:
                logger.warning(f'文档不符合需求 title: {doc["title"]}')
                continue
            queue_state = channel.queue_declare(queue=queue_name, passive=True)
            logger.info(f'开始衍生 {doc["title"]} , 剩余待处理: {queue_state.method.message_count}')
						# 衍生文档
            doc_derive = derive_docs(doc_id)
            # detail 入库
            collection_derive.insert_one(doc_derive['doc_detail'])
            # 总获取衍生的文档
            all_derive_docs = doc_derive['recommend_docs'] + doc_derive['similar_docs']
            count = 0
            for doc in all_derive_docs:
                if collection_stack.find({'doc_id': doc['doc_id']}):
                    count += 1
                    continue
                json_doc = json.dumps(doc)
                collection_stack.insert_one(doc)
                channel.basic_publish(exchange='', routing_key=queue_name, body=json_doc, properties=pika.BasicProperties(
                    delivery_mode=2,  # 消息持久化, 避免重启服务丢失消息
                ))
            logger.success(f'衍生文档完成 doc_id: {doc_id}, title: {doc_derive['doc_detail']['title']}, 衍生文档数量: {len(all_derive_docs) - count}')
        except Exception as e:
            logger.exception(f'衍生失败: {e}')
        except KeyboardInterrupt:
            logger.warning('程序被强行终止! KeyboardInterrupt')
            break
    # 释放资源
    client.close()
    connection.close()
py
def derive_docs(doc_id):
    """
    无限衍生文档
    :param doc_id:
    :return:
    """
    # 1. 获取文档详情
    doc_detail = request_doc(doc_id)
    agg_id = doc_detail['agg_id']
    # 2. 获取相似文档
    similar_docs = request_similar_docs(agg_id)
    # 3. 使用相似文档获取推荐文档
    total_recommend_docs = []
    with ThreadPoolExecutor(max_workers=10) as executor:
        for doc in similar_docs:
            time.sleep(.1)
            executor.submit(request_recommend_docs, doc['doc_id'], agg_id).add_done_callback(lambda x: total_recommend_docs.extend(x.result()))
    # for doc in similar_docs:
    #     recommend_docs = request_recommend_docs(doc['doc_id'], agg_id)
    #     total_recommend_docs.extend(recommend_docs)
    # 根据doc_id去重,
    recommend_docs = list({doc['doc_id']: doc for doc in total_recommend_docs}.values())

    return {
        'doc_detail': doc_detail,
        'recommend_docs': recommend_docs,
        'similar_docs': similar_docs,
    }
余下函数详细实现不提供
直到队列清空抓取完成