大家好,我是程序员鱼皮。我发现很多程序员都不打日志,有的是 不想 打、有的是 意识不到 要打、还有的是 真不会 打日志啊!
前段时间的模拟面试中,我问了几位应届的 Java 开发同学 "你在项目中是怎么打日志的",得到的答案竟然是 "支支吾吾"、"阿巴阿巴",更有甚者,竟然表示:直接用 System.out.println() 打印一下吧。。。
要知道,日志是我们系统出现错误时,最快速有效的定位工具,没有日志给出的错误信息,遇到报错你就会一脸懵逼;而且日志还可以用来记录业务信息,比如记录用户执行的每个操作,不仅可以用于分析改进系统,同时在遇到非法操作时,也能很快找到凶手。
因此,对于程序员来说,日志记录是重要的基本功。但很多同学并没有系统学习过日志操作、缺乏经验,所以我写下这篇文章,分享自己在开发项目中记录日志的方法和最佳实践,希望对大家有帮助~
一、日志记录的方法
日志框架选型
有很多 Java 的日志框架和工具库,可以帮我们用一行代码快速完成日志记录。
在学习日志记录之前,很多同学应该是通过 System.out.println 输出信息来调试程序的,简单方便。
但是,System.out.println 存在很严重的问题!
首先,System.out.println 是一个同步方法,每次调用都会导致 I/O 操作,比较耗时,频繁使用甚至会严重影响应用程序的性能,所以不建议在生产环境使用。此外,它只能输出简单的信息到标准控制台,无法灵活设置日志级别、格式、输出位置等。
所以我们一般会选择专业的 Java 日志框架或工具库,比如经典的 Apache Log4j 和它的升级版 Log4j 2,还有 Spring Boot 默认集成的 Logback 库。不仅可以帮我们用一行代码更快地完成日志记录,还能灵活调整格式、设置日志级别、将日志写入到文件中、压缩日志等。
可能还有同学听说过 SLF4J(Simple Logging Facade for Java),看英文名就知道了,这玩意并不是一个具体的日志实现,而是为各种日志框架提供简单统一接口的日志门面(抽象层)。
啥是门面?
举个例子,现在我们要记录日志了,先联系到前台接待人员 SLF4J,它说必须要让我们选择日志的级别(debug / info / warn / error),然后要提供日志的内容。确认之后,SLF4J 自己不干活,屁颠屁颠儿地去找具体的日志实现框架,比如 Logback,然后由 Logback 进行日志写入。
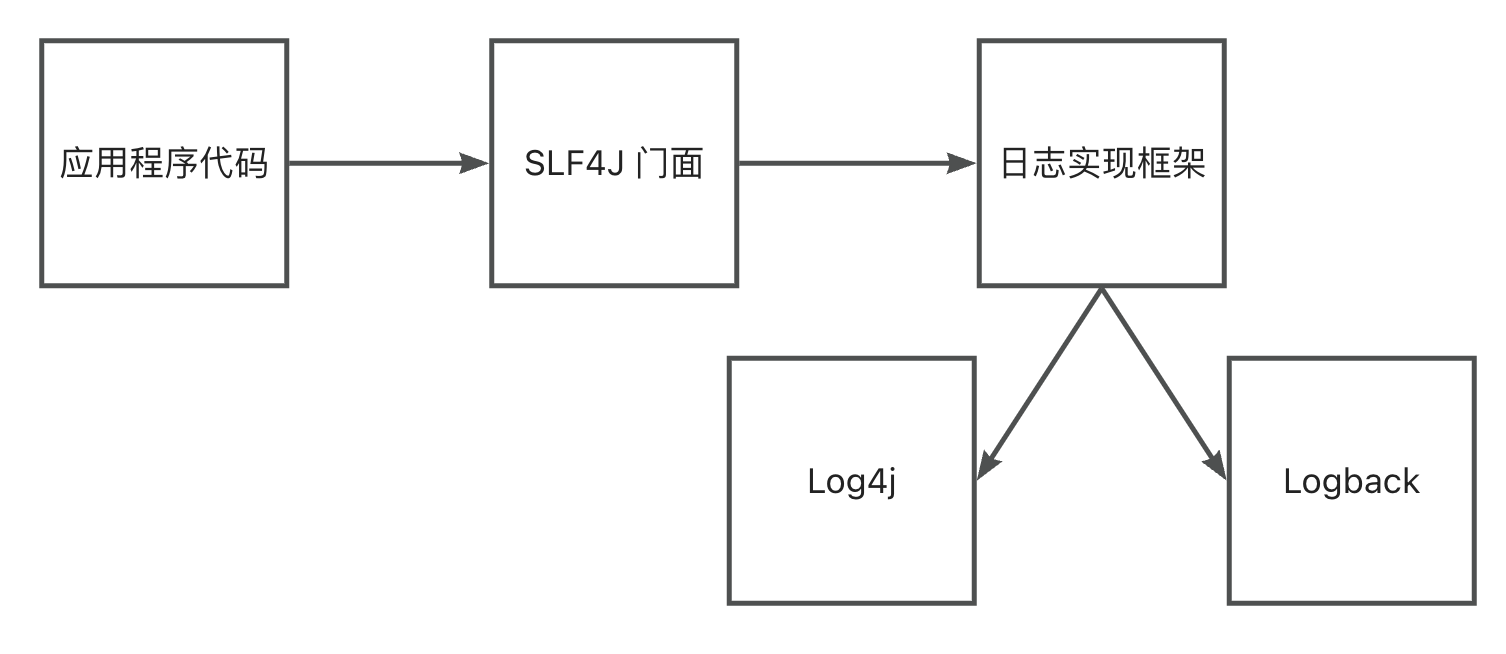
这样做有什么好处呢?无论我们选择哪套日志框架、或者后期要切换日志框架,调用的方法始终是相同的,不用再去更改日志调用代码,比如将 log.info 改为 log.printInfo。
既然 SLF4J 只是玩抽象,那么 Log4j、Log4j 2 和 Logback 应该选择哪一个呢?
值得一提的是,SLF4J、Log4j 和 Logback 竟然都是同一个作者(俄罗斯程序员 Ceki Gülcü)。
首先,Log4j 已经停止维护,直接排除。Log4j 2 和 Logback 基本都能满足功能需求,那么就看性能、稳定性和易用性。
-
从性能来说,Log4j 2 和 Logback 虽然都支持异步日志,但是 Log4j 基于 LMAX Disruptor 高性能异步处理库实现,性能更高。
-
从稳定性来说,虽然这些日志库都被曝出过漏洞,但 Log4j 2 的漏洞更为致命,姑且算是 Logback 得一分。
-
从易用性来说,二者差不多,但 Logback 是 SLF4J 的原生实现、Log4j2 需要额外使用 SLF4J 绑定器实现。
再加上 Spring Boot 默认集成了 Logback,如果没有特殊的性能需求,我会更推荐初学者选择 Logback,都不用引入额外的库了~
使用日志框架
日志框架的使用非常简单,一般需要先获取到 Logger 日志对象,然后调用 logger.xxx(比如 logger.info)就能输出日志了。
最传统的方法就是通过 LoggerFactory 手动获取 Logger,示例代码如下:
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
public class MyService {
private static final Logger logger = LoggerFactory.getLogger(MyService.class);
public void doSomething() {
logger.info("执行了一些操作");
}
}上述代码中,我们通过调用日志工厂并传入当前类,创建了一个 logger。但由于每个类的类名都不同,我们又经常复制这行代码到不同的类中,就很容易忘记修改类名。
所以我们可以使用 this.getClass 动态获取当前类的实例,来创建 Logger 对象:
public class MyService {
private final Logger logger = LoggerFactory.getLogger(this.getClass());
public void doSomething() {
logger.info("执行了一些操作");
}
}给每个类都复制一遍这行代码,就能愉快地打日志了。
但我觉得这样做还是有点麻烦,我连复制粘贴都懒得做,怎么办?
还有更简单的方式,使用 Lombok 工具库提供的 @Slf4j 注解,可以自动为当前类生成一个名为 log 的 SLF4J Logger 对象,简化了 Logger 的定义过程。示例代码如下:
import lombok.extern.slf4j.Slf4j;
@Slf4j
public class MyService {
public void doSomething() {
log.info("执行了一些操作");
}
}这也是我比较推荐的方式,效率杠杠的。
此外,你可以通过修改日志配置文件(比如 logback.xml 或 logback-spring.xml)来设置日志输出的格式、级别、输出路径等。日志配置文件比较复杂,不建议大家去记忆语法,随用随查即可。
二、日志记录的最佳实践
学习完日志记录的方法后,再分享一些我个人记录日志的经验。内容较多,大家可以先了解一下,实际开发中按需运用。
1、合理选择日志级别
日志级别的作用是标识日志的重要程度,常见的级别有:
-
TRACE:最细粒度的信息,通常只在开发过程中使用,用于跟踪程序的执行路径。
-
DEBUG:调试信息,记录程序运行时的内部状态和变量值。
-
INFO:一般信息,记录系统的关键运行状态和业务流程。
-
WARN:警告信息,表示可能存在潜在问题,但系统仍可继续运行。
-
ERROR:错误信息,表示出现了影响系统功能的问题,需要及时处理。
-
FATAL:致命错误,表示系统可能无法继续运行,需要立即关注。
其中,用的最多的当属 DEBUG、INFO、WARN 和 ERROR 了。
建议在开发环境使用低级别日志(比如 DEBUG),以获取详细的信息;生产环境使用高级别日志(比如 INFO 或 WARN),减少日志量,降低性能开销的同时,防止重要信息被无用日志淹没。
注意一点,日志级别未必是一成不变的,假如有一天你的程序出错了,但是看日志找不到任何有效信息,可能就需要降低下日志输出级别了。
2、正确记录日志信息
当要输出的日志内容中存在变量时,建议使用参数化日志,也就是在日志信息中使用占位符(比如 {}),由日志框架在运行时替换为实际参数值。
比如输出一行用户登录日志:
// 不推荐
logger.debug("用户ID:" + userId + " 登录成功。");
// 推荐
logger.debug("用户ID:{} 登录成功。", userId);这样做不仅让日志清晰易读;而且在日志级别低于当前记录级别时,不会执行字符串拼接,从而避免了字符串拼接带来的性能开销、以及潜在的 NullPointerException 问题。所以建议在所有日志记录中,使用参数化的方式替代字符串拼接。
此外,在输出异常信息时,建议同时记录上下文信息、以及完整的异常堆栈信息,便于排查问题:
try {
   // 业务逻辑
} catch (Exception e) {
logger.error("处理用户ID:{} 时发生异常:", userId, e);
}
3、控制日志输出量
过多的日志不仅会占用更多的磁盘空间,还会增加系统的 I/O 负担,影响系统性能。
因此,除了根据环境设置合适的日志级别外,还要尽量避免在循环中输出日志。
可以添加条件来控制,比如在批量处理时,每处理 1000 条数据时才记录一次:
if (index % 1000 == 0) {
   logger.info("已处理 {} 条记录", index);
}
或者在循环中利用 StringBuilder 进行字符串拼接,循环结束后统一输出:
StringBuilder logBuilder = new StringBuilder("处理结果:");
for (Item item : items) {
   try {
       processItem(item);
       logBuilder.append(String.format("成功[ID=%s], ", item.getId()));
  } catch (Exception e) {
       logBuilder.append(String.format("失败[ID=%s, 原因=%s], ", item.getId(), e.getMessage()));
  }
}
logger.info(logBuilder.toString());
如果参数的计算开销较大,且当前日志级别不需要输出,应该在记录前进行级别检查,从而避免多余的参数计算:
if (logger.isDebugEnabled()) {
   logger.debug("复杂对象信息:{}", expensiveToComputeObject());
}
此外,还可以通过更改日志配置文件整体过滤掉特定级别的日志,来防止日志刷屏:
<!-- Logback 示例 -->
<appender name="LIMITED" class="ch.qos.logback.classic.AsyncAppender">
<!-- 只允许 INFO 级别及以上的日志通过 -->
   <filter class="ch.qos.logback.classic.filter.ThresholdFilter">
       <level>INFO</level>
   </filter>
   <!-- 配置其他属性 -->
</appender>
4、把控时机和内容
很多开发者(尤其是线上经验不丰富的开发者)并没有养成记录日志的习惯,觉得记录日志不重要,等到出了问题无法排查的时候才追悔莫及。
一般情况下,需要在系统的关键流程和重要业务节点记录日志,比如用户登录、订单处理、支付等都是关键业务,建议多记录日志。
对于重要的方法,建议在入口和出口记录重要的参数和返回值,便于快速还原现场、复现问题。
对于调用链较长的操作,确保在每个环节都有日志,以便追踪到问题所在的环节。
如果你不想区分上面这些情况,我的建议是尽量在前期多记录一些日志,后面再慢慢移除掉不需要的日志。比如可以利用 AOP 切面编程在每个业务方法执行前输出执行信息:
@Aspect
@Component
public class LoggingAspect {
@Before("execution(* com.example.service..*(..))")
public void logBeforeMethod(JoinPoint joinPoint) {
Logger logger = LoggerFactory.getLogger(joinPoint.getTarget().getClass());
logger.info("方法 {} 开始执行", joinPoint.getSignature().getName());
}
}利用 AOP,还可以自动打印每个 Controller 接口的请求参数和返回值,这样就不会错过任何一次调用信息了。
不过这样做也有一个很重要的点,注意不要在日志中记录了敏感信息,比如用户密码。万一你的日志不小心泄露出去,就相当于泄露了大量用户的信息。
5、日志管理
随着日志文件的持续增长,会导致磁盘空间耗尽,影响系统正常运行,所以我们需要一些策略来对日志进行管理。
首先是设置日志的滚动策略,可以根据文件大小或日期,自动对日志文件进行切分。比如按文件大小滚动:
<!-- 按大小滚动 -->
<rollingPolicy class="ch.qos.logback.core.rolling.SizeBasedRollingPolicy">
   <maxFileSize>10MB</maxFileSize>
</rollingPolicy>
如果日志文件大小达到 10MB,Logback 会将当前日志文件重命名为 app.log.1 或其他命名模式(具体由文件名模式决定),然后创建新的 app.log 文件继续写入日志。
还有按照时间日期滚动:
<!-- 按时间滚动 -->
<rollingPolicy class="ch.qos.logback.core.rolling.TimeBasedRollingPolicy">
   <fileNamePattern>logs/app-%d{yyyy-MM-dd}.log</fileNamePattern>
</rollingPolicy>上述配置表示每天创建一个新的日志文件,%d{yyyy-MM-dd} 表示按照日期命名日志文件,例如 app-2024-11-21.log。
还可以通过 maxHistory 属性,限制保留的历史日志文件数量或天数:
<maxHistory>30</maxHistory>这样一来,我们就可以按照天数查看指定的日志,单个日志文件也不会很大,提高了日志检索效率。
对于用户较多的企业级项目,日志的增长是飞快的,因此建议开启日志压缩功能,节省磁盘空间。
<rollingPolicy class="ch.qos.logback.core.rolling.TimeBasedRollingPolicy">
   <fileNamePattern>logs/app-%d{yyyy-MM-dd}.log.gz</fileNamePattern>
</rollingPolicy>
上述配置表示:每天生成一个新的日志文件,旧的日志文件会被压缩存储。
除了配置日志切分和压缩外,我们还需要定期审查日志,查看日志的有效性和空间占用情况,从日志中发现系统的问题、清理无用的日志信息等。
如果你想偷懒,也可以写个自动化清理脚本,定期清理过期的日志文件,释放磁盘空间。比如:
# 每月清理一次超过 90 天的日志文件
find /var/log/myapp/ -type f -mtime +90 -exec rm {} \;
6、统一日志格式
统一的日志格式有助于日志的解析、搜索和分析,特别是在分布式系统中。
我举个例子大家就能感受到这么做的重要性了。
统一的日志格式:
2024-11-21 14:30:15.123 [main] INFO com.example.service.UserService - 用户ID:12345 登录成功
2024-11-21 14:30:16.789 [main] ERROR com.example.service.UserService - 用户ID:12345 登录失败,原因:密码错误
2024-11-21 14:30:17.456 [main] DEBUG com.example.dao.UserDao - 执行SQL:[SELECT * FROM users WHERE id=12345]
2024-11-21 14:30:18.654 [main] WARN com.example.config.AppConfig - 配置项 `timeout` 使用默认值:3000ms
2024-11-21 14:30:19.001 [main] INFO com.example.Main - 应用启动成功,耗时:2.34秒
这段日志整齐清晰,支持按照时间、线程、级别、类名和内容搜索。
不统一的日志格式:
2024/11/21 14:30 登录成功 用户ID: 12345
2024-11-21 14:30:16 错误 用户12345登录失败!密码不对
DEBUG 执行SQL SELECT * FROM users WHERE id=12345
Timeout = default
应用启动成功
emm,看到这种日志我直接原地爆炸!
建议每个项目都要明确约定和配置一套日志输出规范,确保日志中包含时间戳、日志级别、线程、类名、方法名、消息等关键信息。
<!-- 控制台日志输出 -->
<appender name="CONSOLE" class="ch.qos.logback.core.ConsoleAppender">
   <encoder>
       <!-- 日志格式 -->
       <pattern>%d{yyyy-MM-dd HH:mm:ss.SSS} [%thread] %-5level %logger{36} - %msg%n</pattern>
   </encoder>
</appender>
也可以直接使用标准化格式,比如 JSON,确保所有日志遵循相同的结构,便于后续对日志进行分析处理:
<encoder class="net.logstash.logback.encoder.LoggingEventCompositeJsonEncoder">
   <!-- 配置 JSON 编码器 -->
</encoder>
此外,你还可以通过 MDC(Mapped Diagnostic Context)给日志添加额外的上下文信息,比如用户 ID、请求 ID 等,方便追踪。在 Java 代码中,可以为 MDC 变量设置值:
MDC.put("requestId", "666");
MDC.put("userId", "yupi");
logger.info("用户请求处理完成");
MDC.clear();
对应的日志配置如下:
<!-- 文件日志配置 -->
<appender name="FILE" class="ch.qos.logback.core.rolling.RollingFileAppender">
   <encoder>
       <!-- 包含 MDC 信息 -->
       <pattern>%d{yyyy-MM-dd HH:mm:ss.SSS} [%thread] %-5level %logger{36} - [%X{requestId}] [%X{userId}] %msg%n</pattern>
   </encoder>
</appender>
这样,每个请求、每个用户的操作一目了然。
7、使用异步日志
对于追求性能的操作,可以使用异步日志,将日志的写入操作放在单独的线程中,减少对主线程的阻塞,从而提升系统性能。
除了自己开线程去执行 log 操作之外,还可以直接修改配置来开启 Logback 的异步日志功能:
<!-- 异步 Appender -->
<appender name="ASYNC" class="ch.qos.logback.classic.AsyncAppender">
   <queueSize>500</queueSize> <!-- 队列大小 -->
   <discardingThreshold>0</discardingThreshold> <!-- 丢弃阈值,0 表示不丢弃 -->
   <neverBlock>true</neverBlock> <!-- 队列满时是否阻塞主线程,true 表示不阻塞 -->
   <appender-ref ref="CONSOLE" /> <!-- 生效的日志目标 -->
   <appender-ref ref="FILE" />
</appender>
上述配置的关键是配置缓冲队列,要设置合适的队列大小和丢弃策略,防止日志积压或丢失。
8、集成日志收集系统
在比较成熟的公司中,我们可能会使用更专业的日志管理和分析系统,比如 ELK(Elasticsearch、Logstash、Kibana)。不仅不用每次都登录到服务器上查看日志文件,还可以更灵活地搜索日志。
但是搭建和运维 ELK 的成本还是比较大的,对于小团队,我的建议是不要急着搞这一套。
OK,就分享到这里,洋洋洒洒 4000 多字,希望这篇文章能帮助大家意识到日志记录的重要性,并养成良好的日志记录习惯。学会的话给鱼皮点个赞吧~
日志不是写给机器看的,是写给未来的你和你的队友看的!