1、安装
python
pip install selenium2、浏览器驱动下载
Chrome(google)浏览器驱动
-
下载地址 :http://chromedriver.storage.googleapis.com/index.html 或 https://sites.google.com/a/chromium.org/chromedriver/home
. 下载地址 :http://chromedriver.storage.googleapis.com/index.html 或 https://sites.google.com/a/chromium.org/chromedriver/home
-
下载地址 129 130 等版本 :Chrome for Testing availability
Chrome浏览器驱动(chromedriver )最新版
Firefox浏览器驱动(geckodriver)
Edge浏览器驱动(MicrosoftWebDriver)
IE浏览器驱动(IEDriverServer)
Opera浏览器驱动(operadriver)
PhantomJS浏览器驱动(phantomjs),注意:这个无界面浏览器驱动已经不维护了,不推荐使用,selenium 后续版本也不用支持了。
3、下载浏览器驱动(webdriver)以谷歌浏览器为例
根据自己的操作系统下载相对应的驱动,webdriver 需要和对应的浏览器版本以及 selenium 版本对应。
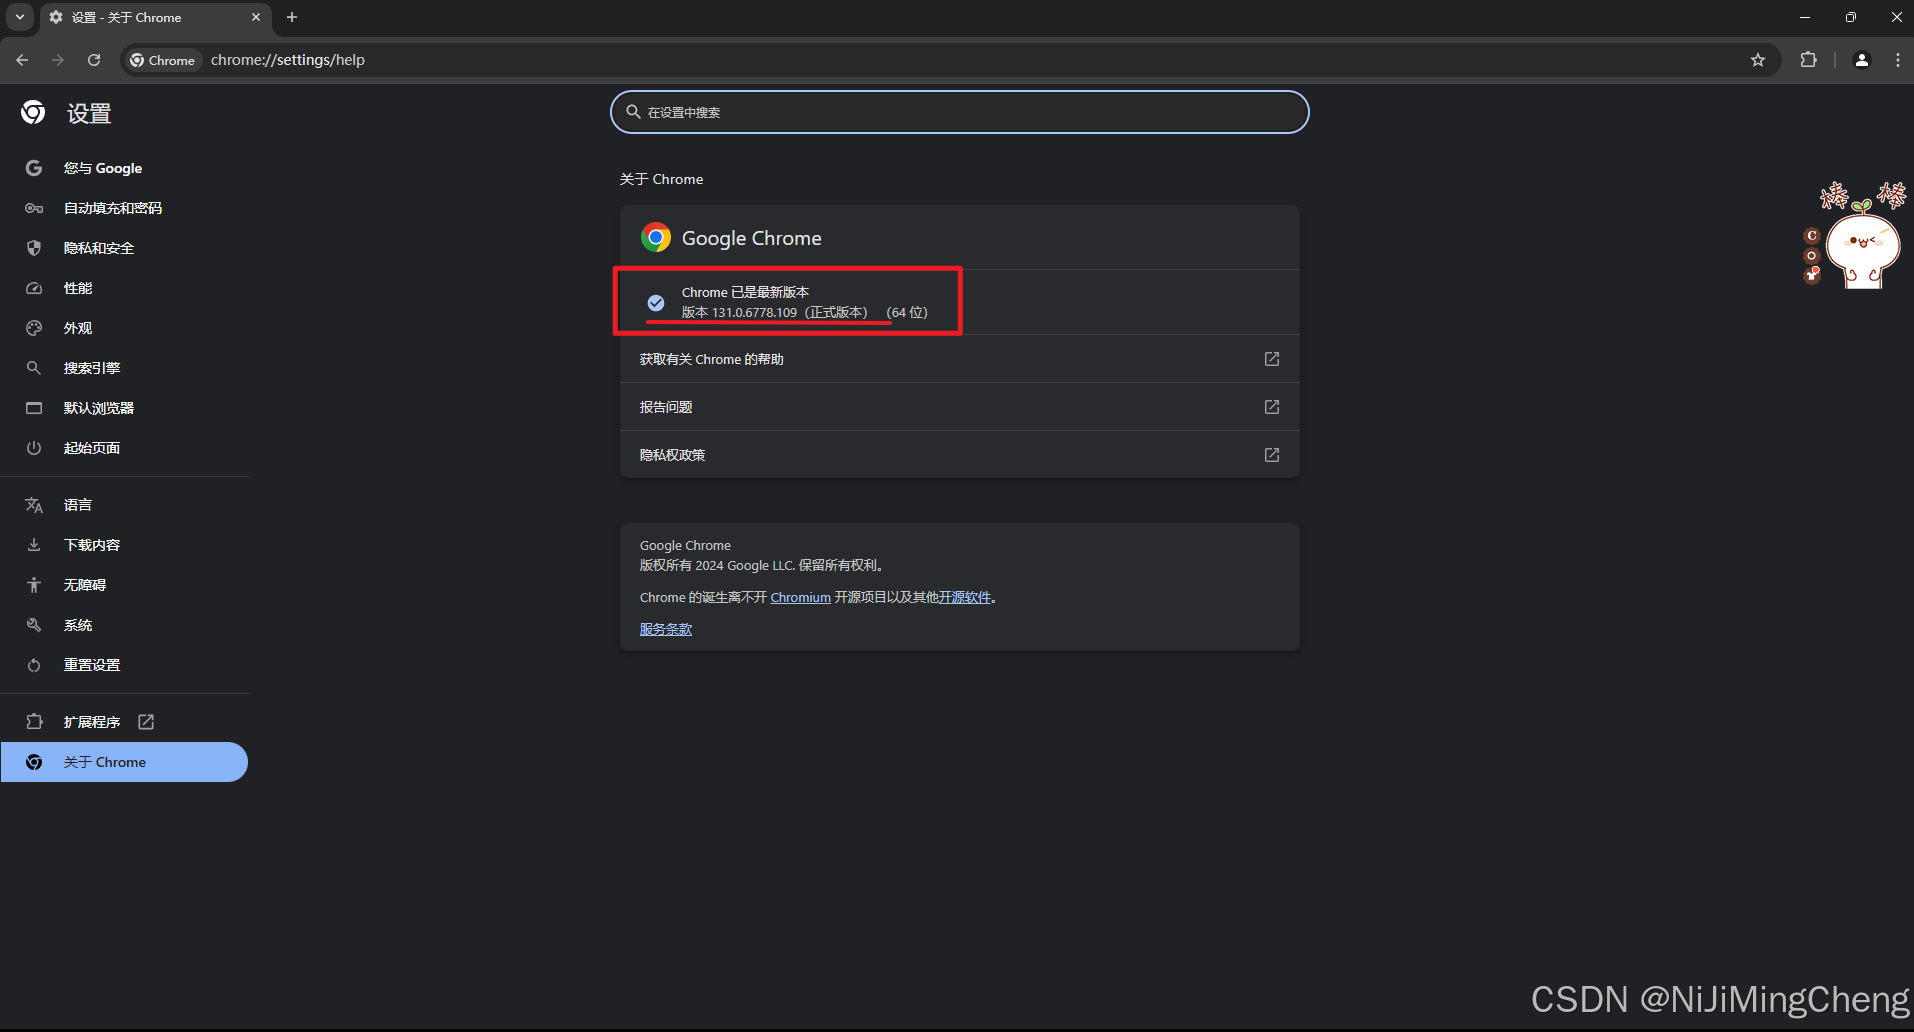
例如当前电脑 Chrome 版本为 版本 131.0.6778.109(正式版本) (arm64),重点只需要看 131.0 后面的小版本号不需要管,打开 Chrome浏览器驱动(chromedriver ) 找到 131.0 开头的下载就行,选这个开头最新的那个。
安装路径下载驱动后解压出来得到驱动可执行文件,不要运行,放到指定目录:
- Windows:复制 webdriver 到 Python 安装路径的根目录下即可。
- Mac:复制 webdriver 到 /usr/local/bin 或 /usr/bin 目录下,看有哪个目录。
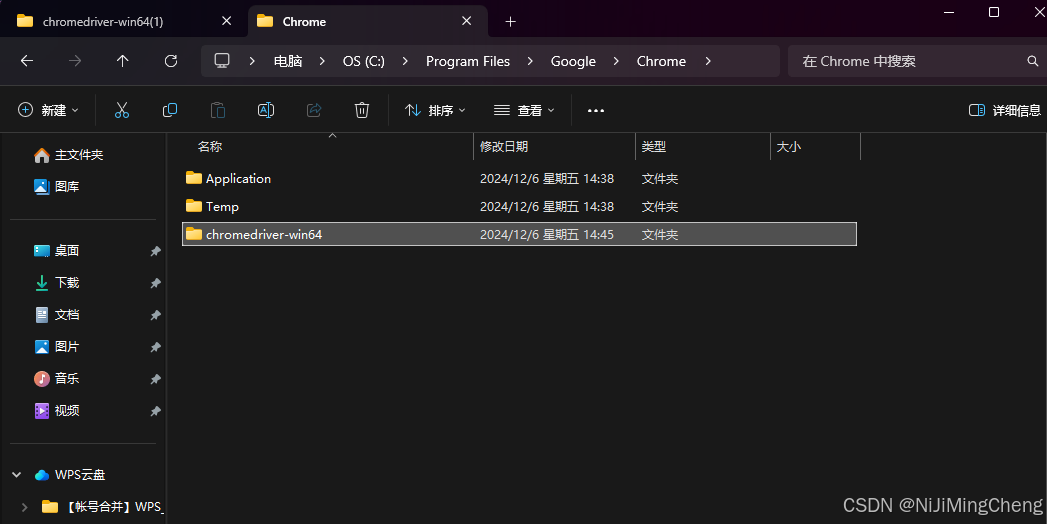
如果实在不清楚放哪里,但是想使用,那就随便找个文件夹一丢,通过自定义路径导入使用就行,比如项目根目录,直接通过路径访问驱动使用。
如下图我放入的位置
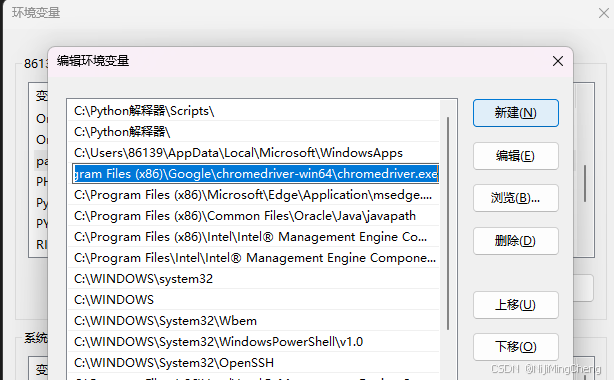
如有需要可以配置环境变量
4、驱动使用

- 验证浏览器驱动是否正常使用,确保
python环境正常,selenium包已经安装。
python
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from time import sleep

# 根据不同操作系统设置Chrome浏览器驱动路径,示例中仅给出了相对简单的示意,实际中可以根据需求更灵活判断
import platform
system = platform.system()
if system == "Windows":
    driver_path = 'chromedriver.exe'
elif system == "Darwin":  # Mac系统
    driver_path = 'chromedriver'
else:
    raise ValueError("不支持的操作系统")

# Chrome浏览器配置选项,添加不自动关闭浏览器的实验性选项
chrome_options = webdriver.ChromeOptions()
chrome_options.add_experimental_option('detach', True)

# 创建Service对象,用于传递给Chrome浏览器驱动
service = Service(driver_path)

# 创建Chrome浏览器驱动对象
driver = webdriver.Chrome(service=service, options=chrome_options)

# 如果要使用Firefox浏览器,取消下面这行注释即可
# driver = webdriver.Firefox()
# 如果要使用Edge浏览器,取消下面这行注释即可
# driver = webdriver.Edge()
# 如果要使用Internet Explorer浏览器,取消下面这行注释即可
# driver = webdriver.Ie()
# 如果要使用Opera浏览器,取消下面这行注释即可
# driver = webdriver.Opera()
# 如果要使用PhantomJS浏览器(注意它已停止维护,现在很少使用了),取消下面这行注释即可
# driver = webdriver.PhantomJS()

# 打开指定网址
driver.get('https://www.baidu.com')
# 休眠5秒
sleep(5)
# 关闭浏览器驱动对象
driver.quit()
5 、无头模式替换
Chrome 无头模式
基本概念 :无头模式是指浏览器在运行时没有可见的用户界面。在这种模式下,浏览器可以在后台执行各种任务,如网页抓取、自动化测试等,而不会弹出浏览器窗口,节省系统资源并提高效率。
代码实现 :首先需要导入selenium库和相关模块,如下:
python
from selenium import webdriver
from selenium.webdriver.chrome.service import Service- 然后设置
ChromeOptions来启用无头模式:
python
chrome_options = webdriver.ChromeOptions()
chrome_options.add_argument('--headless')- 接着,设置
Chrome浏览器驱动路径(这里假设是在 Windows 系统下,路径为chromedriver.exe,你需要根据实际情况修改),并创建Service对象:
python
driver_path = 'chromedriver.exe'
service = Service(driver_path)- 最后,创建
Chrome浏览器驱动对象并使用:
python
driver = webdriver.Chrome(service = service, options = chrome_options)
driver.get('https://www.baidu.com')
print(driver.page_source)
driver.quit()- 在上述代码中,
--headless参数用于开启无头模式。通过driver.get方法访问网页后,可以使用driver.page_source获取网页的源代码,用于后续的分析,比如网页抓取等操作。
- Firefox 无头模式
- 基本概念:同样是让 Firefox 浏览器在没有图形界面的情况下运行,适用于自动化任务和不需要可视化界面的场景。
- 代码实现 :
- 导入相关库:
python
from selenium import webdriver
from selenium.webdriver.firefox.service import Service- 设置
FirefoxOptions来开启无头模式:
python
firefox_options = webdriver.FirefoxOptions()
firefox_options.add_argument('-headless')- 设置
Firefox浏览器驱动路径(假设是geckodriver.exe,根据实际情况修改),并创建Service对象:
python
driver_path = 'geckodriver.exe'
service = Service(driver_path)- 创建
Firefox浏览器驱动对象并使用:
python
driver = webdriver.Firefox(service = service, options = firefox_options)
driver.get('https://www.baidu.com')
print(driver.page_source)
driver.quit()- 在 Firefox 中,
-headless参数开启无头模式。和 Chrome 无头模式类似,通过driver.get方法访问网页后,可以获取网页源代码进行后续操作。
使用无头模式时的注意事项:
- 性能优化:虽然无头模式可以节省资源,但在大量并发请求等情况下,仍需要合理配置资源,如设置合适的请求频率,避免给服务器造成过大压力或被目标网站视为恶意爬虫而封禁。
- 兼容性:部分网站可能会对无头浏览器进行检测并限制访问,这种情况下可能需要采取一些反检测措施,如设置合适的用户代理(User - Agent)来模拟正常浏览器访问。