目录
[1. 前言](#1. 前言)
[2. playwright 介绍](#2. playwright 介绍)
[2.1 区别和优势](#2.1 区别和优势)
[3. playwright 使用](#3. playwright 使用)
[3.1 安装](#3.1 安装)
[3.2 第一个playwright脚本](#3.2 第一个playwright脚本)
[4 定位器](#4 定位器)
[4.1 CSS定位](#4.1 CSS定位)
[4.2 XPATH定位](#4.2 XPATH定位)
[5. Context上下文管理对象](#5. Context上下文管理对象)
[6. 京东滑块验证](#6. 京东滑块验证)
1. 前言
如何处理JD的滑块登录?(若只想查看京东滑块,请直接滑到最下面)

平时所使用的自动化登录工具:Selenium,虽然很好,但是在做京东滑块验证的时候,还是会出现被检测的情况,以至于无法通过校验。
于是,我发现了另外一款自动化工具:playwright,也是非常的好用。
接下来,就来见证它的强大吧!
2. playwright 介绍
这就直接copy过来了:
Playwright 是一个用于自动化浏览器操作的开源工具,由 Microsoft 开发和维护。它支持多种浏览器(包括 Chromium、Firefox 和 WebKit)和多种编程语言(如 Python、JavaScript 和 C#),可以用于测试、爬虫、自动化任务等场景。
这是他的官网:
当然你会想,这和selenium的区别是什么?有什么优势?
2.1 区别和优势
playwright 没有selenium那么臃肿,也没它那么耗费资源,所以它具有以下特性:
-
多浏览器支持:支持所有主流浏览
-
更快的执行速度:Playwright 通过使用浏览器的底层调试协议来进行操作
-
可靠性和稳定性:Playwright 提供了更可靠和稳定的浏览器自动化操作,通过使用浏览器的原生 API 来模拟用户行为,避免了一些传统自动化工具的一些限制和不稳定性
-
支持跨浏览器和跨平台:Playwright 可以在不同浏览器和不同操作系统上运行
-
selenium是基于http协议,而Playwright是基于websocket协议
-
支持屏幕录制功能:根据屏幕录制指定生成相关操作代码
可以看到,playwright相比较于selenium和pyppeteer来说,执行速度更快,更加稳定,也更加方便。
3. playwright 使用
3.1 安装
首先需要安装库:
pip install playwright除此之外,playwright还提供了安装对应的插件和浏览器功能:
(安装耗时较长)
playwright install3.2 第一个playwright脚本
直接附上代码:
python
from playwright.sync_api import sync_playwright

with sync_playwright() as p:  # 创建playwright管理器(执行结束后,自动关闭)
    bro = p.chromium.launch(headless=False)  # 创建浏览器对象
    page = bro.new_page()  # 新建浏览器页面
    page.goto('https://www.baidu.com')  # 请求该网址
    page.wait_for_timeout(1000)  # 等待1s
    title = page.title()  # 获取标题
    content = page.content()  # 获取内容
    print(title)
    print(content)
    # 关闭
    page.close()
    bro.close()
当然,playwright也是支持异步的:
python
import asyncio
from playwright.async_api import async_playwright
async def main():
    async with async_playwright() as p:
        bro = await p.chromium.launch(headless=False,slow_mo=2000)
        page = await bro.new_page()
        await page.goto('https://www.baidu.com')
        title = await page.title()
        content = await page.content()
        print(title,content)
        await page.close()
        await bro.close()

asyncio.run(main())
4 定位器
以下开始介绍常用的定位器,用于定位相应的标签,并做出一系列动作,如CSS定位和XPATH定位
4.1 CSS定位
css定位一般是通过ID、标签、Class来进行定位。
语法结构:page.locator()
交互操作:
1、click() 点击元素
2、fill() 填充内容
3、focus() 聚焦于当前标签
4、inner_text() 获取元素文本
5、get_attribute('href') 获取元素属性
python
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    bro = p.chromium.launch(headless=False, slow_mo=2000)
    page = bro.new_page()
    page.goto('https://www.baidu.com')

    # 定位到输入框,进行文本录入
    page.locator('#kw').fill('playwright')  # id定位
    # 定位搜索按钮,进行点击操作
    page.locator('#su').click()
    # 后退操作
    page.go_back()
4.2 XPATH定位
其实就跟上面一样:
python
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    bro = p.chromium.launch(headless=False,slow_mo=2000)
    page = bro.new_page()
    page.goto('https://www.bilibili.com/')

    #xpath定位
    page.locator('//*[@id="nav-searchform"]/div[1]/input').fill('Python')
    page.locator('//*[@id="nav-searchform"]/div[2]').click()

    page.close()
    bro.close()
5. Context上下文管理对象
浏览器的上下文管理对象Context可以用于管理Context打开/创建的多个page页面。并且可以创建多个Context对象,那么不同的Context对象打开/创建的page之间是相互隔离的(每个Context上下文都有自己的Cookie、浏览器存储和浏览历史记录)。
python
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    bro = p.chromium.launch(headless=False, slow_mo=2000)

    # 创建管理对象
    context = bro.new_context()

    page = context.new_page()
    page.goto('https://www.baidu.com')

    a_list = page.locator('//*[@id="s-top-left"]/a').all()

    for i in a_list:
        i.click()

    # 所有page页面
    pages = context.pages

    for page in pages:
        print(page.title())

    page.close()
    bro.close()
6. 京东滑块验证
好了,相信你已经对playwright有了基本了解,更多方法可自行查看官方文档。
所有的自动化工具都是一样的,最主要的还是定位元素执行一些操作。
以下就是京东滑块代码,其中采用了图鉴进行滑块验证码识别:
python
import base64
import json
import requests
# 一、图片文字类型(默认 3 数英混合):
# 1 : 纯数字
# 1001:纯数字2
# 2 : 纯英文
# 1002:纯英文2
# 3 : 数英混合
# 1003:数英混合2
#  4 : 闪动GIF
# 7 : 无感学习(独家)
# 11 : 计算题
# 1005:  快速计算题
# 16 : 汉字
# 32 : 通用文字识别(证件、单据)
# 66:  问答题
# 49 :recaptcha图片识别
# 二、图片旋转角度类型:
# 29 :  旋转类型
#
# 三、图片坐标点选类型:
# 19 :  1个坐标
# 20 :  3个坐标
# 21 :  3 ~ 5个坐标
# 22 :  5 ~ 8个坐标
# 27 :  1 ~ 4个坐标
# 48 : 轨迹类型
#
# 四、缺口识别
# 18 : 缺口识别(需要2张图 一张目标图一张缺口图)
# 33 : 单缺口识别(返回X轴坐标 只需要1张图)
# 34 : 缺口识别2(返回X轴坐标 只需要1张图)
# 五、拼图识别
# 53:拼图识别
def base64_api(uname, pwd, img, typeid):
    with open(img, 'rb') as f:
        base64_data = base64.b64encode(f.read())
        b64 = base64_data.decode()
    data = {"username": uname, "password": pwd, "typeid": typeid, "image": b64}
    result = json.loads(requests.post("http://api.ttshitu.com/predict", json=data).text)
    if result['success']:
        return result["data"]["result"]
    else:
        #!!!!!!!注意:返回 人工不足等 错误情况 请加逻辑处理防止脚本卡死 继续重新 识别
        return result["message"]
    return ""


def getImgCodeText(imgPath,imgType):#直接返回验证码内容
    #imgPath:验证码图片地址
    #imgType:验证码图片类型
    result = base64_api(uname='账号', pwd='密码', img=imgPath, typeid=imgType)
    return result
python
"""
京东滑块:https://passport.jd.com/new/login.aspx?
"""
from playwright.sync_api import sync_playwright
from Tu import getImgCodeText
from urllib import request


# 有的检测移动速度的 如果匀速移动会被识别出来,来个简单点的渐进
def get_track(distance):  # distance为传入的总距离
    # 移动轨迹
    track = []
    # 当前位移
    current = 0
    # 减速阈值
    mid = distance * 4 / 5
    # 计算间隔
    t = 0.2
    # 初速度
    v = 1
    while current < distance:
        if current < mid:
            # 加速度为2
            a = 4
        else:
            # 加速度为-2
            a = -3
        v0 = v
        # 当前速度
        v = v0 + a * t
        # 移动距离
        move = v0 * t + 1 / 2 * a * t * t
        # 当前位移
        current += move
        # 加入轨迹
        track.append(round(move))
    return track


with sync_playwright() as p:
    bro = p.chromium.launch(headless=False)
    page = bro.new_page()
    page.goto('https://passport.jd.com/new/login.aspx?')

    page.locator('//*[@id="loginname"]').fill('123456@qq.com')
    page.wait_for_timeout(1000)
    page.locator('//*[@id="nloginpwd"]').fill('1234567')
    page.wait_for_timeout(1000)
    page.locator('//*[@id="loginsubmit"]').click()

    page.wait_for_timeout(2000)

    bg_img_src = page.locator('//*[@id="JDJRV-wrap-loginsubmit"]/div/div/div/div[1]/div[2]/div[1]/img').get_attribute(
        'src')

    # 两张图片保存起来
    request.urlretrieve(bg_img_src, "background.png")

    # 基于图鉴平台实现计算滑动距离
    distance = getImgCodeText('background.png', 33)
    distance = int(distance)
    print('距离:', distance)

    # 定位到滑块标签
    slide = page.locator('//*[@id="JDJRV-wrap-loginsubmit"]/div/div/div/div[2]/div[3]')

    # 找到滑块在当前页面的坐标(这个会返回一个字典里边四个数字)
    # {'x': 123, 'y': 1213, 'width': 12, 'height': 12}
    box = slide.bounding_box()

    # 让鼠标移动到滑块标签的中间上
    page.mouse.move(box["x"] + box["width"] / 2, box["y"] + box["height"] / 2)
    # 按下鼠标
    page.mouse.down()
    # 滑块最左边的位置,由于会有误差,因此需要调整后面的数值
    x = box["x"] + 24
    # 滑动的长度放到轨迹加工一下得到一个轨迹
    tracks = get_track(distance)
    for track in tracks:
        # 循环鼠标按照轨迹移动
        page.mouse.move(x + track, 0)
        x += track
    # 移动结束鼠标释放
    page.mouse.up()

    page.wait_for_timeout(5000)
    page.close()
    bro.close()
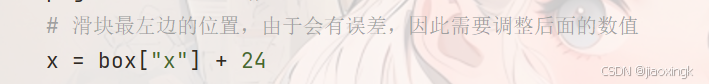
最重要的是,由于有误差,并不能百分百成功,需要微调这里的数值: