从零开始创建大语言模型(Python/pytorch )(三):编码注意力机制
- [3 编码注意力机制](#3 编码注意力机制)
-
- [3.1 建模长序列的问题](#3.1 建模长序列的问题)
- [3.2 使用注意力机制捕捉数据依赖关系](#3.2 使用注意力机制捕捉数据依赖关系)
- [3.3 通过自注意力关注输入的不同部分](#3.3 通过自注意力关注输入的不同部分)
-
- [3.3.1 一个没有可训练权重的简化自注意力机制](#3.3.1 一个没有可训练权重的简化自注意力机制)
- [3.3.2 为所有输入token计算注意力权重](#3.3.2 为所有输入token计算注意力权重)
- [3.4 实现带有可训练权重的自注意力机制](#3.4 实现带有可训练权重的自注意力机制)
-
- [3.4.1 逐步计算注意力权重](#3.4.1 逐步计算注意力权重)
- [3.4.2 实现一个简洁的自注意力 Python 类](#3.4.2 实现一个简洁的自注意力 Python 类)
- [3.5 使用因果注意力隐藏未来词](#3.5 使用因果注意力隐藏未来词)
-
- [3.5.1 应用因果注意力掩码](#3.5.1 应用因果注意力掩码)
- [3.5.2 使用dropout对额外的注意力权重进行掩码](#3.5.2 使用dropout对额外的注意力权重进行掩码)
- [3.5.3 实现一个简洁的因果注意力类](#3.5.3 实现一个简洁的因果注意力类)
- [3.6 从单头注意力扩展到多头注意力](#3.6 从单头注意力扩展到多头注意力)
-
- [3.6.1 堆叠多个单头注意力层](#3.6.1 堆叠多个单头注意力层)
- [3.6.2 使用权重切分实现多头注意力](#3.6.2 使用权重切分实现多头注意力)
- [3.7 小结](#3.7 小结)
3 编码注意力机制
本章内容包括:
- 探索在神经网络中使用注意力机制的原因
- 介绍一个基本的自注意力框架,并逐步过渡到增强型自注意力机制
- 实现一个因果注意力模块,使得LLM能够一次生成一个token
- 使用dropout随机屏蔽部分注意力权重以减少过拟合
- 将多个因果注意力模块堆叠成一个多头注意力模块
在上一章中,你学习了如何为训练LLM准备输入文本。这包括将文本划分为单词和子词的token,这些token可以被编码为向量表示,即所谓的嵌入(embeddings),供LLM使用。
在本章中,我们将探讨LLM架构中的一个核心部分------注意力机制,如图3.1所示。
 图3.1 对LLM编码的三个主要阶段的思维模型:在通用文本数据集上对LLM进行预训练,然后在有标签数据集上进行微调。本章重点介绍注意力机制,它是LLM架构的一个核心组成部分。
注意力机制是一个内容广泛的主题,这也是我们将整整一章专门用于它的原因。我们将在很大程度上将这些注意力机制单独进行考察,并从机制层面进行深入探讨。在下一章中,我们将编写围绕自注意力机制的LLM其余部分的代码,以便看到它的实际运作,并创建一个用于生成文本的模型。
在本章的过程中,我们将实现四种不同变体的注意力机制,如图3.2所示。
 图3.2 本图展示了我们将在本章中编写的不同注意力机制。从一个简化版本的自注意力开始,然后逐步加入可训练权重。因果注意力机制在自注意力的基础上添加了一个掩码,使得LLM能够一次生成一个词。最后,多头注意力将注意力机制组织为多个头,从而使模型能够并行捕捉输入数据的多个方面。
3.1 建模长序列的问题
在本章稍后我们深入探讨LLM核心的自注意力机制之前,先来看一看:在没有注意力机制、早于LLM的架构中,存在什么问题?假设我们要开发一个语言翻译模型,用于将文本从一种语言翻译为另一种语言。如图3.3所示,我们不能仅仅逐词翻译文本,因为源语言和目标语言之间的语法结构不同。
 图3.3 当将文本从一种语言翻译为另一种语言(例如从德语翻译为英语)时,无法仅仅逐词翻译。相反,翻译过程需要------
为了解决不能逐词翻译的问题,通常会使用一个包含两个子模块的深度神经网络,即所谓的 编码器-解码器(encoder-decoder) 结构。编码器的任务是首先读入并处理整个文本,然后解码器生成翻译后的文本。
我们已经在第1章(第1.4节:将LLM用于不同任务)介绍Transformer架构时简要讨论过编码器-解码器网络。在Transformer出现之前,循环神经网络(RNN)是语言翻译中最常见的编码器-解码器架构。
RNN是一种神经网络,其前一步的输出被作为当前步骤的输入,这使得它非常适合处理文本等序列数据。如果你不熟悉RNN,不用担心,你不需要了解RNN的详细工作原理就能理解我们接下来的讨论;我们在这里更关注编码器-解码器结构的一般概念。
在编码器-解码器RNN中,输入文本被送入编码器,编码器按顺序对其进行处理。编码器在每一步都会更新其隐藏状态(即隐藏层中的内部数值),并试图在最终的隐藏状态中捕捉整个输入句子的含义,如图3.4所示。随后,解码器使用这个最终的隐藏状态开始逐词生成翻译后的句子。解码器也会在每一步更新其隐藏状态,该隐藏状态被认为包含了下一词预测所需的上下文信息。
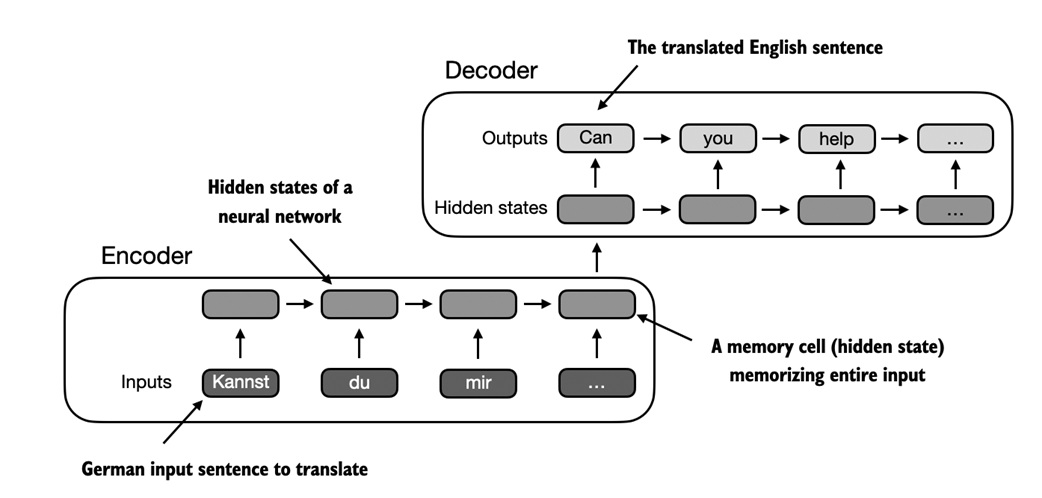 图3.4 在Transformer模型出现之前,编码器-解码器RNN是机器翻译中的一种流行选择。编码器将源语言中的一系列token作为输入,编码器的隐藏状态(即神经网络的中间层)编码了整个输入序列的压缩表示。然后,解码器利用其当前的隐藏状态开始逐个token地进行翻译。
虽然我们不需要了解这些编码器-解码器RNN的内部工作机制,但这里的关键思想是:编码器部分将整个输入文本处理为一个隐藏状态(记忆单元)。然后,解码器接收这个隐藏状态来生成输出。你可以将这个隐藏状态看作一个嵌入向量(embedding vector),这是我们在第2章中讨论过的概念。
编码器-解码器RNN的主要问题和局限在于:在解码阶段,RNN无法直接访问编码器的早期隐藏状态。因此,它只能依赖当前的隐藏状态,而这个状态封装了所有相关的信息。这可能导致上下文信息的丢失,特别是在那些依赖关系跨越很长距离的复杂句子中。
对于不熟悉RNN的读者来说,不必理解或学习这一架构,因为本书不会使用它。本节的核心信息是:编码器-解码器RNN存在一个缺陷,这个缺陷促使人们设计了注意力机制。
3.2 使用注意力机制捕捉数据依赖关系
在Transformer LLM出现之前,如前所述,通常使用RNN来处理语言建模任务,例如语言翻译。RNN在翻译短句时表现良好,但在处理较长文本时效果不佳,因为它们无法直接访问输入中的先前词语。
这种方法的一个主要缺点是:RNN必须在将编码信息传递给解码器之前,将整个输入编码为一个单一的隐藏状态,如上一节图3.4所示。
因此,研究人员在2014年为RNN开发了所谓的Bahdanau注意力机制(以相关论文的第一作者命名),该机制对编码器-解码器RNN进行修改,使得解码器在每一步解码时可以选择性地访问输入序列中的不同部分,如图3.5所示。
 图3.5 通过使用注意力机制,网络中生成文本的解码器部分可以选择性地访问所有输入token。这意味着,对于生成某个输出token而言,一些输入token比其他的更重要。其重要性由所谓的 注意力权重(attention weights) 决定,我们将在后文中计算它们。请注意,此图展示的是注意力机制的一般思想,并未呈现Bahdanau机制的具体实现,后者是一种超出本书范围的RNN方法。
有趣的是,仅仅三年之后,研究人员发现构建用于自然语言处理的深度神经网络并不需要RNN架构,并提出了原始的Transformer架构(在第1章中已讨论),该架构中的自注意力机制(self-attention) 受Bahdanau注意力机制的启发。
自注意力是一种机制,在计算序列的表示时,它允许输入序列中的每个位置关注同一序列中的所有位置。自注意力是以Transformer架构为基础的当代LLM(如GPT系列)的关键组成部分。
本章将重点编写和理解GPT类模型中使用的这个自注意力机制,如图3.6所示。在下一章中,我们将编写LLM的其余部分。
 图3.6 自注意力是Transformer中的一种机制,它通过允许序列中的每个位置与同一序列中的所有其他位置进行交互并评估其重要性,从而计算出更高效的输入表示。在本章中,我们将从零开始编写这个自注意力机制,然后在下一章中编写GPT类LLM的其余部分。
3.3 通过自注意力关注输入的不同部分
我们现在将深入探讨自注意力机制的内部工作原理,并学习如何从零开始编写它。自注意力机制是基于Transformer架构的所有LLM的基石。值得注意的是,这一主题可能需要你付出相当多的专注力(无意双关),但一旦你掌握了其基本原理,就相当于征服了本书中最难的部分之一,也是实现LLM过程中最具挑战性的部分之一。
自注意力中的"自"
在自注意力机制中,"自"指的是该机制通过关联单个输入序列中的不同位置来自行计算注意力权重的能力。它能够评估并学习输入自身各部分之间的关系和依赖,例如一句话中的词语之间的关系,或者一幅图像中像素之间的关系。这一点不同于传统的注意力机制,后者通常关注的是两个不同序列之间元素的关系,例如在序列到序列(sequence-to-sequence)模型中,注意力可能是在输入序列与输出序列之间建立联系,就像图3.5所展示的例子那样。
由于自注意力机制在初次接触时可能显得复杂,我们将从下一小节开始介绍一个简化版本的自注意力机制。之后,在第3.4节中,我们将实现带有可训练权重的自注意力机制,这也是LLM中实际使用的版本。
3.3.1 一个没有可训练权重的简化自注意力机制
在本节中,我们将实现一个不含任何可训练权重的简化版本的自注意力机制,该机制在图3.7中进行了概括。本节的目标是在引入可训练权重(第3.4节)之前,先阐明自注意力中的几个关键概念。
 图3.7 自注意力机制的目标是为每个输入元素计算一个上下文向量,该向量结合了来自所有其他输入元素的信息。在本图所示的示例中,我们计算的是上下文向量 z ( 2 ) z^{(2)} z(2)。每个输入元素在计算 z ( 2 ) z^{(2)} z(2)时的重要性或贡献程度由注意力权重 α 21 \alpha_{21} α21到 α 2 T \alpha_{2T} α2T决定。在计算 z ( 2 ) z^{(2)} z(2)时,注意力权重是相对于输入元素 x ( 2 ) x^{(2)} x(2)和所有其他输入元素来计算的。这些注意力权重的具体计算方式将在本节后文中进行讨论。
图3.7展示了一个输入序列,记作 x x x,由 T T T个元素组成,表示为 x ( 1 ) x^{(1)} x(1)到 x ( T ) x^{(T)} x(T)。这个序列通常表示一段文本,例如一个句子,并已经被转换为token嵌入,如第2章所解释的那样。
例如,考虑如下输入文本:"Your journey starts with one step." 在这种情况下,序列中的每个元素,例如 x ( 1 ) x^{(1)} x(1),对应一个 d d d维的嵌入向量,表示某个特定的token,比如"Your"。在图3.7中,这些输入向量被表示为三维嵌入。
在自注意力机制中,我们的目标是为输入序列中的每个元素 x ( i ) x^{(i)} x(i)计算上下文向量 z ( i ) z^{(i)} z(i)。上下文向量可以理解为一种增强后的嵌入向量。
为了说明这个概念,我们聚焦于第二个输入元素 x ( 2 ) x^{(2)} x(2)(它对应token"journey")的嵌入向量,以及图3.7底部所示的对应上下文向量 z ( 2 ) z^{(2)} z(2)。这个增强后的上下文向量 z ( 2 ) z^{(2)} z(2)是一个包含了 x ( 2 ) x^{(2)} x(2)以及所有其他输入元素 x ( 1 ) x^{(1)} x(1)到 x ( T ) x^{(T)} x(T)信息的嵌入。
在自注意力机制中,上下文向量发挥着至关重要的作用。它们的目的是通过整合序列中所有其他元素的信息,为输入序列(如一个句子)中的每个元素创建增强表示,如图3.7所示。这在LLM中至关重要,因为LLM需要理解句子中各个词语之间的关系与相关性。稍后,我们将引入可训练的权重,帮助LLM学习如何构造这些上下文向量,使其对于生成下一个token而言是有意义的。
在本节中,我们将实现一个简化版的自注意力机制,逐步计算这些权重和对应的上下文向量。
考虑如下输入句子,它已经按照第2章所讨论的方法被嵌入为三维向量。我们选择一个较小的嵌入维度进行示例,以确保内容能在页面中展示而不换行:
python
from importlib.metadata import version

print("torch version:", version("torch"))


import torch

inputs = torch.tensor(
  [[0.43, 0.15, 0.89], # Your     (x^1)
   [0.55, 0.87, 0.66], # journey  (x^2)
   [0.57, 0.85, 0.64], # starts   (x^3)
   [0.22, 0.58, 0.33], # with     (x^4)
   [0.77, 0.25, 0.10], # one      (x^5)
   [0.05, 0.80, 0.55]] # step     (x^6)
)
实现自注意力机制的第一步是计算中间值 ω \omega ω,也称为注意力分数(attention scores),如图3.8所示。

图3.8 本节的总体目标是说明如何使用第二个输入序列 x ( 2 ) x^{(2)} x(2)作为查询(query)来计算上下文向量 z ( 2 ) z^{(2)} z(2)。此图展示了第一个中间步骤,即通过点积计算查询 x ( 2 ) x^{(2)} x(2)与所有其他输入元素之间的注意力分数 ω \omega ω。(注意:图中的数值被截断为小数点后一位,以减少视觉干扰。)
python
query = inputs[1]  # 2nd input token is the query

attn_scores_2 = torch.empty(inputs.shape[0])
for i, x_i in enumerate(inputs):
    attn_scores_2[i] = torch.dot(x_i, query) # dot product (transpose not necessary here since they are 1-dim vectors)

print(attn_scores_2)tensor([0.9544, 1.4950, 1.4754, 0.8434, 0.7070, 1.0865])理解点积运算
点积本质上是一种将两个向量按元素相乘后再将乘积求和的简洁方式,我们可以通过以下方式进行演示:
python
res = 0.

for idx, element in enumerate(inputs[0]):
    res += inputs[0][idx] * query[idx]

print(res)
print(torch.dot(inputs[0], query))
输出结果表明,逐元素相乘后求和与点积的结果是相同的:
tensor(0.9544)
tensor(0.9544)除了将点积视为一种将两个向量组合为一个标量的数学工具之外,点积也是一种相似度的度量方式,因为它量化了两个向量之间的对齐程度:点积越大,表示这两个向量越相似或越对齐。在自注意力机制的背景下,点积决定了序列中各元素彼此关注的程度:点积越大,表示两个元素之间的相似度越高,注意力分数也越高。
在下一步中,如图3.9所示,我们将对前面计算出的注意力分数进行归一化处理。

图3.9 在计算了关于输入查询 x ( 2 ) x^{(2)} x(2)的注意力分数 ω 21 \omega_{21} ω21到 ω 2 T \omega_{2T} ω2T之后,下一步是通过归一化这些注意力分数,得到注意力权重 α 21 \alpha_{21} α21到 α 2 T \alpha_{2T} α2T。
图3.9中所示的归一化操作的主要目标是获得注意力权重,这些权重的总和为1。这种归一化是一种约定,它有助于解释模型的行为,并在LLM的训练中保持稳定性。
以下是实现这一归一化步骤的一个简单方法:
python
attn_weights_2_tmp = attn_scores_2 / attn_scores_2.sum()

print("Attention weights:", attn_weights_2_tmp)
print("Sum:", attn_weights_2_tmp.sum())
如输出所示,注意力权重的总和现在为1:
Attention weights: tensor([0.1455, 0.2278, 0.2249, 0.1285, 0.1077, 0.1656])
Sum: tensor(1.0000)在实践中,更常见且更推荐的做法是使用softmax函数进行归一化。这种方法在处理极端数值时效果更好,并在训练过程中具有更优的梯度性质。下面是一个用于归一化注意力分数的softmax函数的基础实现:
python
def softmax_naive(x):
    return torch.exp(x) / torch.exp(x).sum(dim=0)

attn_weights_2_naive = softmax_naive(attn_scores_2)

print("Attention weights:", attn_weights_2_naive)
print("Sum:", attn_weights_2_naive.sum())
如输出所示,softmax函数同样实现了目标,并将注意力权重归一化为总和为1:
Attention weights: tensor([0.1385, 0.2379, 0.2333, 0.1240, 0.1082, 0.1581])
Sum: tensor(1.)此外,softmax函数还能确保所有注意力权重始终为正数。这使得输出可以被解释为概率或相对重要性,权重越高表示该输入越重要。
需要注意的是,这个朴素的softmax实现(softmax_naive)在处理很大或很小的输入值时可能会遇到数值不稳定的问题,例如上溢和下溢。因此,在实际应用中,建议使用PyTorch优化过的softmax实现,该实现经过广泛优化以提高性能:
python
attn_weights_2 = torch.softmax(attn_scores_2, dim=0)

print("Attention weights:", attn_weights_2)
print("Sum:", attn_weights_2.sum())在这种情况下,我们可以看到它与之前的softmax_naive函数给出了相同的结果:
Attention weights: tensor([0.1385, 0.2379, 0.2333, 0.1240, 0.1082, 0.1581])
Sum: tensor(1.)
现在我们已经计算出了归一化后的注意力权重,接下来就可以进行图3.10所示的最后一步:通过将嵌入的输入token x ( i ) x^{(i)} x(i)与相应的注意力权重相乘,然后对结果向量求和,来计算上下文向量 z ( 2 ) z^{(2)} z(2)。
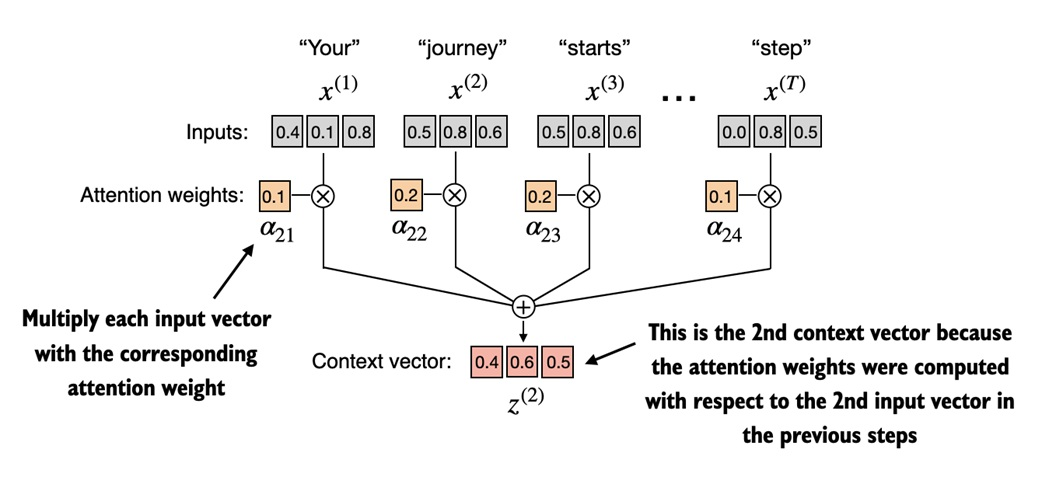
图3.10 在计算并归一化注意力分数以获得关于查询 x ( 2 ) x^{(2)} x(2)的注意力权重后,最后一步是计算上下文向量 z ( 2 ) z^{(2)} z(2)。这个上下文向量是所有输入向量 x ( 1 ) x^{(1)} x(1)到 x ( T ) x^{(T)} x(T)的加权组合,其中权重即为注意力权重。
图3.10所示的上下文向量 z ( 2 ) z^{(2)} z(2)是通过对所有输入向量进行加权求和计算得到的。这一过程包括将每个输入向量与其对应的注意力权重相乘:
python
query = inputs[1] # 2nd input token is the query

context_vec_2 = torch.zeros(query.shape)
for i,x_i in enumerate(inputs):
    context_vec_2 += attn_weights_2[i]*x_i

print(context_vec_2)
该计算的结果如下所示:
tensor([0.4419, 0.6515, 0.5683])在下一节中,我们将对这一用于计算上下文向量的过程进行泛化 ,以便同时计算所有上下文向量。
3.3.2 为所有输入token计算注意力权重
在上一节中,我们计算了输入2的注意力权重和上下文向量,如图3.11中高亮显示的行所示。现在,我们将扩展这一计算,来为所有输入计算注意力权重和上下文向量。
 图3.11 高亮的那一行表示以第二个输入元素作为查询时的注意力权重,这是我们在上一节中计算的内容。本节将对该计算过程进行泛化,以获得所有其他的注意力权重。
我们遵循与之前相同的三个步骤,如图3.12所总结的那样,唯一的不同是在代码中做了一些修改,以便计算所有上下文向量 ,而不仅仅是第二个上下文向量 z ( 2 ) z^{(2)} z(2)。
 图3.12
首先,在图3.12所示的步骤1中,我们添加了一个额外的for循环,用于计算所有输入对之间的点积:
python
attn_scores = torch.empty(6, 6)

for i, x_i in enumerate(inputs):
    for j, x_j in enumerate(inputs):
        attn_scores[i, j] = torch.dot(x_i, x_j)

print(attn_scores)
得到的注意力分数如下:
tensor([[0.9995, 0.9544, 0.9422, 0.4753, 0.4576, 0.6310],
        [0.9544, 1.4950, 1.4754, 0.8434, 0.7070, 1.0865],
        [0.9422, 1.4754, 1.4570, 0.8296, 0.7154, 1.0605],
        [0.4753, 0.8434, 0.8296, 0.4937, 0.3474, 0.6565],
        [0.4576, 0.7070, 0.7154, 0.3474, 0.6654, 0.2935],
        [0.6310, 1.0865, 1.0605, 0.6565, 0.2935, 0.9450]])
上述张量中的每个元素表示每一对输入之间的注意力分数,如图3.11所示。请注意,图3.11中的值是归一化后的,因此与上述未归一化的注意力分数不同。我们将在之后处理归一化问题。
在计算上述注意力分数张量时,我们使用了Python的for循环。然而,for循环通常较慢,我们可以使用矩阵乘法来实现相同的结果:
python
attn_scores = inputs @ inputs.T
print(attn_scores)
我们可以直观地验证结果与之前相同:
tensor([[0.9995, 0.9544, 0.9422, 0.4753, 0.4576, 0.6310],
        [0.9544, 1.4950, 1.4754, 0.8434, 0.7070, 1.0865],
        [0.9422, 1.4754, 1.4570, 0.8296, 0.7154, 1.0605],
        [0.4753, 0.8434, 0.8296, 0.4937, 0.3474, 0.6565],
        [0.4576, 0.7070, 0.7154, 0.3474, 0.6654, 0.2935],
[0.6310, 1.0865, 1.0605, 0.6565, 0.2935, 0.9450]])在步骤2中,如图3.12所示,我们现在对每一行进行归一化,使得每一行的值之和为1:
python
attn_weights = torch.softmax(attn_scores, dim=-1)
print(attn_weights)
这将返回如下注意力权重张量,其值与图3.10中所示相符:
tensor([[0.2098, 0.2006, 0.1981, 0.1242, 0.1220, 0.1452],
        [0.1385, 0.2379, 0.2333, 0.1240, 0.1082, 0.1581],
        [0.1390, 0.2369, 0.2326, 0.1242, 0.1108, 0.1565],
        [0.1435, 0.2074, 0.2046, 0.1462, 0.1263, 0.1720],
        [0.1526, 0.1958, 0.1975, 0.1367, 0.1879, 0.1295],
[0.1385, 0.2184, 0.2128, 0.1420, 0.0988, 0.1896]])在进入图3.12所示的步骤3之前,我们可以快速验证每一行的确都归一化为1:
python
row_2_sum = sum([0.1385, 0.2379, 0.2333, 0.1240, 0.1082, 0.1581])
print("Row 2 sum:", row_2_sum)

print("All row sums:", attn_weights.sum(dim=-1))
结果如下:
Row 2 sum: 1.0
All row sums: tensor([1.0000, 1.0000, 1.0000, 1.0000, 1.0000, 1.0000])
在第三步也是最后一步中,我们现在使用这些注意力权重通过矩阵乘法来计算所有上下文向量:
python
all_context_vecs = attn_weights @ inputs
print(all_context_vecs)
在得到的输出张量中,每一行表示一个三维的上下文向量:
tensor([[0.4421, 0.5931, 0.5790],
        [0.4419, 0.6515, 0.5683],
        [0.4431, 0.6496, 0.5671],
        [0.4304, 0.6298, 0.5510],
        [0.4671, 0.5910, 0.5266],
        [0.4177, 0.6503, 0.5645]])
我们可以再次检查代码是否正确,通过将第二行与我们在第3.3.1节中计算的上下文向量 z ( 2 ) z^{(2)} z(2)进行比较:
python
print("Previous 2nd context vector:", context_vec_2)根据结果,我们可以看到之前计算的context_vec_2与上面张量中的第二行完全一致:
Previous 2nd context vector: tensor([0.4419, 0.6515, 0.5683])这就完成了对一个简单自注意力机制的代码讲解。
在下一节中,我们将引入可训练权重,使LLM能够通过数据学习,从而提升其在特定任务上的表现。
3.4 实现带有可训练权重的自注意力机制
在本节中,我们将实现自注意力机制,它被用于原始的Transformer架构、GPT模型以及大多数流行的LLM中。这种自注意力机制也被称为缩放点积注意力(scaled dot-product attention)。图3.13提供了一个思维模型,用以说明该自注意力机制如何融入实现LLM的整体背景中。
 图3.13 该思维模型展示了我们在本节中所编写的自注意力机制在本书和本章更广泛内容中的位置。在上一节中,我们编写了一个简化的注意力机制,以理解注意力机制背后的基本原理。而在本节中,我们将在该注意力机制中加入可训练权重 。在接下来的各节中,我们将通过添加因果掩码 和多头机制进一步扩展这一自注意力机制。
如图3.13所示,带有可训练权重的自注意力机制建立在之前的概念基础之上:我们希望为特定的输入元素,计算其上下文向量,即对输入向量的加权求和。正如你将看到的,这一机制与我们在第3.3节中编写的基础自注意力机制相比,只有一些细微的区别。
最显著的区别是引入了在模型训练过程中不断更新的权重矩阵。这些可训练的权重矩阵至关重要,因为它们使得模型(具体来说是模型内部的注意力模块)能够学习如何生成"优质"的上下文向量。(请注意,我们将在第5章中对LLM进行训练。)
我们将通过两个子小节来处理这个自注意力机制。首先,我们将像以前一样逐步编写 其实现代码。其次,我们会将代码组织成一个简洁的Python类,可以将其导入到LLM架构中,而这个架构将在第4章中实现。
3.4.1 逐步计算注意力权重
我们将通过引入三个可训练的权重矩阵 W q W_q Wq、 W k W_k Wk和 W v W_v Wv,逐步实现自注意力机制。这三个矩阵用于将嵌入后的输入token x ( i ) x^{(i)} x(i)投影为查询向量(query) 、键向量(key)和值向量(value),如图3.14所示。
 图3.14 在带有可训练权重矩阵的自注意力机制的第一步中,我们为输入元素 x x x计算查询( q q q)、键( k k k)和值( v v v)向量。与前几节类似,我们将第二个输入 x ( 2 ) x^{(2)} x(2)指定为查询输入。查询向量 q ( 2 ) q^{(2)} q(2)是通过输入 x ( 2 ) x^{(2)} x(2)与权重矩阵 W q W_q Wq进行矩阵乘法得到的。同样地,键向量和值向量分别通过与权重矩阵 W k W_k Wk和 W v W_v Wv进行矩阵乘法得到。
在第3.3.1节中,我们将第二个输入元素 x ( 2 ) x^{(2)} x(2)定义为查询(query),用于计算简化的注意力权重以求得上下文向量 z ( 2 ) z^{(2)} z(2)。随后在第3.3.2节中,我们对这个过程进行了泛化,从而计算出六词输入句子 "Your journey starts with one step." 的所有上下文向量 z ( 1 ) z^{(1)} z(1) 到 z ( T ) z^{(T)} z(T)。
类似地,这里我们也将从计算一个上下文向量 z ( 2 ) z^{(2)} z(2)开始进行说明。在下一节中,我们将修改这段代码以计算所有的上下文向量。
我们首先定义几个变量:
python
x_2 = inputs[1] # A second input element
d_in = inputs.shape[1] # B the input embedding size, d=3
d_out = 2 # C the output embedding size, d=2
请注意,在GPT类模型中,输入维度和输出维度通常是相同的。但为了更清晰地说明计算过程,这里我们选择不同的输入维度( d i n = 3 d_{in}=3 din=3)和输出维度( d o u t = 2 d_{out}=2 dout=2)。
接下来,我们初始化图3.14中展示的三个权重矩阵 W q W_q Wq、 W k W_k Wk和 W v W_v Wv:
python
torch.manual_seed(123)

W_query = torch.nn.Parameter(torch.rand(d_in, d_out), requires_grad=False)
W_key   = torch.nn.Parameter(torch.rand(d_in, d_out), requires_grad=False)
W_value = torch.nn.Parameter(torch.rand(d_in, d_out), requires_grad=False)请注意,这里我们将requires_grad=False,是为了在输出中减少干扰,便于演示。但如果我们希望使用这些权重矩阵进行模型训练,就应将requires_grad=True,以便在训练过程中更新这些矩阵。
然后我们根据图3.14的说明,计算查询(query)、键(key)和值(value)向量:
python
query_2 = x_2 @ W_query # _2 because it's with respect to the 2nd input element
key_2 = x_2 @ W_key
value_2 = x_2 @ W_value

print(query_2)
print(key_2)
print(value_2)
如输出所示,查询向量是一个二维向量,因为我们通过 d o u t = 2 d_{out}=2 dout=2设置了对应权重矩阵的列数为2:
tensor([0.4306, 1.4551])
tensor([0.4433, 1.1419])
tensor([0.3951, 1.0037])
权重参数 vs 注意力权重
请注意,权重矩阵 W W W中的"权重"一词是"权重参数(weight parameters)"的缩写,指的是神经网络中在训练期间被优化的值。这一点不要与注意力权重(attention weights)混淆。正如我们在前一节中看到的,注意力权重决定了上下文向量在多大程度上依赖输入中的不同部分,也就是说,网络关注输入各部分的程度。
总结来说,权重参数是神经网络中定义连接关系的基础可学习系数 ,而注意力权重是动态的、依赖上下文的值。
尽管我们当前的目标是仅计算一个上下文向量 z ( 2 ) z^{(2)} z(2),我们仍然需要所有输入元素的key和value向量,因为它们在根据查询 q ( 2 ) q^{(2)} q(2)计算注意力权重时是必要的,如图3.14所示。
我们可以通过矩阵乘法获得所有的key和value:
python
keys = inputs @ W_key
values = inputs @ W_value

print("keys.shape:", keys.shape)
print("values.shape:", values.shape)
从输出中可以看出,我们成功地将6个输入token从三维嵌入空间投影到了二维嵌入空间:
keys.shape: torch.Size([6, 2])
values.shape: torch.Size([6, 2])
接下来的第二步是计算注意力分数,如图3.15所示。
 图3.15 注意力分数的计算是点积计算,和我们在第3.3节中使用的简化自注意力机制类似。这里的新特点在于,我们不再直接对输入元素进行点积运算,而是使用通过权重矩阵变换得到的查询和键(query和key)来进行计算。
首先,我们计算注意力分数 ω 22 \omega_{22} ω22:
python
keys_2 = keys[1] # A Python starts index at 0
attn_score_22 = query_2.dot(keys_2)
print(attn_score_22)
输出结果是未归一化的注意力分数:
tensor(1.8524)同样地,我们可以通过矩阵乘法将该计算泛化为所有注意力分数的计算:
python
attn_scores_2 = query_2 @ keys.T  # 所有针对给定查询的注意力分数
print(attn_scores_2)
我们可以快速验证:输出中的第二个元素与我们之前计算的 ω 22 \omega_{22} ω22一致:
tensor([1.2705, 1.8524, 1.8111, 1.0795, 0.5577, 1.5440])接下来的第三步是将注意力分数转换为注意力权重,如图3.16所示。
 图3.16 在计算出注意力分数 ω \omega ω之后,下一步是使用softmax函数对这些分数进行归一化,从而得到注意力权重 α \alpha α。
接下来,如图3.16所示,我们通过缩放注意力分数并使用之前介绍的softmax函数来计算注意力权重。
与之前不同的是,我们现在将注意力分数除以键向量嵌入维度的平方根进行缩放(注意,开平方在数学上等价于乘方0.5):
python
d_k = keys.shape[1]
attn_weights_2 = torch.softmax(attn_scores_2 / d_k**0.5, dim=-1)
print(attn_weights_2)
得到的注意力权重如下所示:
tensor([0.1500, 0.2264, 0.2199, 0.1311, 0.0906, 0.1820])缩放点积注意力的原理
将注意力分数按嵌入维度进行归一化的原因是:通过避免梯度过小来提升训练效果。例如,当我们增加嵌入维度(在GPT类LLM中通常大于一千)时,较大的点积会在softmax函数作用下导致非常小的梯度。在点积变大时,softmax函数的行为会越来越像阶跃函数,进而使梯度趋近于0。这些微小的梯度可能严重减缓学习进程,甚至导致训练停滞。
用嵌入维度平方根进行缩放,正是这种自注意力机制被称为 缩放点积注意力(scaled-dot product attention) 的原因。
现在,最后一步是计算上下文向量,如图3.17所示。
 图3.17 在自注意力计算的最后一步,我们通过将所有值向量根据注意力权重进行加权组合,来计算上下文向量。
类似于第3.3节中我们将上下文向量计算为输入向量的加权和的做法,我们现在将上下文向量计算为**值向量(value vectors)**的加权和。在这里,注意力权重充当加权因子,用于衡量每个值向量的重要性。和第3.3节一样,我们可以使用矩阵乘法一步获得输出:
python
context_vec_2 = attn_weights_2 @ values
print(context_vec_2)
得到的向量内容如下:
tensor([0.3061, 0.8210])到目前为止,我们只计算了一个上下文向量 z ( 2 ) z^{(2)} z(2)。在下一节中,我们将对代码进行泛化,计算输入序列中所有的上下文向量 ,即 z ( 1 ) z^{(1)} z(1)到 z ( T ) z^{(T)} z(T)。
为什么要使用query、key和value?
在注意力机制中,术语"key"(键)、"query"(查询)和"value"(值)源自信息检索和数据库领域,在这些领域中有类似的概念被用于存储、搜索和检索信息。
"query"(查询)类似于数据库中的搜索查询。它表示当前模型关注或试图理解的元素(例如句子中的某个词或token)。查询用于探查输入序列中的其他部分,以确定对它们需要关注多少。
"key"(键)就像数据库中的索引键,用于查找和匹配。在注意力机制中,输入序列中的每一项(例如句子中的每个词)都有一个对应的key。这些key用于与query进行匹配。
"value"(值)在这里类似于数据库中键值对中的value。它表示输入项的实际内容或表示。当模型确定了哪些key(也就是输入中哪些部分)与query最相关之后,它就会检索出对应的value。
3.4.2 实现一个简洁的自注意力 Python 类
在前几节中,我们逐步完成了自注意力输出的计算。这主要是为了说明目的,以便我们能够一步一步地理解整个过程。而在实践中,特别是考虑到下一章即将实现的LLM,将这些代码组织成一个Python类会更加有用,代码如下:
代码清单 3.1 一个简洁的自注意力类
python
import torch.nn as nn

class SelfAttention_v1(nn.Module):

    def __init__(self, d_in, d_out):
        super().__init__()
        self.W_query = nn.Parameter(torch.rand(d_in, d_out))
        self.W_key   = nn.Parameter(torch.rand(d_in, d_out))
        self.W_value = nn.Parameter(torch.rand(d_in, d_out))

    def forward(self, x):
        keys = x @ self.W_key
        queries = x @ self.W_query
        values = x @ self.W_value

        attn_scores = queries @ keys.T # omega
        attn_weights = torch.softmax(
            attn_scores / keys.shape[-1]**0.5, dim=-1
        )

        context_vec = attn_weights @ values
return context_vec在这段PyTorch代码中,SelfAttention_v1 是继承自 nn.Module 的类,nn.Module 是PyTorch模型的基本构建模块,它提供了用于创建和管理模型层所需的功能。
__init__ 方法初始化了用于查询(query)、键(key)和值(value)的可训练权重矩阵( W q u e r y W_{query} Wquery、 W k e y W_{key} Wkey 和 W v a l u e W_{value} Wvalue),这些矩阵将输入维度 d i n d_{in} din变换为输出维度 d o u t d_{out} dout。
在前向传播阶段(即forward方法中),我们先通过查询和键计算注意力分数(attn_scores),然后通过softmax对这些分数进行归一化。最后,我们使用这些归一化后的注意力分数对值向量进行加权,生成上下文向量。
我们可以如下使用这个类:
python
torch.manual_seed(123)
sa_v1 = SelfAttention_v1(d_in, d_out)
print(sa_v1(inputs))由于inputs包含六个嵌入向量,因此输出是一个包含六个上下文向量的矩阵:
tensor([[0.2996, 0.8053],
        [0.3061, 0.8210],
        [0.3058, 0.8203],
        [0.2948, 0.7939],
        [0.2927, 0.7891],
[0.2990, 0.8040]], grad_fn=<MmBackward0>)可以快速验证:第二行([0.3061, 0.8210])与前一节中context_vec_2的内容一致。
图3.18总结了我们刚刚实现的自注意力机制。
 图3.18 在自注意力机制中,我们使用三个权重矩阵 W q W_q Wq、 W k W_k Wk和 W v W_v Wv对输入矩阵 X X X中的向量进行变换。然后,我们基于生成的查询 Q Q Q和键 K K K计算注意力权重矩阵。接着,结合注意力权重和值 V V V,我们计算出上下文向量 Z Z Z。(为了视觉清晰,图中聚焦于一个具有 n n n个token的单个输入文本,而不是一个包含多个输入的batch。因此,三维输入张量在此上下文中简化为二维矩阵。这种处理方式有助于更直观地可视化和理解相关过程。)
如图3.18所示,自注意力机制涉及三个可训练的权重矩阵 W q W_q Wq、 W k W_k Wk和 W v W_v Wv。这些矩阵将输入数据转换为查询(query)、键(key)和值(value),它们是注意力机制中的关键组成部分。随着模型在训练过程中接触到更多的数据,它会不断调整这些可训练权重,这一点我们将在后续章节中看到。
我们可以通过使用PyTorch的nn.Linear层来进一步改进SelfAttention_v1的实现。nn.Linear在禁用偏置项的情况下可以高效地执行矩阵乘法。此外,使用nn.Linear而不是手动实现nn.Parameter(torch.rand(...))的一个重要优势是,nn.Linear具备优化过的权重初始化策略,这有助于训练过程更加稳定和高效。
代码清单 3.2 使用 PyTorch 的 Linear 层实现自注意力类
python
class SelfAttention_v2(nn.Module):
    def __init__(self, d_in, d_out, qkv_bias=False):
        super().__init__()
        self.d_out = d_out
        self.W_query = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.W_key = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.W_value = nn.Linear(d_in, d_out, bias=qkv_bias)

    def forward(self, x):
        keys = self.W_key(x)
        queries = self.W_query(x)
        values = self.W_value(x)
        attn_scores = queries @ keys.T
        attn_weights = torch.softmax(attn_scores / keys.shape[-1]**0.5, dim=1)
        context_vec = attn_weights @ values
return context_vec你可以像使用SelfAttention_v1那样使用SelfAttention_v2:
python
torch.manual_seed(789)
sa_v2 = SelfAttention_v2(d_in, d_out)
print(sa_v2(inputs))
输出结果为:
tensor([[-0.0739,  0.0713],
        [-0.0748,  0.0703],
        [-0.0749,  0.0702],
        [-0.0760,  0.0685],
        [-0.0763,  0.0679],
[-0.0754, 0.0693]], grad_fn=<MmBackward0>)请注意,SelfAttention_v1和SelfAttention_v2的输出不同,因为它们使用了不同的初始权重。nn.Linear使用的是更加复杂的权重初始化方案。
练习 3.1 对比 SelfAttention_v1 和 SelfAttention_v2
请注意,SelfAttention_v2中的nn.Linear使用的权重初始化方式不同于SelfAttention_v1中使用的nn.Parameter(torch.rand(d_in, d_out))。这导致两种机制产生了不同的结果。
为了验证这两个实现除了初始化不同之外是等价的,我们可以将SelfAttention_v2对象中的权重矩阵转移到SelfAttention_v1对象中,这样两个对象就会输出相同的结果。
你的任务是:正确地将一个SelfAttention_v2实例中的权重赋值到一个SelfAttention_v1实例中 。为此,你需要理解两个版本中权重的存储方式之间的关系。(提示:nn.Linear中存储的权重矩阵是转置形式。)
完成赋值后,你应该可以观察到两个实例产生了相同的输出。
python
import torch

inputs = torch.tensor(
  [[0.43, 0.15, 0.89], # Your     (x^1)
   [0.55, 0.87, 0.66], # journey  (x^2)
   [0.57, 0.85, 0.64], # starts   (x^3)
   [0.22, 0.58, 0.33], # with     (x^4)
   [0.77, 0.25, 0.10], # one      (x^5)
   [0.05, 0.80, 0.55]] # step     (x^6)
)

d_in, d_out = 3, 2
import torch.nn as nn

class SelfAttention_v1(nn.Module):

    def __init__(self, d_in, d_out):
        super().__init__()
        self.d_out = d_out
        self.W_query = nn.Parameter(torch.rand(d_in, d_out))
        self.W_key   = nn.Parameter(torch.rand(d_in, d_out))
        self.W_value = nn.Parameter(torch.rand(d_in, d_out))

    def forward(self, x):
        keys = x @ self.W_key
        queries = x @ self.W_query
        values = x @ self.W_value

        attn_scores = queries @ keys.T # omega
        attn_weights = torch.softmax(attn_scores / keys.shape[-1]**0.5, dim=-1)

        context_vec = attn_weights @ values
        return context_vec

torch.manual_seed(123)
sa_v1 = SelfAttention_v1(d_in, d_out)
class SelfAttention_v2(nn.Module):

    def __init__(self, d_in, d_out):
        super().__init__()
        self.d_out = d_out
        self.W_query = nn.Linear(d_in, d_out, bias=False)
        self.W_key   = nn.Linear(d_in, d_out, bias=False)
        self.W_value = nn.Linear(d_in, d_out, bias=False)

    def forward(self, x):
        keys = self.W_key(x)
        queries = self.W_query(x)
        values = self.W_value(x)

        attn_scores = queries @ keys.T
        attn_weights = torch.softmax(attn_scores / keys.shape[-1]**0.5, dim=1)

        context_vec = attn_weights @ values
        return context_vec

torch.manual_seed(123)
sa_v2 = SelfAttention_v2(d_in, d_out)
sa_v1.W_query = torch.nn.Parameter(sa_v2.W_query.weight.T)
sa_v1.W_key = torch.nn.Parameter(sa_v2.W_key.weight.T)
sa_v1.W_value = torch.nn.Parameter(sa_v2.W_value.weight.T)
print(sa_v1(inputs))
print(sa_v2(inputs))tensor([[-0.5337, -0.1051],
[-0.5323, -0.1080],
[-0.5323, -0.1079],
[-0.5297, -0.1076],
[-0.5311, -0.1066],
[-0.5299, -0.1081]], grad_fn=<MmBackward0>)
tensor([[-0.5337, -0.1051],
[-0.5323, -0.1080],
[-0.5323, -0.1079],
[-0.5297, -0.1076],
[-0.5311, -0.1066],
[-0.5299, -0.1081]], grad_fn=<MmBackward0>)在下一节中,我们将对自注意力机制进行增强,重点添加因果性(causal)和多头机制(multi-head)。
"因果性"方面,涉及修改注意力机制,以防止模型在处理序列时访问未来的信息。这一点对于语言建模等任务至关重要,因为每一个词的预测应当只依赖于它之前的词。
"多头机制"方面,则是将注意力机制拆分为多个"头"。每一个头学习数据的不同方面,使得模型可以在不同的位置同时关注来自不同表示子空间的信息。这种机制能显著提升模型在复杂任务中的表现。
3.5 使用因果注意力隐藏未来词
在本节中,我们将对标准自注意力机制进行修改,构建出因果注意力机制(causal attention mechanism),这是在后续章节中开发LLM所必需的。
因果注意力 ,也被称为掩码注意力(masked attention) ,是一种特殊形式的自注意力机制。它限制模型在处理某个token时只能考虑该序列中当前位置及其之前的输入。这与标准的自注意力机制形成对比,后者允许一次性访问整个输入序列。
因此,在计算注意力分数时,因果注意力机制确保模型只考虑当前token及其之前出现的token。
为了在GPT类LLM中实现这一点,对于每一个被处理的token,我们会屏蔽掉位于当前token之后的所有未来token,如图3.19所示。
 图3.19 在因果注意力中,我们会屏蔽掉注意力权重矩阵中主对角线以上的部分,这样在计算上下文向量时,LLM就无法访问未来的token。例如,在第二行中的单词"journey",我们仅保留对当前位置("journey")及其之前位置("Your")的注意力权重。
如图3.19所示,我们屏蔽掉注意力权重矩阵中主对角线以上的部分,然后对未被屏蔽的注意力权重进行归一化,使得每一行的注意力权重之和为1。在下一节中,我们将通过代码实现这一掩码与归一化的过程。
3.5.1 应用因果注意力掩码
在本节中,我们将通过代码实现因果注意力掩码。我们从图3.20中总结的过程开始。
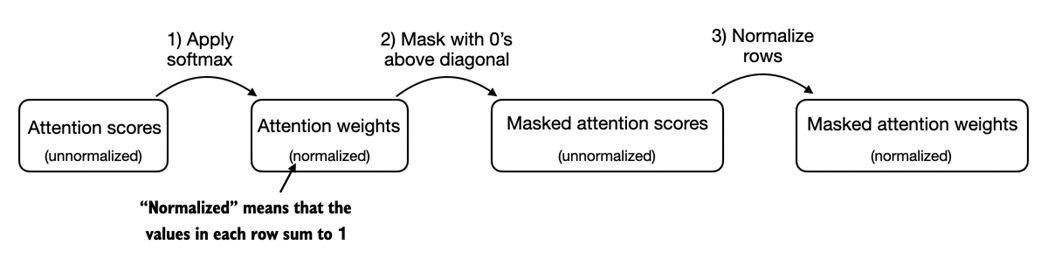 图3.20 在因果注意力中,获得被掩码的注意力权重矩阵的一种方法是:先对注意力分数应用softmax函数,屏蔽掉主对角线以上的元素(即将其置零),然后对结果矩阵进行归一化。
为了实现图3.20中总结的因果注意力掩码步骤,从而获得被掩码的注意力权重,我们将基于上一节的注意力分数和权重来编写因果注意力机制的代码。
在图3.20所示的第一步中,我们像之前几节那样使用softmax函数计算注意力权重:
python
# Reuse the query and key weight matrices of the
# SelfAttention_v2 object from the previous section for convenience
queries = sa_v2.W_query(inputs)
keys = sa_v2.W_key(inputs)
attn_scores = queries @ keys.T

attn_weights = torch.softmax(attn_scores / keys.shape[-1]**0.5, dim=-1)
print(attn_weights)
这会产生如下注意力权重:
tensor([[0.1921, 0.1646, 0.1652, 0.1550, 0.1721, 0.1510],
        [0.2041, 0.1659, 0.1662, 0.1496, 0.1665, 0.1477],
        [0.2036, 0.1659, 0.1662, 0.1498, 0.1664, 0.1480],
        [0.1869, 0.1667, 0.1668, 0.1571, 0.1661, 0.1564],
        [0.1830, 0.1669, 0.1670, 0.1588, 0.1658, 0.1585],
        [0.1935, 0.1663, 0.1666, 0.1542, 0.1666, 0.1529]],
grad_fn=<SoftmaxBackward0>)我们可以使用PyTorch的tril函数实现图3.20中的第二步 ,构造一个主对角线以上为零的掩码矩阵:
python
context_length = attn_scores.shape[0]
mask_simple = torch.tril(torch.ones(context_length, context_length))
print(mask_simple)
得到的掩码如下所示:
tensor([[1., 0., 0., 0., 0., 0.],
        [1., 1., 0., 0., 0., 0.],
        [1., 1., 1., 0., 0., 0.],
        [1., 1., 1., 1., 0., 0.],
        [1., 1., 1., 1., 1., 0.],
        [1., 1., 1., 1., 1., 1.]])
现在我们可以将这个掩码与注意力权重相乘,从而将主对角线以上的值置零:
python
masked_simple = attn_weights*mask_simple
print(masked_simple)
可以看到,主对角线以上的元素已经被成功置零:
tensor([[0.1921, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.2041, 0.1659, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.2036, 0.1659, 0.1662, 0.0000, 0.0000, 0.0000],
        [0.1869, 0.1667, 0.1668, 0.1571, 0.0000, 0.0000],
        [0.1830, 0.1669, 0.1670, 0.1588, 0.1658, 0.0000],
        [0.1935, 0.1663, 0.1666, 0.1542, 0.1666, 0.1529]],
grad_fn=<MulBackward0>)图3.20中的第三步是重新对每一行进行归一化,使得每一行的注意力权重之和为1。我们可以通过将每个元素除以其所在行的总和来实现:
python
row_sums = masked_simple.sum(dim=-1, keepdim=True)
masked_simple_norm = masked_simple / row_sums
print(masked_simple_norm)
最终结果是一个注意力权重矩阵,其中对角线以上的值被置零,并且每一行的总和为1:
tensor([[1.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.5517, 0.4483, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.3800, 0.3097, 0.3103, 0.0000, 0.0000, 0.0000],
        [0.2758, 0.2460, 0.2462, 0.2319, 0.0000, 0.0000],
        [0.2175, 0.1983, 0.1984, 0.1888, 0.1971, 0.0000],
        [0.1935, 0.1663, 0.1666, 0.1542, 0.1666, 0.1529]],
       grad_fn=<DivBackward0>)
信息泄露问题(Information leakage)
当我们应用掩码并重新归一化注意力权重时,可能初看起来会认为:未来token的信息(我们本意是要屏蔽的)仍然会影响当前token,因为它们的值本来是参与softmax计算的。
然而,关键在于:在掩码之后进行重新归一化时,实质上就是在一个更小的子集上重新计算softmax,因为被屏蔽的位置不会对softmax的值产生任何贡献。
softmax的数学优雅性在于:尽管一开始的分母中包含了所有位置,但在掩码与归一化之后,被屏蔽的位置在实际计算中完全不会起作用------它们不会以任何有意义的方式影响softmax得分。
换句话说,掩码与归一化之后,注意力权重的分布就好像一开始只在未被屏蔽的位置上计算一样。这确保了我们原本希望屏蔽的未来token的信息不会泄露。
尽管我们在技术上已经完成了因果注意力的实现,但我们还可以利用softmax函数的数学性质,用更少的步骤更高效地计算被掩码的注意力权重,如图3.21所示。
 图3.21 在因果注意力中,更高效的一种方式是:在应用softmax之前,将注意力分数中主对角线以上的位置设置为负无穷,从而实现掩码效果。
softmax函数会将其输入转换为一个概率分布。当某一行中存在负无穷( − ∞ -\infty −∞)时,softmax函数会将这些位置视为概率为0(在数学上,这是因为 e − ∞ e^{-\infty} e−∞趋近于0)。
我们可以通过一个更高效的掩码"技巧"来实现这一点:先创建一个主对角线以上全为1的掩码,然后将这些1替换为负无穷( − ∞ -\infty −∞)值:
python
mask = torch.triu(torch.ones(context_length, context_length), diagonal=1)
masked = attn_scores.masked_fill(mask.bool(), -torch.inf)
print(masked)
这将产生如下掩码后的注意力分数:
tensor([[0.2899,   -inf,   -inf,   -inf,   -inf,   -inf],
        [0.4656, 0.1723,   -inf,   -inf,   -inf,   -inf],
        [0.4594, 0.1703, 0.1731,   -inf,   -inf,   -inf],
        [0.2642, 0.1024, 0.1036, 0.0186,   -inf,   -inf],
        [0.2183, 0.0874, 0.0882, 0.0177, 0.0786,   -inf],
        [0.3408, 0.1270, 0.1290, 0.0198, 0.1290, 0.0078]],
       grad_fn=<MaskedFillBackward0>)
现在我们只需要对这些已掩码的结果应用softmax函数即可完成:
python
attn_weights = torch.softmax(masked / keys.shape[-1]**0.5, dim=-1)
print(attn_weights)
从输出可以看出,每一行的值之和为1,因此不需要进一步归一化处理:
tensor([[1.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.5517, 0.4483, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.3800, 0.3097, 0.3103, 0.0000, 0.0000, 0.0000],
        [0.2758, 0.2460, 0.2462, 0.2319, 0.0000, 0.0000],
        [0.2175, 0.1983, 0.1984, 0.1888, 0.1971, 0.0000],
        [0.1935, 0.1663, 0.1666, 0.1542, 0.1666, 0.1529]],
grad_fn=<SoftmaxBackward0>)现在,我们可以使用修改后的注意力权重通过如下方式计算上下文向量,就像在第3.4节中那样:context_vec = attn_weights @ values 不过,在下一节中,我们将先介绍对因果注意力机制的另一个小改进,该方法在训练LLM时对减少过拟合非常有帮助。
3.5.2 使用dropout对额外的注意力权重进行掩码
在深度学习中,dropout 是一种技术,它会在训练过程中随机忽略(即"丢弃")部分隐藏层单元。这种方法通过防止模型过度依赖特定的隐藏层单元集合,从而有助于避免过拟合 。需要强调的是,dropout只在训练时启用,在推理(测试)阶段是禁用的。
在Transformer架构中(包括GPT等模型),注意力机制中的dropout通常应用于两个具体位置:
- 在计算注意力分数之后;
- 或在将注意力权重应用于值向量之后。
在这里,我们将在计算完注意力权重之后应用dropout掩码,如图3.22所示,因为这在实践中是更常见的做法。
 图3.22 使用因果注意力掩码(左上角)之后,我们应用了一个额外的dropout掩码(右上角),以将更多的注意力权重置零,从而在训练过程中进一步降低过拟合的风险。
在下面的代码示例中,我们使用了50%的dropout率,这意味着将屏蔽掉一半的注意力权重。(在后面的章节中训练GPT模型时,我们将使用更低的dropout率,例如0.1或0.2。)
在以下代码中,我们首先将PyTorch的dropout实现应用于一个由全1组成的 6 × 6 6×6 6×6张量,以便进行说明:
python
torch.manual_seed(123)
dropout = torch.nn.Dropout(0.5) # A dropout rate of 50%
example = torch.ones(6, 6) # B create a matrix of ones

print(dropout(example))
可以看到,大约一半的值被置零了:
tensor([[2., 2., 2., 2., 2., 2.],
        [0., 2., 0., 0., 0., 0.],
        [0., 0., 2., 0., 2., 0.],
        [2., 2., 0., 0., 0., 2.],
        [2., 0., 0., 0., 0., 2.],
        [0., 2., 0., 0., 0., 0.]])
当我们以50%的dropout率将其应用于一个注意力权重矩阵时,矩阵中的一半元素会被随机设置为0。为了补偿有效元素的减少,剩余元素的值会被放大一个因子 1 / 0.5 = 2 1/0.5=2 1/0.5=2。这种缩放对于维持注意力权重的整体平衡非常关键,它可以确保注意力机制在训练和推理阶段的平均影响力保持一致。
现在,我们将dropout直接应用于注意力权重矩阵:
python
torch.manual_seed(123)
print(dropout(attn_weights))
结果是一个注意力权重矩阵,其中一些额外的元素被置为0,其余元素被缩放:
tensor([[2.0000, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.0000, 0.8966, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.0000, 0.0000, 0.6206, 0.0000, 0.0000, 0.0000],
        [0.5517, 0.4921, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.4350, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.0000, 0.3327, 0.0000, 0.0000, 0.0000, 0.0000]],
grad_fn=<MulBackward0>)请注意,由于不同操作系统的实现机制不同,最终的dropout输出可能会略有差异;你可以在这个PyTorch问题跟踪页面了解更多关于该不一致性的讨论。
在理解了因果注意力 和dropout掩码的工作原理之后,我们将在下一节中开发一个简洁的Python类,用于高效地结合并应用这两种技术。
3.5.3 实现一个简洁的因果注意力类
在本节中,我们将把因果注意力 和dropout机制 整合进第3.4节中开发的SelfAttention Python类中。该类将作为下一节开发多头注意力机制的模板,而多头注意力将是本章中我们实现的最后一个注意力模块。
但在开始之前,我们还需要确保代码能够处理包含多个输入的批量(batch) ,以便CausalAttention类可以兼容第2章中实现的数据加载器所产生的批量输出。
为简化起见,为了模拟这种批量输入,我们将输入文本示例复制两次:
python
batch = torch.stack((inputs, inputs), dim=0)
print(batch.shape) # 2 inputs with 6 tokens each, and each token has embedding dimension 3
这将生成一个三维张量,表示两个输入文本,每个文本有6个token,每个token是一个三维的嵌入向量:
torch.Size([2, 6, 3])下面的CausalAttention类与我们之前实现的SelfAttention类相似,不同之处在于我们添加了dropout机制 和因果掩码,这些改动在以下代码中已高亮显示:
代码清单 3.3:一个简洁的因果注意力类
python
class CausalAttention(nn.Module):

    def __init__(self, d_in, d_out, context_length,
                 dropout, qkv_bias=False):
        super().__init__()
        self.d_out = d_out
        self.W_query = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.W_key   = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.W_value = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.dropout = nn.Dropout(dropout) # New
        self.register_buffer('mask', torch.triu(torch.ones(context_length, context_length), diagonal=1)) # New

    def forward(self, x):
        b, num_tokens, d_in = x.shape # New batch dimension b
        # For inputs where `num_tokens` exceeds `context_length`, this will result in errors
        # in the mask creation further below.
        # In practice, this is not a problem since the LLM (chapters 4-7) ensures that inputs
        # do not exceed `context_length` before reaching this forward method.
        keys = self.W_key(x)
        queries = self.W_query(x)
        values = self.W_value(x)

        attn_scores = queries @ keys.transpose(1, 2) # Changed transpose
        attn_scores.masked_fill_(  # New, _ ops are in-place
            self.mask.bool()[:num_tokens, :num_tokens], -torch.inf)  # `:num_tokens` to account for cases where the number of tokens in the batch is smaller than the supported context_size
        attn_weights = torch.softmax(
            attn_scores / keys.shape[-1]**0.5, dim=-1
        )
        attn_weights = self.dropout(attn_weights) # New

        context_vec = attn_weights @ values
return context_vec虽然所有新增的代码行你应该都在前几节中见过,但这里我们新增了一个self.register_buffer()调用,这是在__init__方法中完成的。PyTorch中的register_buffer并不是所有场景都必须使用,但在这里它有几个优点:
例如,当我们在LLM中使用CausalAttention类时,缓冲区(buffer)会随着模型一起自动迁移到合适的设备(CPU或GPU) ,这在后续训练LLM时尤为重要。这样我们就不需要手动确保这些张量和模型参数在同一个设备上,从而避免设备不一致错误(device mismatch errors)。
我们可以如下使用CausalAttention类,其方式与先前的SelfAttention类似:
python
torch.manual_seed(123)

context_length = batch.shape[1]
ca = CausalAttention(d_in, d_out, context_length, 0.0)

context_vecs = ca(batch)

print(context_vecs)
print("context_vecs.shape:", context_vecs.shape)
输出的上下文向量是一个三维张量,其中每个token现在被表示为一个二维的嵌入向量:
tensor([[[-0.4519,  0.2216],
         [-0.5874,  0.0058],
         [-0.6300, -0.0632],
         [-0.5675, -0.0843],
         [-0.5526, -0.0981],
         [-0.5299, -0.1081]],

        [[-0.4519,  0.2216],
         [-0.5874,  0.0058],
         [-0.6300, -0.0632],
         [-0.5675, -0.0843],
         [-0.5526, -0.0981],
         [-0.5299, -0.1081]]], grad_fn=<UnsafeViewBackward0>)
context_vecs.shape: torch.Size([2, 6, 2])
图3.23 总结了我们目前为止所完成的所有工作。
 图3.23 本图展示了我们在本章中编码的四种不同注意力模块的心智模型。我们从一个简化的注意力机制开始,随后加入了可训练权重,然后加入了因果注意力掩码。在本章的剩余部分中,我们将进一步扩展因果注意力机制,并实现多头注意力机制(multi-head attention),这将是我们在下一章实现LLM时所使用的最终模块。
3.6 从单头注意力扩展到多头注意力
在本章的最后一节中,我们将把之前实现的因果注意力类扩展为多头(multi-head)注意力 。这一机制也称为多头注意力机制。
术语"多头"指的是将注意力机制划分为多个**"头"**,每个头独立运行。在这个上下文中,一个单独的因果注意力模块可以被视为 单头注意力(single-head attention),即仅使用一组注意力权重顺序地处理输入。
在接下来的小节中,我们将逐步实现从因果注意力到多头注意力的扩展。第一个小节 将通过堆叠多个CausalAttention模块 来直观地构建一个多头注意力模块,用于说明原理。第二个小节 则会以一种更复杂但计算效率更高的方式实现相同的多头注意力机制。
3.6.1 堆叠多个单头注意力层
从实践角度来看,实现多头注意力 就是创建多个自注意力机制的实例 (如第3.4.1节中图3.18所示),每一个都有自己的权重,然后将它们的输出组合起来。虽然使用多个自注意力机制实例会带来一定的计算开销,但这种机制对于Transformer类LLM所擅长的复杂模式识别任务来说至关重要。
图3.24 展示了一个多头注意力模块的结构,它由多个单头注意力模块组成,这些模块就像图3.18中展示的那样,被堆叠在一起。
 图3.24 图中所示的多头注意力模块包含两个堆叠的单头注意力模块。因此,相较于单头注意力机制中仅使用一个值矩阵权重 W v W_v Wv,在一个具有两个头的多头注意力模块中,我们现在有两个值权重矩阵: W v 1 W_{v1} Wv1 和 W v 2 W_{v2} Wv2。对查询矩阵 W q W_q Wq和键矩阵 W k W_k Wk也是一样的道理。最终我们会得到两组上下文向量 ,分别是 Z 1 Z_1 Z1和 Z 2 Z_2 Z2,它们可以组合成一个统一的上下文向量矩阵 Z Z Z。
如前所述,多头注意力机制背后的主要思想是:使用不同的、可学习的线性投影权重 ,将注意力机制并行地运行多次。这些线性投影的结果,类似于将输入数据(如注意力机制中的query、key和value向量)乘以一个权重矩阵。
在代码中,我们可以通过实现一个简单的MultiHeadAttentionWrapper类来实现这一点,该类会堆叠多个我们之前实现的CausalAttention模块实例:
代码清单 3.4 多头注意力的封装类
python
class MultiHeadAttentionWrapper(nn.Module):

    def __init__(self, d_in, d_out, context_length, dropout, num_heads, qkv_bias=False):
        super().__init__()
        self.heads = nn.ModuleList(
            [CausalAttention(d_in, d_out, context_length, dropout, qkv_bias)
             for _ in range(num_heads)]
        )

    def forward(self, x):
return torch.cat([head(x) for head in self.heads], dim=-1)例如,如果我们使用该MultiHeadAttentionWrapper类,并设定两个注意力头(即num_heads=2),且CausalAttention的输出维度为 d o u t = 2 d_{out}=2 dout=2,那么最终的上下文向量维度将是4( d o u t × n u m _ h e a d s = 4 d_{out}×num\_heads=4 dout×num_heads=4),如图3.25所示。
 图3.25 使用
MultiHeadAttentionWrapper时,我们可以通过参数num_heads来指定注意力头的数量。如果我们设定num_heads=2(如图所示),则会得到一个包含两个上下文向量矩阵的张量。在每个上下文向量矩阵中,行表示对应于token的上下文向量,列表示通过 d o u t = 4 d_{out}=4 dout=4指定的嵌入维度。我们将这些上下文向量矩阵沿着列的维度(即最后一个维度)进行拼接 。由于我们有两个注意力头,每个头的嵌入维度为2,因此最终的嵌入维度为 2 × 2 = 4 2×2=4 2×2=4。
为了进一步以具体示例说明图3.25,我们可以像使用CausalAttention类那样使用MultiHeadAttentionWrapper类:
python
torch.manual_seed(123)

context_length = batch.shape[1] # This is the number of tokens
d_in, d_out = 3, 2
mha = MultiHeadAttentionWrapper(
    d_in, d_out, context_length, 0.0, num_heads=2
)

context_vecs = mha(batch)

print(context_vecs)
print("context_vecs.shape:", context_vecs.shape)
这会生成如下的张量,表示上下文向量:
tensor([[[-0.4519,  0.2216,  0.4772,  0.1063],
         [-0.5874,  0.0058,  0.5891,  0.3257],
         [-0.6300, -0.0632,  0.6202,  0.3860],
         [-0.5675, -0.0843,  0.5478,  0.3589],
         [-0.5526, -0.0981,  0.5321,  0.3428],
         [-0.5299, -0.1081,  0.5077,  0.3493]],

        [[-0.4519,  0.2216,  0.4772,  0.1063],
         [-0.5874,  0.0058,  0.5891,  0.3257],
         [-0.6300, -0.0632,  0.6202,  0.3860],
         [-0.5675, -0.0843,  0.5478,  0.3589],
         [-0.5526, -0.0981,  0.5321,  0.3428],
         [-0.5299, -0.1081,  0.5077,  0.3493]]], grad_fn=<CatBackward0>)
context_vecs.shape: torch.Size([2, 6, 4])context_vecs张量的第一个维度是2,因为我们有两个输入文本(输入被复制了两次,因此它们的上下文向量是完全相同的)。第二个维度表示每个输入中的6个token。第三个维度表示每个token的4维嵌入向量。
练习 3.2:返回二维的嵌入向量
将MultiHeadAttentionWrapper(..., num_heads=2)调用中的输入参数修改,使得输出的上下文向量为2维 而不是4维,同时保持num_heads=2不变。提示:你不需要修改类的实现,只需更改其它输入参数中的一个即可。
python
torch.manual_seed(123)

d_out = 1
mha = MultiHeadAttentionWrapper(d_in, d_out, context_length, 0.0, num_heads=2)

context_vecs = mha(batch)

print(context_vecs)
print("context_vecs.shape:", context_vecs.shape)tensor([[[-0.5740, 0.2216],
[-0.7320, 0.0155],
[-0.7774, -0.0546],
[-0.6979, -0.0817],
[-0.6538, -0.0957],
[-0.6424, -0.1065]],
[[-0.5740, 0.2216],
[-0.7320, 0.0155],
[-0.7774, -0.0546],
[-0.6979, -0.0817],
[-0.6538, -0.0957],
[-0.6424, -0.1065]]], grad_fn=<CatBackward0>)
context_vecs.shape: torch.Size([2, 6, 2])在本节中,我们实现了一个MultiHeadAttentionWrapper,它组合了多个单头注意力模块。然而需要注意的是,在forward方法中,这些模块是顺序执行的 :[head(x) for head in self.heads] 我们可以通过并行处理多个注意力头来改进这个实现。其中一种方式是通过矩阵运算同时计算所有注意力头的输出,我们将在下一节探索这一点。
3.6.2 使用权重切分实现多头注意力
在上一节中,我们通过堆叠多个CausalAttention模块创建了一个MultiHeadAttentionWrapper,从而实现了多头注意力机制。
现在,我们不再维护两个独立的类(MultiHeadAttentionWrapper和CausalAttention),而是将这两个概念整合进一个统一的MultiHeadAttention类中。除了将两个类合并,我们还会进行其它修改,以便以更高效的方式实现多头注意力。
在MultiHeadAttentionWrapper中,多头注意力是通过创建一个CausalAttention对象列表(self.heads)来实现的,每个对象代表一个注意力头。每个CausalAttention模块独立执行注意力机制,然后将所有头的输出拼接起来。
与之相对,下面的MultiHeadAttention类在一个类中集成了多头机制。它通过reshape 已投影的query、key和value张量来切分出多个注意力头,然后计算注意力后再将结果组合回来。
代码清单 3.5:一个高效的多头注意力类
python
class MultiHeadAttention(nn.Module):
    def __init__(self, d_in, d_out, context_length, dropout, num_heads, qkv_bias=False):
        super().__init__()
        assert (d_out % num_heads == 0), "d_out must be divisible by num_heads"

        self.d_out = d_out
        self.num_heads = num_heads
        self.head_dim = d_out // num_heads # Reduce the projection dim to match desired output dim

        self.W_query = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.W_key = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.W_value = nn.Linear(d_in, d_out, bias=qkv_bias)
        self.out_proj = nn.Linear(d_out, d_out)  # Linear layer to combine head outputs
        self.dropout = nn.Dropout(dropout)
        self.register_buffer("mask", torch.triu(torch.ones(context_length, context_length), diagonal=1))

    def forward(self, x):
        b, num_tokens, d_in = x.shape
        # As in `CausalAttention`, for inputs where `num_tokens` exceeds `context_length`,
        # this will result in errors in the mask creation further below.
        # In practice, this is not a problem since the LLM (chapters 4-7) ensures that inputs
        # do not exceed `context_length` before reaching this forwar
        '''每个输出形状为 (2, 6, 2)(d_out 为 2)。'''
        keys = self.W_key(x) # Shape: (b, num_tokens, d_out)
        queries = self.W_query(x)
        values = self.W_value(x)

        '''
        将 keys、values、queries 的最后一维从 d_out(2)重塑成 (num_heads, head_dim)。
        这里 num_heads=2, head_dim=1,所以原先 (2,6,2) 重塑为 (2,6,2,1)。
        '''
        # We implicitly split the matrix by adding a `num_heads` dimension
        # Unroll last dim: (b, num_tokens, d_out) -> (b, num_tokens, num_heads, head_dim)
        keys = keys.view(b, num_tokens, self.num_heads, self.head_dim)
        values = values.view(b, num_tokens, self.num_heads, self.head_dim)
        queries = queries.view(b, num_tokens, self.num_heads, self.head_dim)

        # Transpose: (b, num_tokens, num_heads, head_dim) -> (b, num_heads, num_tokens, head_dim)
        '''
        转换后,keys, queries, values 的形状均为 (2, 2, 6, 1)。
        这属于把 "头" 的维度提前,这样后续计算不会影响 "头" 的维度
        '''
        keys = keys.transpose(1, 2)
        queries = queries.transpose(1, 2)
        values = values.transpose(1, 2)

        '''
        keys.transpose(2, 3) 将 keys 的最后两个维度交换,变为 (b, num_heads, head_dim, num_tokens)(2, 2, 1, 6)。
        矩阵乘法 queries @ keys^T 结果形状为 (b, num_heads, num_tokens, num_tokens)。(2, 2, 6, 1) @ (2, 2, 1, 6) -> (2, 2, 6, 6)
        得到每个"token"之间的关系
        '''
        # Compute scaled dot-product attention (aka self-attention) with a causal mask
        attn_scores = queries @ keys.transpose(2, 3)  # Dot product for each head

        # Original mask truncated to the number of tokens and converted to boolean
        mask_bool = self.mask.bool()[:num_tokens, :num_tokens]

        # Use the mask to fill attention scores
        attn_scores.masked_fill_(mask_bool, -torch.inf)

        attn_weights = torch.softmax(attn_scores / keys.shape[-1]**0.5, dim=-1)
        attn_weights = self.dropout(attn_weights)

        '''
        计算注意力输出。先用 attn_weights 与 values 相乘,得到每个 token 经过加权后的表示。  (2, 2, 6, 6) @ (2, 2, 6, 1) -> (2, 2, 6, 1)
        把关系还原到对应的 "头" 维度上,计算出每个 token 的上下文表示。
        结果形状为 (b, num_heads, num_tokens, head_dim);
        然后转置维度,将形状转换为 (b, num_tokens, num_heads, head_dim)。(2, 2, 6, 1) -> (2, 6, 2, 1)
        '''
        # Shape: (b, num_tokens, num_heads, head_dim)
        context_vec = (attn_weights @ values).transpose(1, 2)
        '''
        将多头的输出(当前形状 (b, num_tokens, num_heads, head_dim))重新合并成最后的输出,形状为 (b, num_tokens, d_out)。(2, 6, 2, 1) -> (2, 6, 2)
        这里 d_out = num_heads * head_dim = 2。
        '''
        # Combine heads, where self.d_out = self.num_heads * self.head_dim
        context_vec = context_vec.contiguous().view(b, num_tokens, self.d_out)
        '''
        对合并后的输出再进行一次线性投影,通常用来混合各头的信息,输出的形状仍然为 (b, num_tokens, d_out)。(2, 6, 2)
        '''
        context_vec = self.out_proj(context_vec) # optional projection

return context_vec尽管在MultiHeadAttention类中涉及了大量.view和.transpose操作使代码看起来很复杂,但在数学层面,它实现的逻辑与我们之前的MultiHeadAttentionWrapper是完全一样的。
从整体上看,在之前的MultiHeadAttentionWrapper中,我们是显式堆叠多个单头注意力层 来构建多头注意力层;而在MultiHeadAttention类中,我们采取了更紧凑的实现方式:从一开始就作为一个多头注意力层来设计,然后在内部通过reshape和转置操作来切分成多个注意力头,如图3.26所示。
 图3.26 在
MultiHeadAttentionWrapper类中(上图),我们初始化了两个权重矩阵 W q 1 W_{q1} Wq1和 W q 2 W_{q2} Wq2,并分别计算出两个query矩阵 Q 1 Q_1 Q1和 Q 2 Q_2 Q2。而在MultiHeadAttention类中(下图),我们只初始化了一个更大的权重矩阵 W q W_q Wq,只对输入执行一次矩阵乘法来得到一个大的query矩阵 Q Q Q,然后再将其分割成 Q 1 Q_1 Q1和 Q 2 Q_2 Q2。对key和value的处理方式也是类似的(未画出以简化图示)。
如图3.26所示,对query、key和value张量的切分是通过PyTorch中的.view和.transpose方法对张量进行reshape和转置操作来实现的。输入首先通过用于query、key和value的线性层进行变换,然后被reshape为代表多个注意力头的结构。
关键操作是将 d o u t d_{out} dout维度切分为 n u m h e a d s num_{heads} numheads和 h e a d d i m head_{dim} headdim,其中 h e a d d i m = d o u t / n u m h e a d s head_{dim}=d_{out}/num_{heads} headdim=dout/numheads。这种切分是通过.view方法实现的:一个维度为 ( b , n u m _ t o k e n s , d o u t ) (b,num\tokens,d{out}) (b,num_tokens,dout)的张量被reshape为 ( b , n u m _ t o k e n s , n u m _ h e a d s , h e a d _ d i m ) (b,num\_tokens,num\_heads,head\_dim) (b,num_tokens,num_heads,head_dim)。
随后这些张量会进行转置操作,将 n u m h e a d s num_{heads} numheads维度置于 n u m t o k e n s num_{tokens} numtokens之前,从而得到形状为 ( b , n u m _ h e a d s , n u m _ t o k e n s , h e a d _ d i m ) (b,num\_heads,num\_tokens,head\_dim) (b,num_heads,num_tokens,head_dim)的张量。这种转置对于正确对齐不同头之间的query、key和value,并高效地进行批量矩阵乘法是至关重要的。
为了说明这种批量矩阵乘法,假设我们有如下示例张量:
python
# (1,2,3,4)
a = torch.tensor([[[[0.2745, 0.6584, 0.2775, 0.8573],
                    [0.8993, 0.0390, 0.9268, 0.7388],
                    [0.7179, 0.7058, 0.9156, 0.4340]],
                   [[0.0772, 0.3565, 0.1479, 0.5331],
                    [0.4066, 0.2318, 0.4545, 0.9737],
                    [0.4606, 0.5159, 0.4220, 0.5786]]]])
现在我们对该张量与其最后两个维度( n u m _ t o k e n s num\_tokens num_tokens和 h e a d _ d i m head\_dim head_dim)转置后的版本执行批量矩阵乘法:
python
print(a @ a.transpose(2, 3)) # (1,2,3,4) @ (1,2,4,3)结果如下:
# (1,2,3,3)
tensor([[[[1.3208, 1.1631, 1.2879],
          [1.1631, 2.2150, 1.8424],
          [1.2879, 1.8424, 2.0402]],

         [[0.4391, 0.7003, 0.5903],
          [0.7003, 1.3737, 1.0620],
          [0.5903, 1.0620, 0.9912]]]])
在这种情况下,PyTorch中的矩阵乘法实现会处理四维张量,在最后两个维度( n u m _ t o k e n s num\_tokens num_tokens, h e a d _ d i m head\_dim head_dim)上进行矩阵乘法,并对每个注意力头重复该过程。
例如,上述操作实际上是对每个注意力头分别计算矩阵乘法的更紧凑表达。等价实现如下:
python
first_head = a[0, 0, :, :]
first_res = first_head @ first_head.T
print("First head:\n", first_res)

second_head = a[0, 1, :, :]
second_res = second_head @ second_head.T
print("\nSecond head:\n", second_res)
输出结果与之前批量矩阵乘法得到的完全一致:
First head:
 tensor([[1.3208, 1.1631, 1.2879],
         [1.1631, 2.2150, 1.8424],
         [1.2879, 1.8424, 2.0402]])

Second head:
 tensor([[0.4391, 0.7003, 0.5903],
         [0.7003, 1.3737, 1.0620],
[0.5903, 1.0620, 0.9912]])继续讨论MultiHeadAttention:在计算完注意力权重和上下文向量之后,来自所有头的上下文向量会被转置回形状 ( b , n u m _ t o k e n s , n u m _ h e a d s , h e a d _ d i m ) (b,num\_tokens,num\_heads,head\_dim) (b,num_tokens,num_heads,head_dim)。然后这些向量会被reshape(扁平化)为 ( b , n u m _ t o k e n s , d o u t ) (b,num\tokens,d{out}) (b,num_tokens,dout),从而有效地将所有注意力头的输出组合起来。
此外,我们在MultiHeadAttention中添加了一个输出投影层 (self.out_proj),用于在合并所有头之后进一步处理结果向量。这在CausalAttention类中并不存在。这个输出投影层并非绝对必要(详见附录B中的参考资料),但由于它在许多LLM架构中都被广泛使用,因此我们在这里为了完整性将其加入。
尽管MultiHeadAttention类由于引入了张量reshape和转置操作,看起来比MultiHeadAttentionWrapper更复杂,但它实际上更高效。原因是我们只需一次矩阵乘法就能计算出keys,例如:
python
keys = self.W_key(x)对于queries和values也是同理。而在MultiHeadAttentionWrapper中,我们为每个头都要重复这一步骤,而这正是计算中最昂贵的一步之一。
MultiHeadAttention类的用法与我们之前实现的SelfAttention和CausalAttention类似:
python
torch.manual_seed(123)

batch_size, context_length, d_in = batch.shape
d_out = 2
mha = MultiHeadAttention(d_in, d_out, context_length, 0.0, num_heads=2)

context_vecs = mha(batch)

print(context_vecs)
print("context_vecs.shape:", context_vecs.shape)
从输出可以看出,输出维度直接由 d o u t d_{out} dout参数控制:
tensor([[[0.3190, 0.4858],
         [0.2943, 0.3897],
         [0.2856, 0.3593],
         [0.2693, 0.3873],
         [0.2639, 0.3928],
         [0.2575, 0.4028]],

        [[0.3190, 0.4858],
         [0.2943, 0.3897],
         [0.2856, 0.3593],
         [0.2693, 0.3873],
         [0.2639, 0.3928],
         [0.2575, 0.4028]]], grad_fn=<ViewBackward0>)
context_vecs.shape: torch.Size([2, 6, 2])在本节中,我们实现了MultiHeadAttention类,它将在后续章节中实现和训练LLM时被使用。
请注意,虽然代码是完整可运行的,但我们使用了较小的嵌入维度和注意力头数量,以便使输出结果更易读。
作为对比,最小的GPT-2模型(具有1.17亿参数)拥有:
- 12个注意力头
- 上下文向量的嵌入维度为768
而最大的GPT-2模型(15亿参数)拥有:
- 25个注意力头
- 上下文嵌入维度为1600
需要注意的是,在GPT模型中,token输入嵌入和上下文嵌入的维度是相同的,即 d i n = d o u t d_{in}=d_{out} din=dout。
练习 3.3 初始化与GPT-2规模一致的注意力模块
使用MultiHeadAttention类,初始化一个具有与最小GPT-2模型相同数量的注意力头的多头注意力模块(即12个注意力头 )。同时,请确保你使用的输入和输出嵌入维度类似GPT-2(即768维 )。注意,最小的GPT-2模型支持的上下文长度为1024个token。
上下文长度为1024,输入输出嵌入维度设置如下:
python
context_length = 1024
d_in, d_out = 768, 768
num_heads = 12

mha = MultiHeadAttention(d_in, d_out, context_length, 0.0, num_heads)
可选地,可以使用如下函数来统计参数数量:
python
def count_parameters(model):
    return sum(p.numel() for p in model.parameters() if p.requires_grad)

count_parameters(mha)
输出结果为:
2360064 #(2.36M)GPT-2模型总共有1.17亿个参数,但正如我们所看到的,多头注意力模块本身只占其中的一小部分参数量。
3.7 小结
-
注意力机制将输入元素转换为增强的上下文向量表示,这些表示整合了关于所有输入的信息。
-
自注意力机制将上下文向量表示计算为对输入的加权和。
-
在简化的注意力机制中,注意力权重是通过点积计算的。
-
点积只是对两个向量按元素相乘后求和的一种简洁写法。
-
尽管不是严格必要的,但矩阵乘法能帮助我们更高效且更简洁地实现这些计算,替代嵌套的for循环。
-
在LLM中使用的自注意力机制(也称为缩放点积注意力)中,我们引入了可训练的权重矩阵来对输入进行中间变换:query、key 和 value。
-
当我们使用从左到右读取和生成文本的LLM时,需要添加因果注意力掩码以防止LLM访问未来的token。
-
除了使用因果掩码将注意力权重置零,我们还可以添加dropout掩码,以减少LLM中的过拟合。
-
基于transformer的LLM中的注意力模块通常包含多个因果注意力模块的实例,这被称为多头注意力。
-
我们可以通过堆叠多个因果注意力模块的实例来构建一个多头注意力模块。
-
更高效的多头注意力模块实现方式是使用批量矩阵乘法。