🌟 Spring Data JPA中的List底层:深入解析ArrayList的奥秘
💡 你是否好奇过,为什么Spring Data JPA的查询方法返回的List<T>总是默认为ArrayList?本文将通过技术原理解析 、验证实验 和性能优化指南,为你揭开这一设计的神秘面纱!
一、核心原理:为什么是ArrayList?
1. ORM框架的默认选择
Spring Data JPA底层采用Hibernate作为JPA实现。当执行查询时,Hibernate会将数据库结果集转换为Java对象,并存储在内存连续存储的动态数组 中,这是ArrayList的典型特征。
Hibernate执行查询 获取JDBC结果集 逐行映射为Entity对象 填充到ArrayList 返回给调用方
2. 性能设计的考量
• 随机访问效率 :ArrayList的O(1)时间复杂度适合数据库结果的遍历操作
• 内存连续性 :与数据库结果集的顺序读取模式高度匹配
• 扩展性:动态扩容机制(默认容量10,1.5倍增长)适应不确定的数据量
二、验证实验:如何确认底层类型?🔍
1. 代码验证法
java
List<User> users = userRepository.findByDepartment("IT");
System.out.println("实际类型:" + users.getClass().getName());
// 输出: java.util.ArrayList
2. 调试观察法
通过IDE调试工具观察变量结构:
• 存在elementData字段(动态数组核心存储)
• 变量类型标识显示为ArrayList
User Repository Hibernate Database ArrayList findByDepartment("IT") 生成JPQL 执行SELECT * FROM users 返回ResultSet 映射为User对象 填充数据 返回List<User> User Repository Hibernate Database ArrayList
三、性能优化:ArrayList的正确打开方式 🚀
1. 批处理配置(关键!)
yaml
spring:
  jpa:
    properties:
      hibernate:
        jdbc.batch_size: 100
        order_inserts: true
        batch_versioned_data: true
• MySQL需追加参数 :rewriteBatchedStatements=true
2. 事务管理策略
java
@Transactional
public void batchInsert(List<User> users) {
    int batchSize = 100;
    for(int i=0; i<users.size(); i++){
        entityManager.persist(users.get(i));
        if(i % batchSize == 0 && i > 0){
            entityManager.flush();
            entityManager.clear(); // 防止内存溢出💥
        }
    }
}
3. 分页查询优化
java
Pageable pageable = PageRequest.of(0, 100, Sort.by("createTime").descending());
Page<User> page = userRepository.findAll(pageable);
List<User> content = page.getContent(); // 仍然是ArrayList
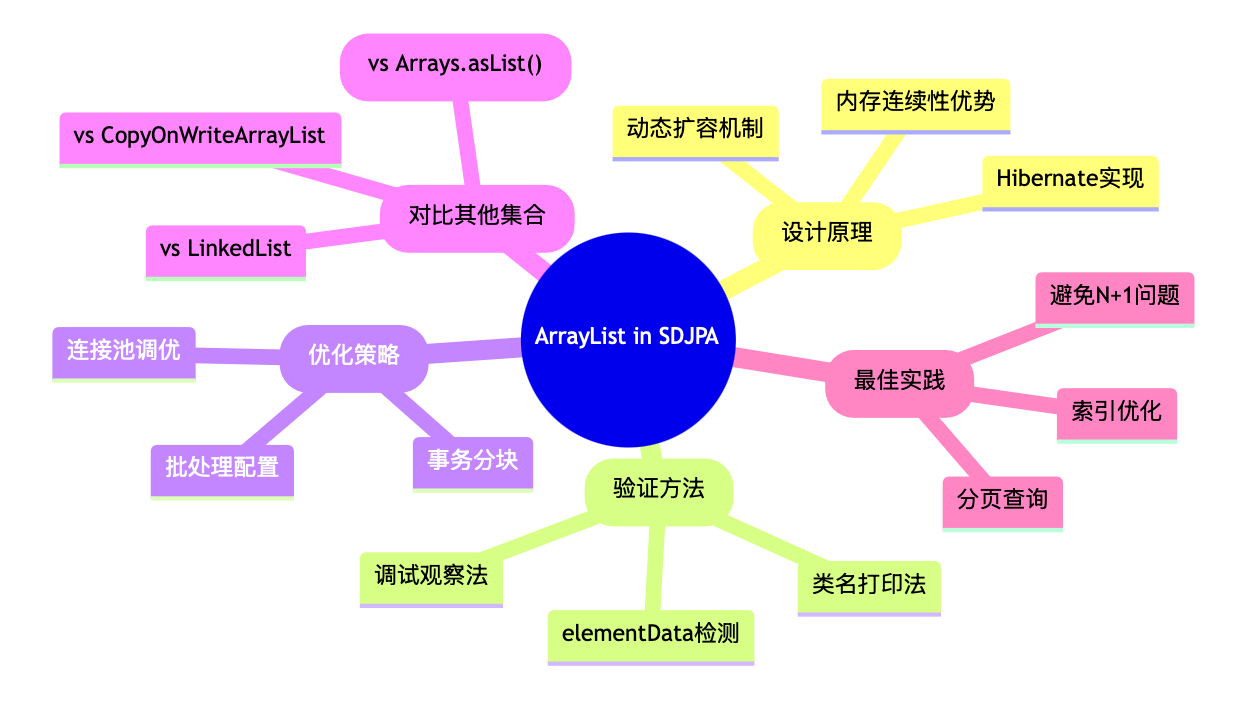
四、思维导图:核心知识点全景
五、深度思考:扩展场景与挑战 🤔
1. 高并发场景
• 线程安全 :ArrayList非线程安全,需配合@Transactional保证原子性
• 连接池配置 :建议设置maxLifetime < 数据库wait_timeout
2. 大数据量处理
java
try(Stream<User> stream = userRepository.streamAllBy()) {
    stream.forEach(user -> process(user)); // 流式处理避免OOM
}
3. 多数据源场景
java
@Bean
@Primary
public LocalContainerEntityManagerFactoryBean primaryEMF() {
    // 不同数据源需单独配置hibernate.jdbc.batch_size
}
通过本文的解析,相信你已经全面掌握了Spring Data JPA中ArrayList的运作机制!在实际开发中,合理利用动态数组特性+优化配置,能让你的应用性能飞升🚀。如果遇到性能瓶颈,不妨回头看看事务管理和批处理配置是否到位哦~