【Shell】模拟爬虫下载天龙八部小说

Shell脚本:

bash 复制代码
#curl https://tianlong.5000yan.com/ -o tianlong.html
grep "href=" tianlong.html | grep html | awk -F"\"" '{ print $6 }' >> urls.txt
grep "href=" tianlong.html | grep html | awk -F">" '{ print $3 }' | awk -F"<" '{ print $1 }' >>titles.txt

exec 3<urls.txt
exec 4<titles.txt

while read -u 3 url && read -u 4 title
do
	echo "$title : $url"
	curl "$url" -o "${title}.html"
done

exec 3<&-
exec 4<&-

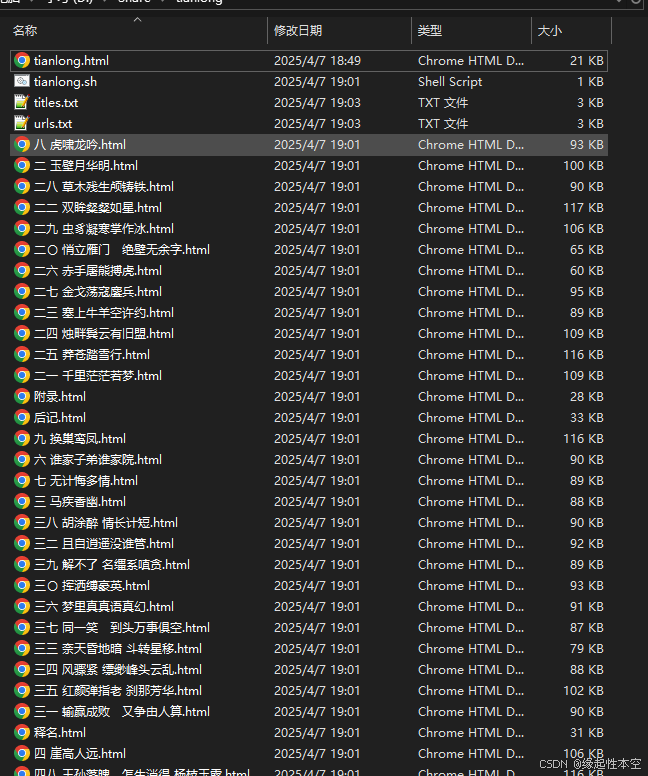
下载后的文件:
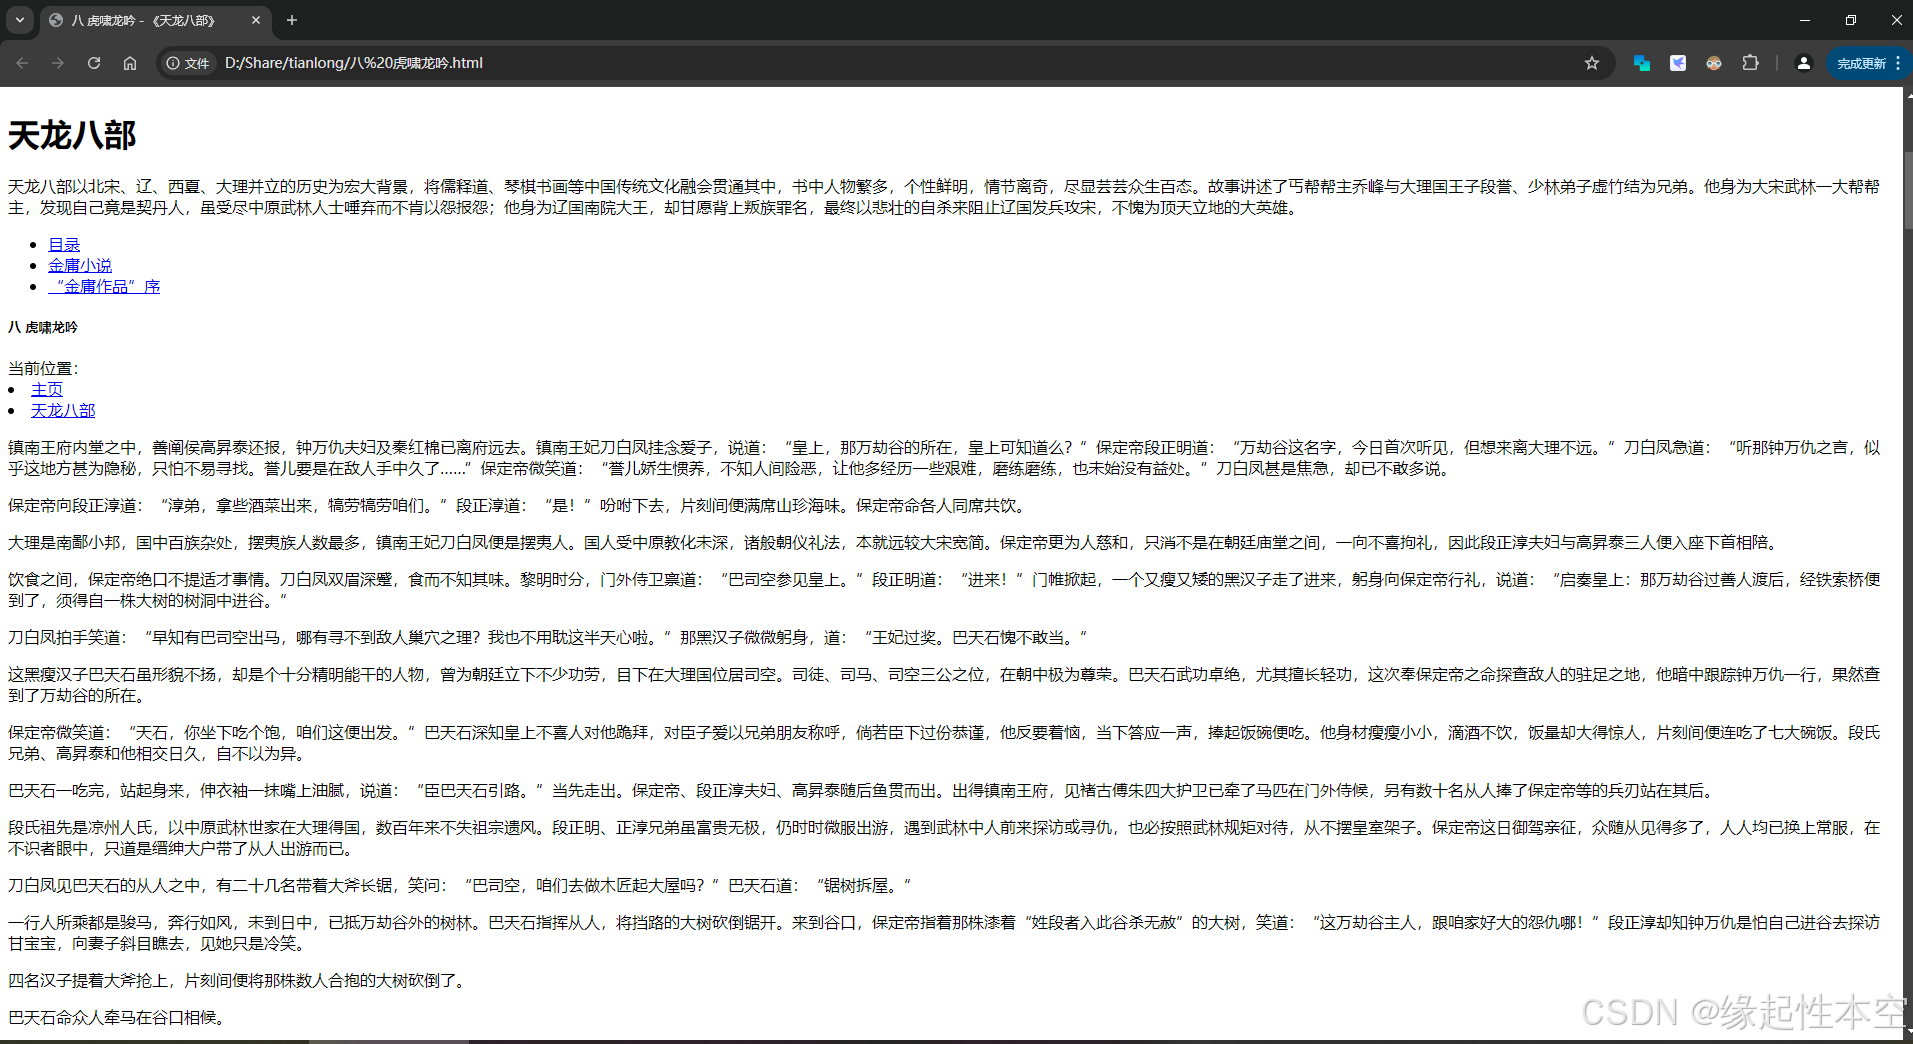
下载后的效果:
相关推荐
qq_371802117 小时前
Ubuntu Linux中安装WorkBuddy
linux·运维·服务器·ubuntu
无足鸟ICT7 小时前
【RHCA+】iptraf-ng(网络监控分析)
linux·网络
独隅7 小时前
WebStorm 在 Linux 环境下的实战安装与高效开发指南
linux·ide·webstorm
老纪的技术唠嗑局8 小时前
把 seekdb 塞进 iOS App:让混合检索嵌入手机
数据库
坤坤子吖9 小时前
Linux网络编程:TCP服务器的多进程与多线程实现
linux·服务器·开发语言·网络·c++·笔记·学习
ClouGence9 小时前
开源数据库管理工具 CloudDM 新版本发布,支持 OpenSearch、IoTDB 数据源
数据库·开源
阡陌数智9 小时前
Claude API新版本重大变更与安全升级指南
java·linux·安全
奶茶树10 小时前
【Linux】环境开发工具(vim,gcc,g++,Makefile)
linux·运维·vim
徐小黑ACG10 小时前
Redis-基础
数据库·redis·缓存
火山引擎开发者社区10 小时前
案例实践 | 让 Agent 读懂业务口径:ContextSearch 在广告数据查询中的实践
数据库