aspark 配置2

编写Hadoop集群启停脚本

1.建立新文件,编写脚本程序

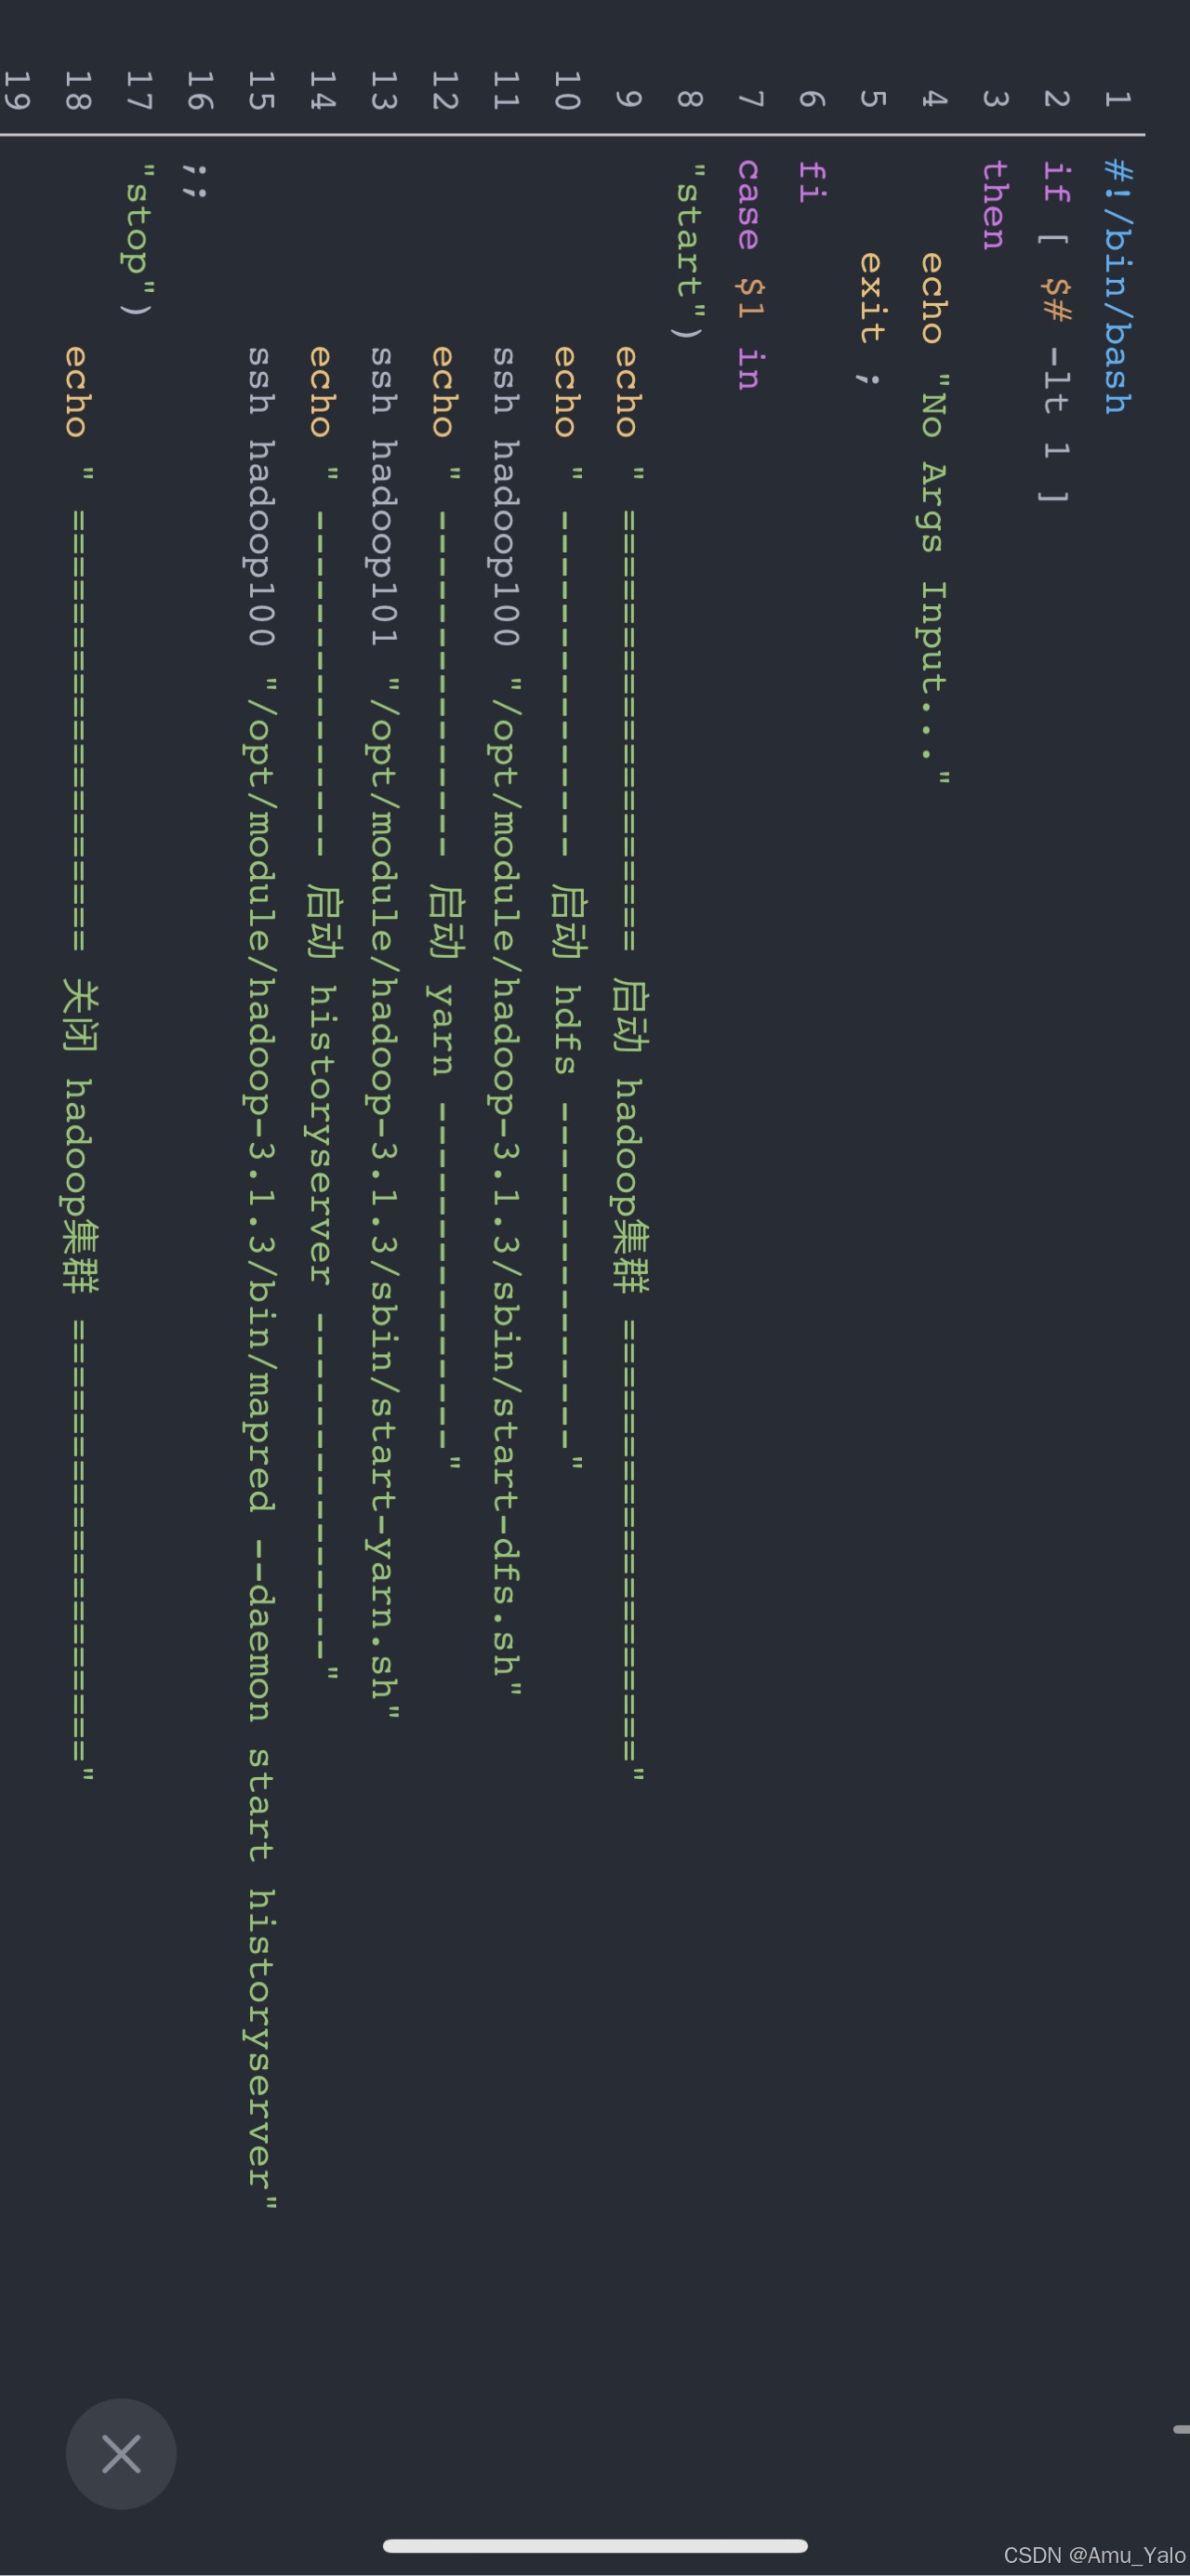
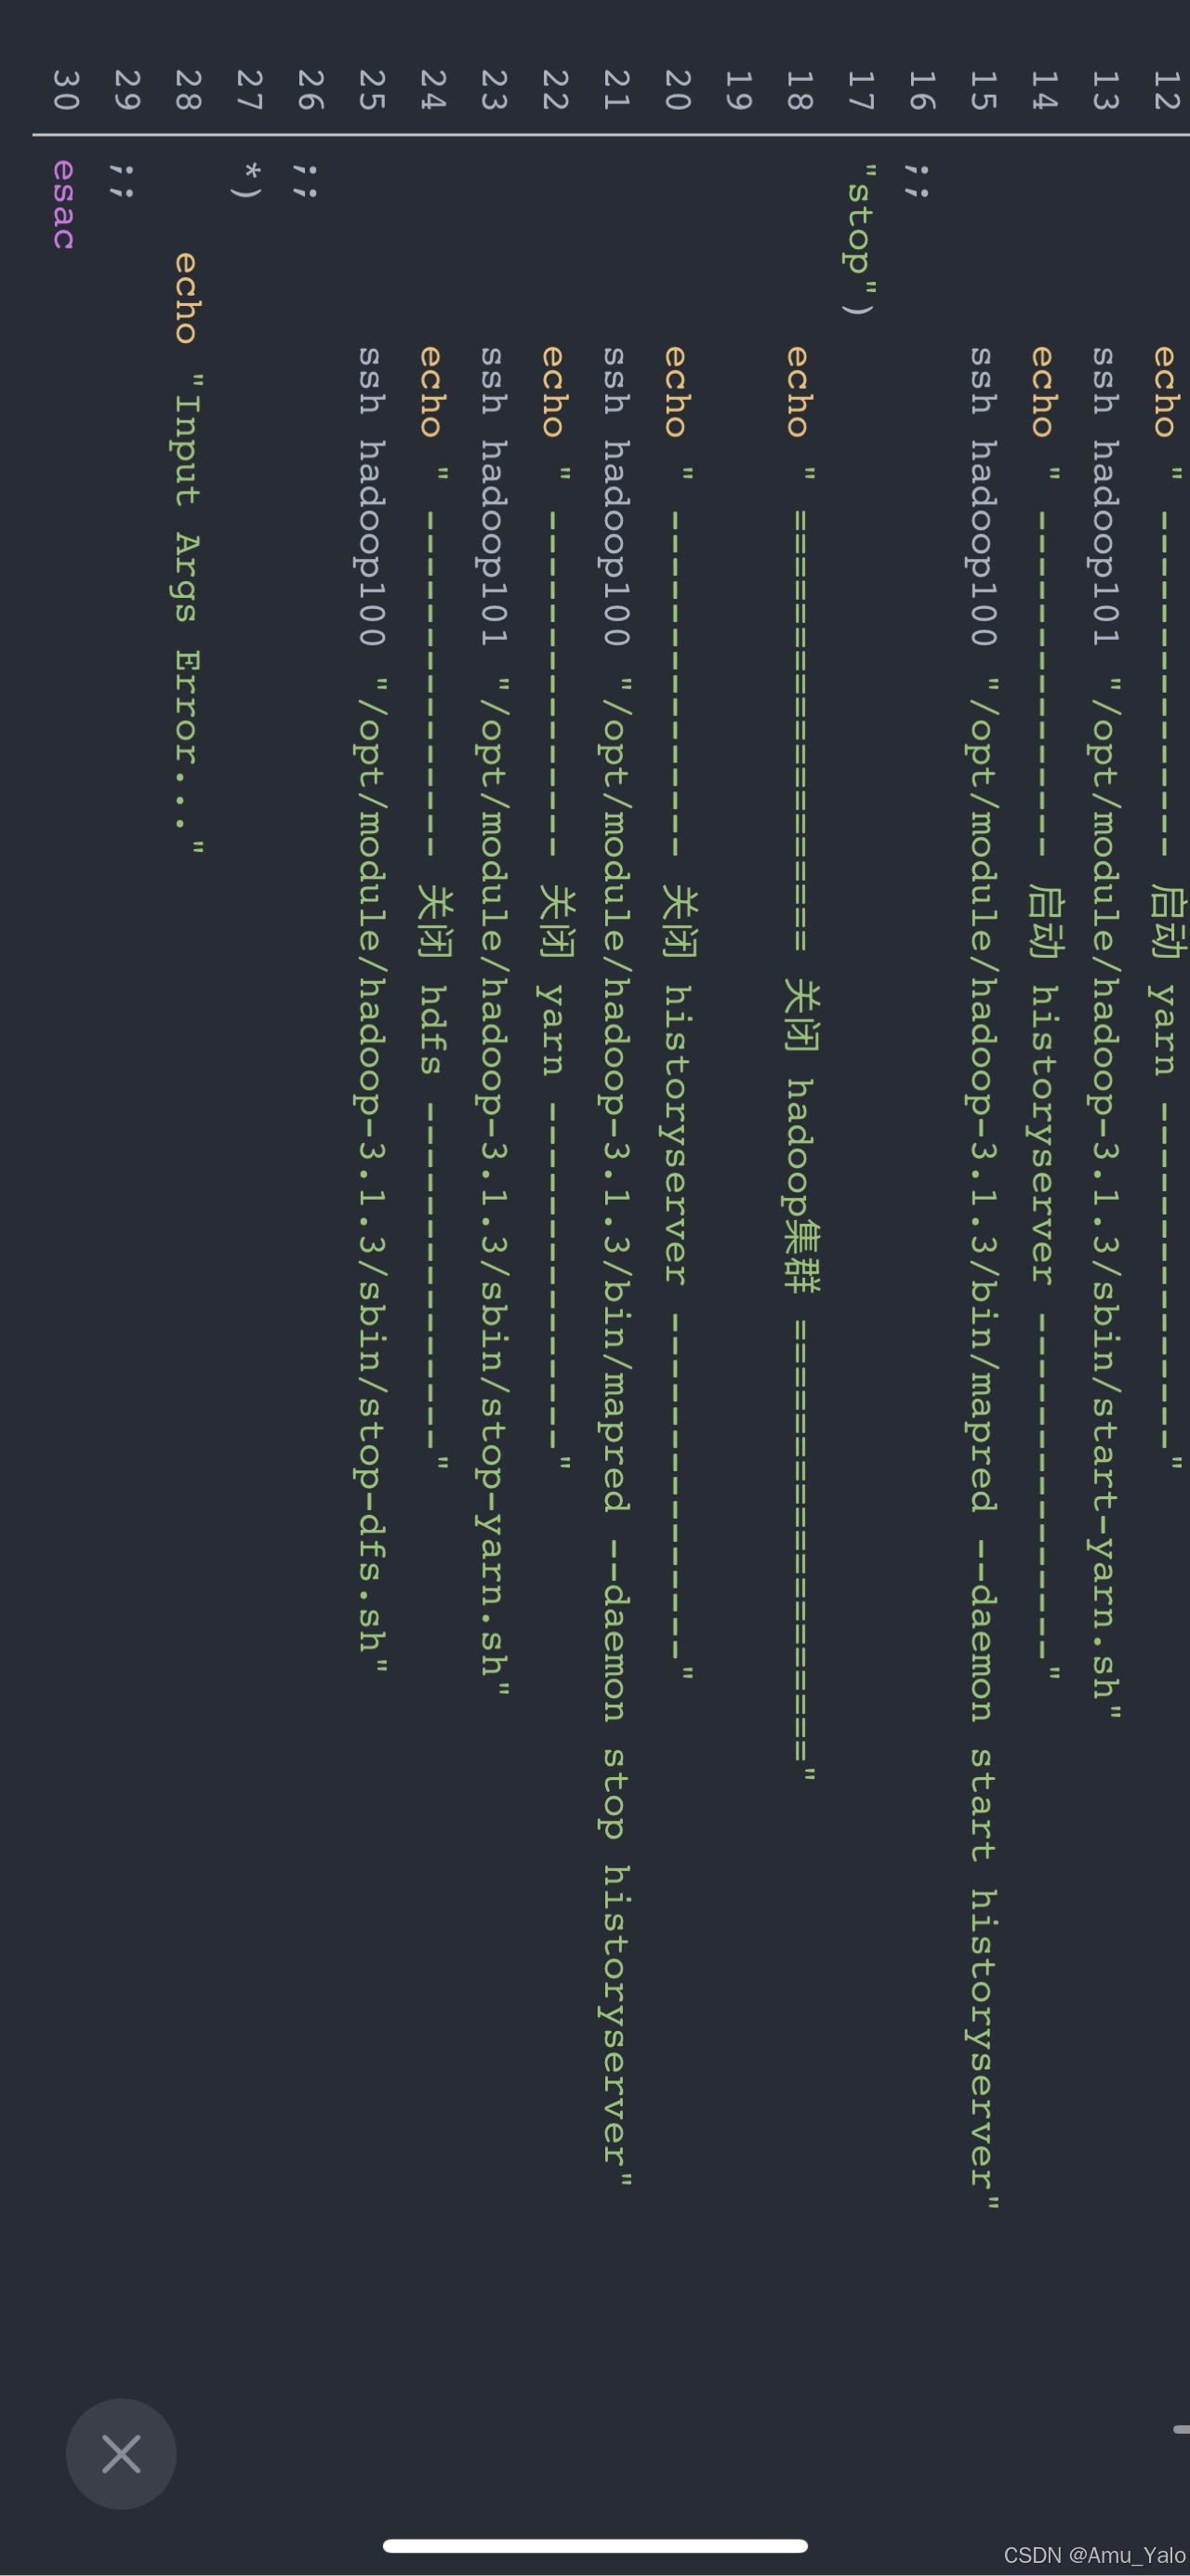
在hadoop101中操作,在/root/bin下新建文件:myhadoop,输入如下内容:
2.分发执行权限

保存后退出,然后赋予脚本执行权限

root@hadoop101 \~$ chmod +x /root/bin/myhadoop

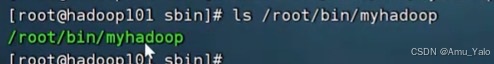
像下图这样查看显示绿色即代表成功!
3.分发脚本

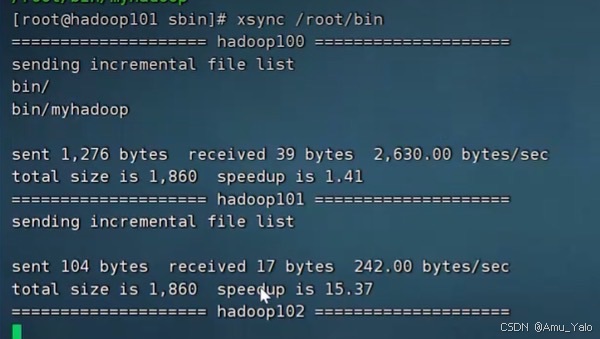
root@hadoop101 \~$ xsync /root/bin/
4.测试执行

分配完成后可在其他设备上关闭myhadoop
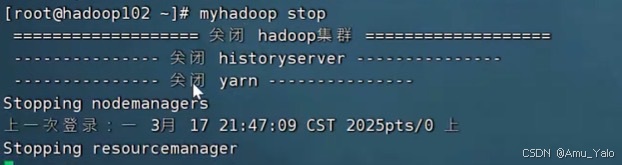
启动命令:root@hadoop100 sbin# myhadoop start

关闭命令:root@hadoop100 sbin# myhadoop stop

相关推荐
ha_lydms13 小时前
AnalyticDB MySQL 技术架构
大数据·hadoop·mysql·adb·spark·dataworks·1024程序员节
红海云19 小时前
两台DGX Spark部署DeepSeek的实战边界
大数据·分布式·spark
爱吃火鸡面呀3 天前
PySpark 入门实战:从 DataFrame 到 SQL、DSL 与窗口函数
分布式·spark
ha_lydms4 天前
Window Functions(窗口函数)
大数据·数据仓库·hadoop·spark·数据处理·dataworks·maxcompute
爱吃火鸡面呀4 天前
Spark RDD 行动算子(Action)详解
windows·ajax·spark
pjj198544 天前
Spark RDD 核心知识详解:算子、依赖与执行模型
大数据·分布式·spark
大鳥4 天前
JSON 解析最佳实践:从入门到生产级优化
hive·sql·spark·json
pjj198544 天前
Spark SQL 核心知识详解:DataFrame、DSL 与数据源
大数据·sql·spark
浔溺4 天前
Spark核心基石:RDD全方位深度解析(原理、算子、实战、优化)
大数据·分布式·spark
ha_lydms4 天前
Xml Functions(XML 函数)
xml·大数据·hadoop·spark·数据处理·dataworks·maxcompute