需求背景
在开发过程中可能会存在用户上传一张图片后下方需要自己识别出来文字数字等信息,有的时候会通过后端来识别后返回,但是也会存在纯前端去识别的情况,这个时候就需要使用到Tesseract.js这个库了 附Tesseract.js官方(https://github.com/naptha/tesseract.js)
实现过程
主要的实现代码部分和这部分的简易效果图
javascript
import {createWorker} from 'tesseract.js';

const worker = await createWorker();
await worker.loadLanguage('chi_sim');
await worker.initialize('chi_sim');
const { data: { text } } = await worker.recognize(myImage);
console.log(text);
await worker.terminate();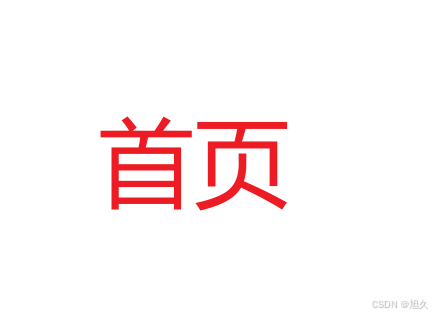
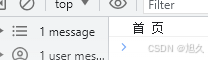
下方是一个简单的完整实现案例 ⬇
npm install tesseract.js
-
createWorker创建worker实例。
-
调用worker.loadLanguage('chi_sim')。
-
调用worker.initialize('chi_sim')。
-
然后调用recognize方法进行识别。
javascript
import React, { useState, useEffect } from 'react';
import { createWorker } from 'tesseract.js';

const OCRComponent = () => {
  const [image, setImage] = useState(null);
  const [text, setText] = useState('');
  const [progress, setProgress] = useState(0);
  const [error, setError] = useState('');
  const [worker, setWorker] = useState(null);

  // 初始化 Worker
  useEffect(() => {
    const initializeWorker = async () => {
      const newWorker = await createWorker();
      setWorker(newWorker);
    };
    initializeWorker();
    return () => {
      if (worker) {
        worker.terminate();
      }
    };
  }, []);

  // 处理图片上传
  const handleImageUpload = (e) => {
    const file = e.target.files[0];
    if (file) {
      const reader = new FileReader();
      reader.onloadend = () => {
        setImage(reader.result);
      };
      reader.readAsDataURL(file);
      setText('');
      setError('');
    }
  };

  // 执行 OCR 识别
  const recognizeText = async () => {
    if (!worker || !image) return;

    try {
      //chi_sim代表的是简体中文包  eng是英文  需要识别其他语言的话可以官网去看下对应的名称
      await worker.loadLanguage('chi_sim');
      await worker.initialize('chi_sim');
      const { data: { text } } = await worker.recognize(image, {
        logger: (m) => {
          if (m.status === 'recognizing text') {
            setProgress(Math.round(m.progress * 100));
          }
        }
      });
      setText(text);
    } catch (err) {
      setError('识别失败,请重试或更换图片。');
      console.error(err);
    } finally {
      await worker.terminate();
    }
  };

  return (
    <div>
      <h1>中文 OCR 文字识别</h1>

      {/* 文件上传 */}
      <input type="file" accept="image/*" onChange={handleImageUpload} />

      {/* 图片预览 */}
      {image && (
        <div>
          <h3>图片预览</h3>
          <img src={image} alt="预览" style={{ maxWidth: '100%', height: 'auto' }} />
        </div>
      )}

      {/* 识别按钮及进度 */}
      {image && (
        <div>
          <button onClick={recognizeText} disabled={progress > 0}>
            {progress > 0 ? `识别中... ${progress}%` : '开始识别'}
          </button>
        </div>
      )}

      {/* 显示结果 */}
      {text && (
        <div>
          <h3>识别结果</h3>
          <pre style={{ whiteSpace: 'pre-wrap' }}>{text}</pre>
        </div>
      )}

      {/* 错误提示 */}
      {error && <p style={{ color: 'red' }}>{error}</p>}
    </div>
  );
};

export default OCRComponent;