基于Node+HeadlessBrowser的浏览器自动化方案
什么是无头浏览器(Headless Browser)?
无头浏览器,就像是一个没有用户界面的浏览器程序。你可以想象它就是一个"隐形"的浏览器,只不过它没有图形界面,但能做我们用普通浏览器所能做的大部分事情,比如打开网页、执行 JavaScript、进行页面互动等。无头浏览器最常用的场景就是在自动化测试、网页抓取、服务器上执行任务等不需要用户界面的场合。
使用无头浏览器,你无需打开真正的浏览器窗口就可以让程序去浏览网页、录制操作、生成截图等等,特别适合那些需要在没有人手动操作的情况下处理网页内容的任务。
| 特性 | Playwright | Puppeteer | Selenium | PhantomJS |
|---|---|---|---|---|
| 支持浏览器 | Chromium, Firefox, WebKit | Chromium | 所有主流浏览器 | 已内置 WebKit |
| 平台支持 | Windows, Mac, Linux | Windows, Mac, Linux | Windows, Mac, Linux | Windows, Mac, Linux |
| 多浏览器支持 | 是 | 否 | 是 | 否 |
| API 现代性 | 现代且易用 | 现代且易用 | 较复杂,学习曲线陡峭 | 较简单 |
| 开发活跃度 | 活跃且增长快 | 活跃 | 非常活跃 | 已停止维护 |
| 适用场景 | 自动化测试、爬虫、跨浏览器兼容性测试 | 浏览器自动化测试和爬虫 | 复杂测试流程 | 静态网页抓取 |
| 启动速度 | 快 | 快 | 较慢 | 快 |
| 资源占用 | 中 | 中 | 高 | 低 |
| 文档和社区支持 | 良好 | 优秀 | 广泛 | 限制, 文档停滞 |
- Playwright:适合需要多浏览器支持的项目,API 现代且跨平台,对新功能的支持很快。
- Puppeteer:专注于 Chromium,适合简单的自动化测试和爬虫任务。
- Selenium:对于复杂的跨浏览器测试任务是很好的选择,但需要较多的配置和学习。
- PhantomJS:虽然轻量且快速,但由于停止维护,而其使用逐渐减少,不建议用于新项目。
一、依赖安装
以下用Playwright为例,实现几个模拟浏览器操作的案例
// 安装无头浏览器依赖
npm i playwright --save
// 安装浏览器内核
npx playwright install
二、具体自动化操作
ScreenHotUtils.js提供了三个案例方法
-
对目标网页进行截取
-
获取目标页面的大标题
-
获取目标页面Window对象的任意属性
// 注入chromium内核
const { chromium } = require('playwright');/**
- 异步暂停方法
- @param {number} delay - 时长(以毫秒为单位)
- @returns {Promise
}
*/
const sleep = delay => new Promise(resolve => setTimeout(resolve, delay));
/**
- 网页截屏方法
- @param {string} webPageUrl - 目标网页地址
- @param {number} loadDelay - 网页加载延时(以毫秒为单位)
- @param {number} width - 浏览器宽度
- @param {number} height - 浏览器高度
- @param {boolean} fullPage - 是否进行全屏长截图
- @returns {Promise
} - 截图图像的Buffer
*/
const captureWebPageScreenshot = async (
webPageUrl,
loadDelay = 1000,
width = 1980,
height = 1024,
fullPage = false
) => {
// 创建浏览器对象
const browser = await chromium.launch();
// 创建一个新的页面
const page = await browser.newPage({
viewport: {
width,
height,
},
});
// 跳转到目标页
await page.goto(webPageUrl);
// 等待页面加载完成
await page.waitForLoadState('load');
// 页面加载延时
await sleep(loadDelay);
// 截图,并获取一个Buffer
const screenFileBuffer = await page.screenshot({ fullPage });
// 关闭浏览器
await browser.close();
return screenFileBuffer;
};
/**
- 获取网页标题
- @param {string} webPageUrl - 目标网页地址
- @param {number} loadDelay - 网页加载延时(以毫秒为单位)
- @returns {Promise
} - 网页标题
*/
const getWebPageTitle = async (webPageUrl, loadDelay = 1000) => {
// 创建浏览器对象
const browser = await chromium.launch();
const page = await browser.newPage();
await page.goto(webPageUrl);
await page.waitForLoadState('load');
await sleep(loadDelay);

// 获取页面标题
const title = await page.title();
await browser.close();
return title;
};
/**
- 获取Window属性
- @param {string} webPageUrl - 目标网页地址
- @param {string[]} propertyNames - 要获取的属性名称列表
- @returns {Promise
} - 获取的属性值
*/
const getWindowProperty = async (webPageUrl, propertyNames) => {
const browser = await chromium.launch();
const page = await browser.newPage();
await page.goto(webPageUrl);
await page.waitForLoadState('load');

// 使用 evaluate 在页面上下文中运行脚本
const propertyValue = await page.evaluate(propertyNames => {
  const result = propertyNames.reduce((pre, prop) => {
    pre = pre[prop];
    return pre;
  }, window);
  return result;
}, propertyNames);

await browser.close();

return propertyValue;
};
module.exports = {
getWebPageTitle,
getWindowProperty,
captureWebPageScreenshot,
};
三、执行测试
const {
  getWebPageTitle,
  captureWebPageScreenshot,
  getWindowProperty,
} = require('./ScreenHotUtils');
const fs = require('fs');
const path = require('path');

(async () => {
  const webPageUrl = `http://www.baidu.com`;
  //   执行截图动作
  const fileBuffer = await captureWebPageScreenshot(webPageUrl);
  // 写入本地 | 上传OSS | 其他
  fs.writeFileSync(path.resolve(__dirname, './screenShot.png'), fileBuffer);
  //   获取页面标题
  const pageTitle = await getWebPageTitle(webPageUrl);
  console.log('PageTitle', pageTitle); // 百度一下 你就知道
  // 获取页面cookie
  const cookie = await getWindowProperty(webPageUrl, ['document', 'cookie']);
  console.log('Cookie:', cookie); // cookie......
})();
效果:
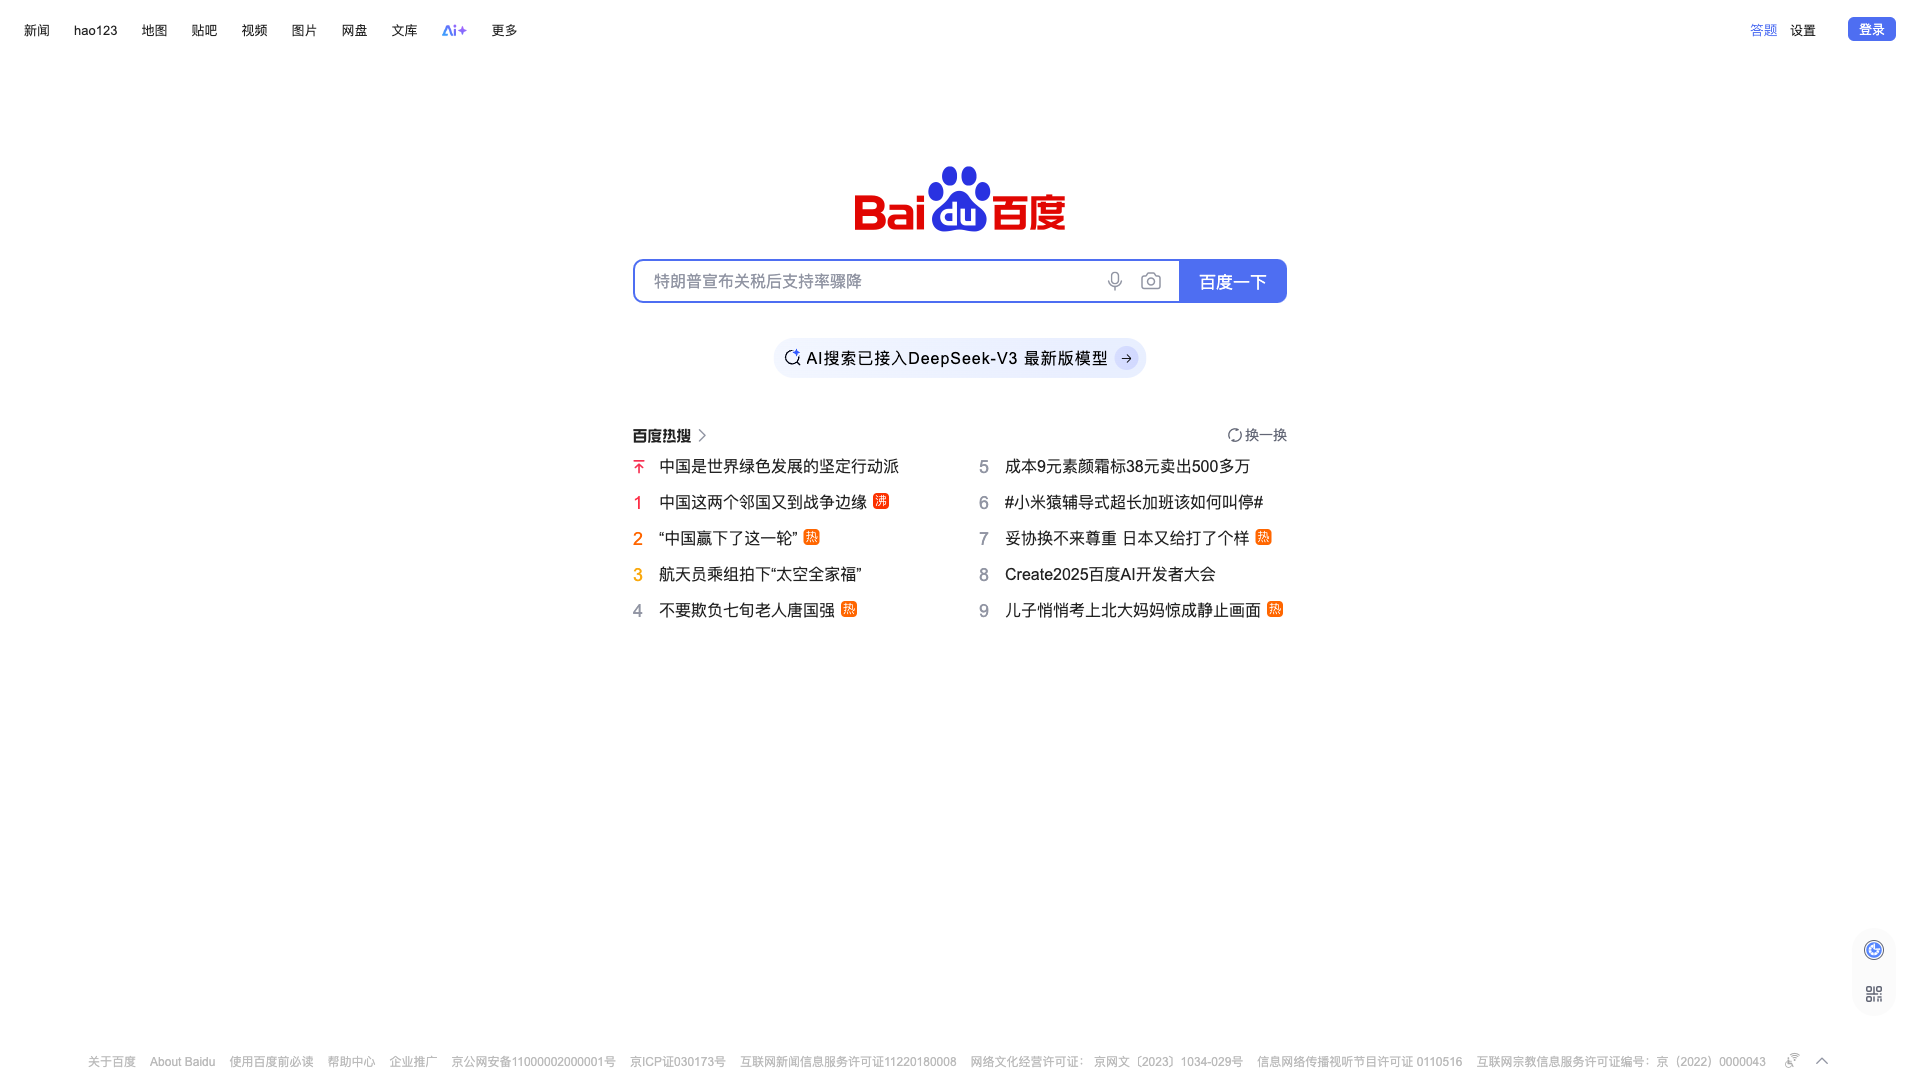
就这样,我们可以轻松获得一个页面截图,通过代码就能在不打开浏览器的情况下获取到网页的图像,来实现一些自动化巡检&截图工具。