如何在idea中写spark程序以下是在IDEA中编写Spark程序的步骤:
环境准备
-
安装IntelliJ IDEA:从JetBrains官网下载适合系统的版本,社区版或旗舰版均可 。
-
配置Java开发环境:安装JDK 8及以上版本,并配置好 JAVA_HOME 环境变量 。比如在Linux系统中,编辑 ~/.bashrc 文件,添加 export JAVA_HOME=/path/to/jdk ( /path/to/jdk 为实际JDK安装路径) ,再执行 source ~/.bashrc 使配置生效。
-
安装Scala插件(若用Scala编写) :打开IDEA,选择 File -> Settings (Windows/Linux)或 IntelliJ IDEA -> Preferences (Mac) ,在左侧菜单选 Plugins ,在搜索框输入"Scala" ,点击 Install 安装 。
创建新项目
-
创建Maven项目:打开IDEA,选 File -> New -> Project 。在左侧面板选 Maven ,确认JDK版本配置正确后点击 Next 。填写 GroupId 、 ArtifactId 等项目信息 ,点击 Next 。选择项目存储路径,点击 Finish 。
-
配置Maven依赖:打开项目的 pom.xml 文件,添加Spark相关依赖。基本依赖配置示例如下:
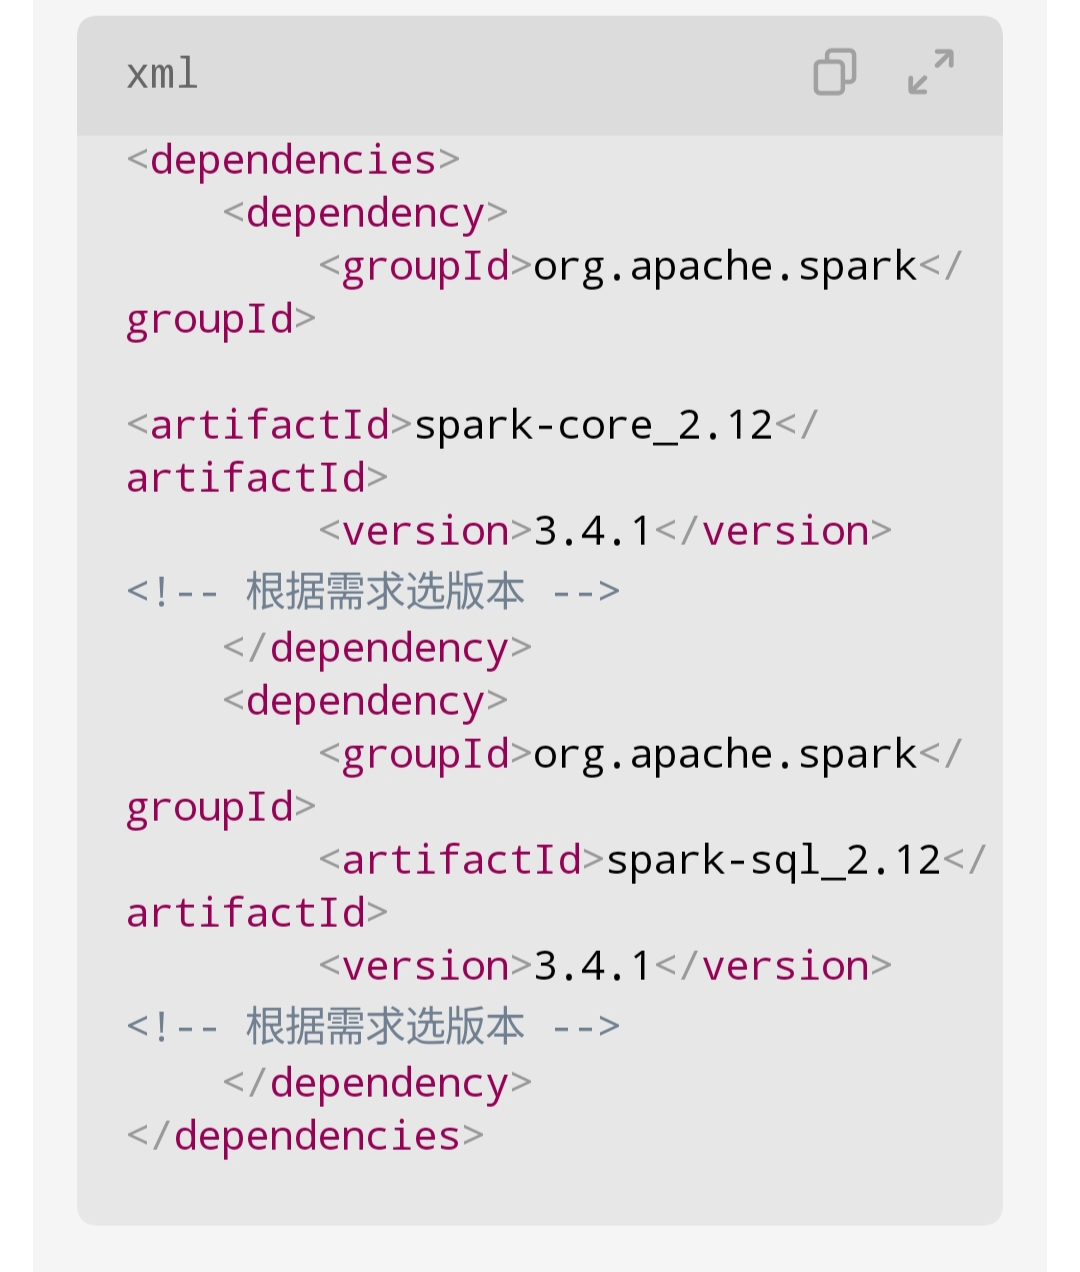
也可以按需添加 spark-streaming 等其他Spark模块依赖。
编写Spark程序
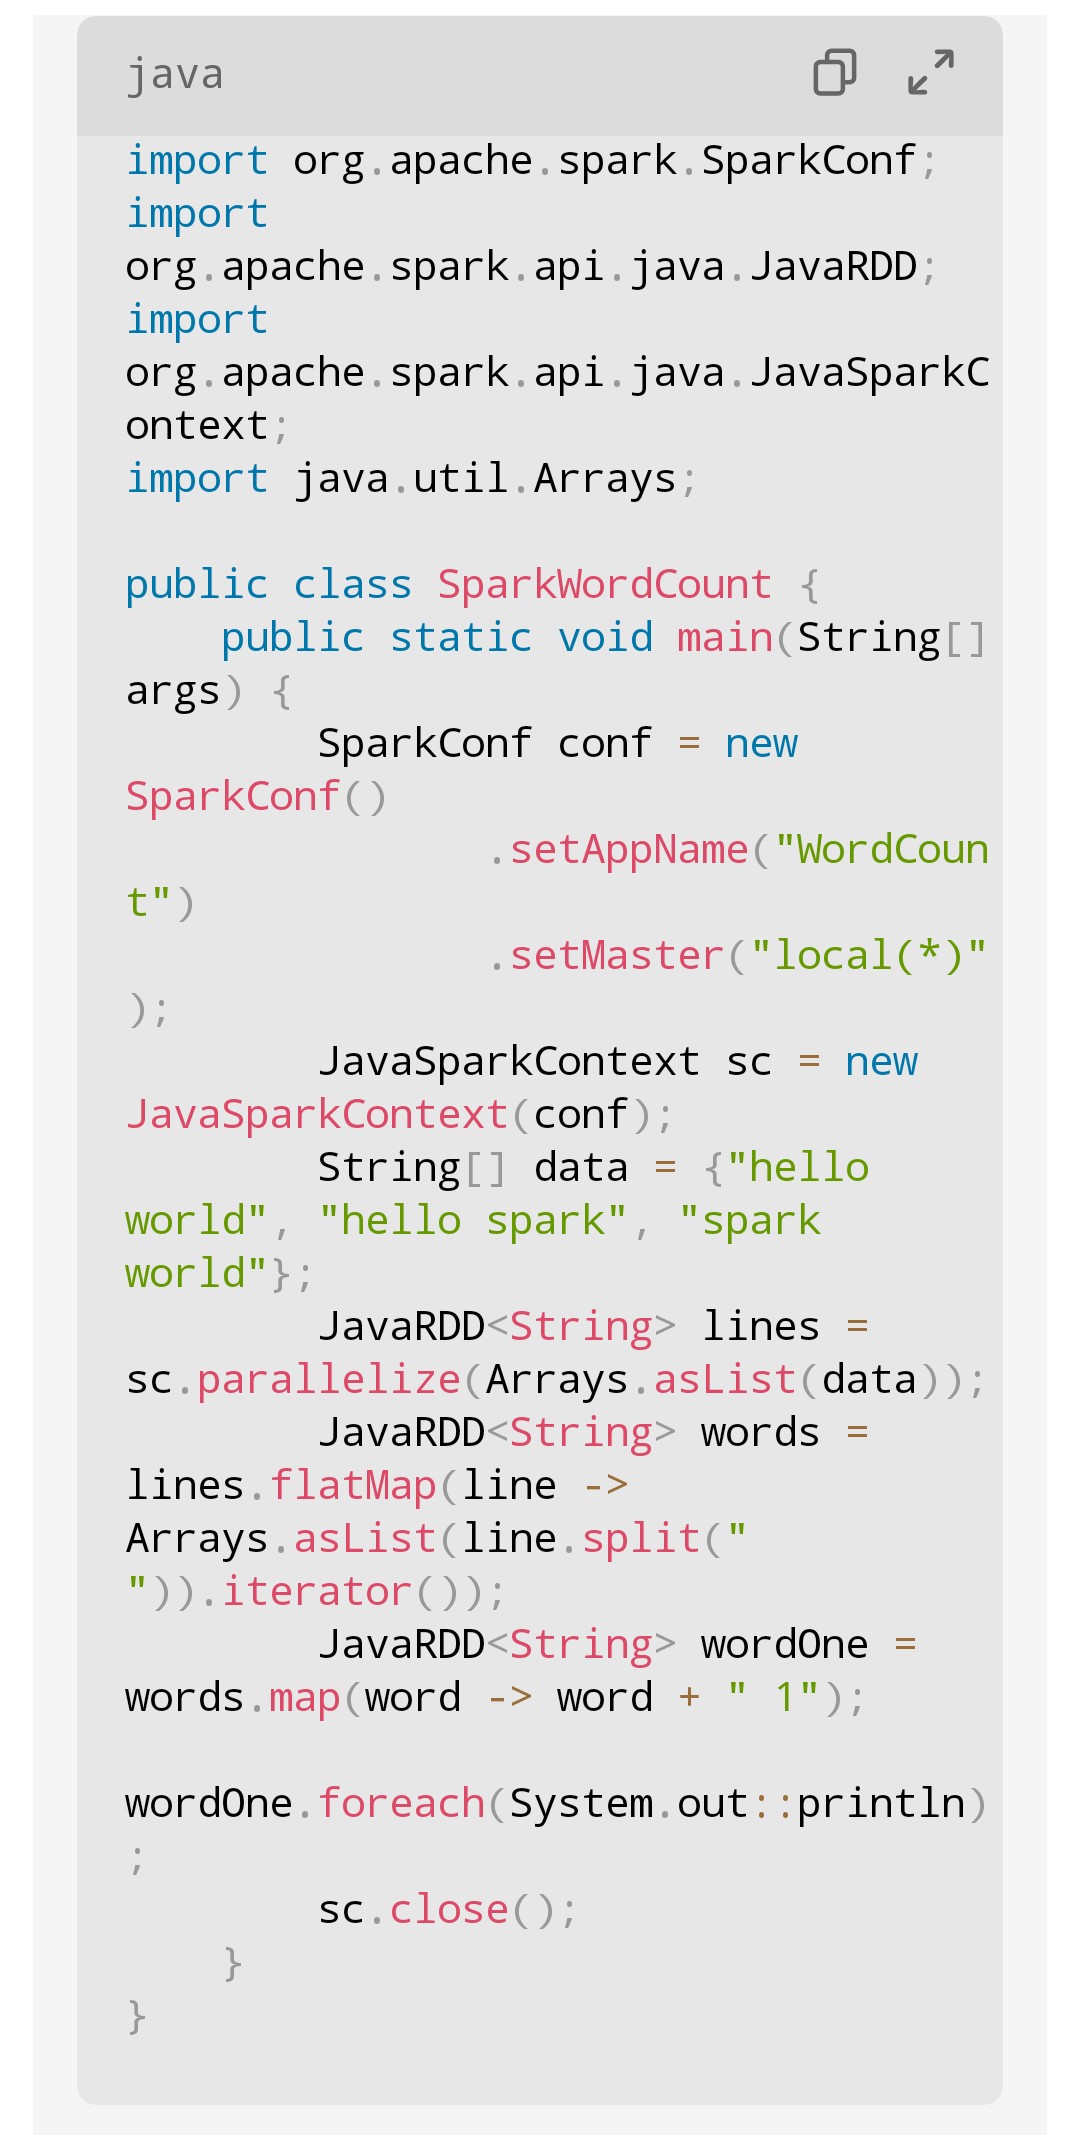
- 使用Java编写:在 src/main/java 目录下创建Java类,如 SparkWordCount.java 。示例代码如下:
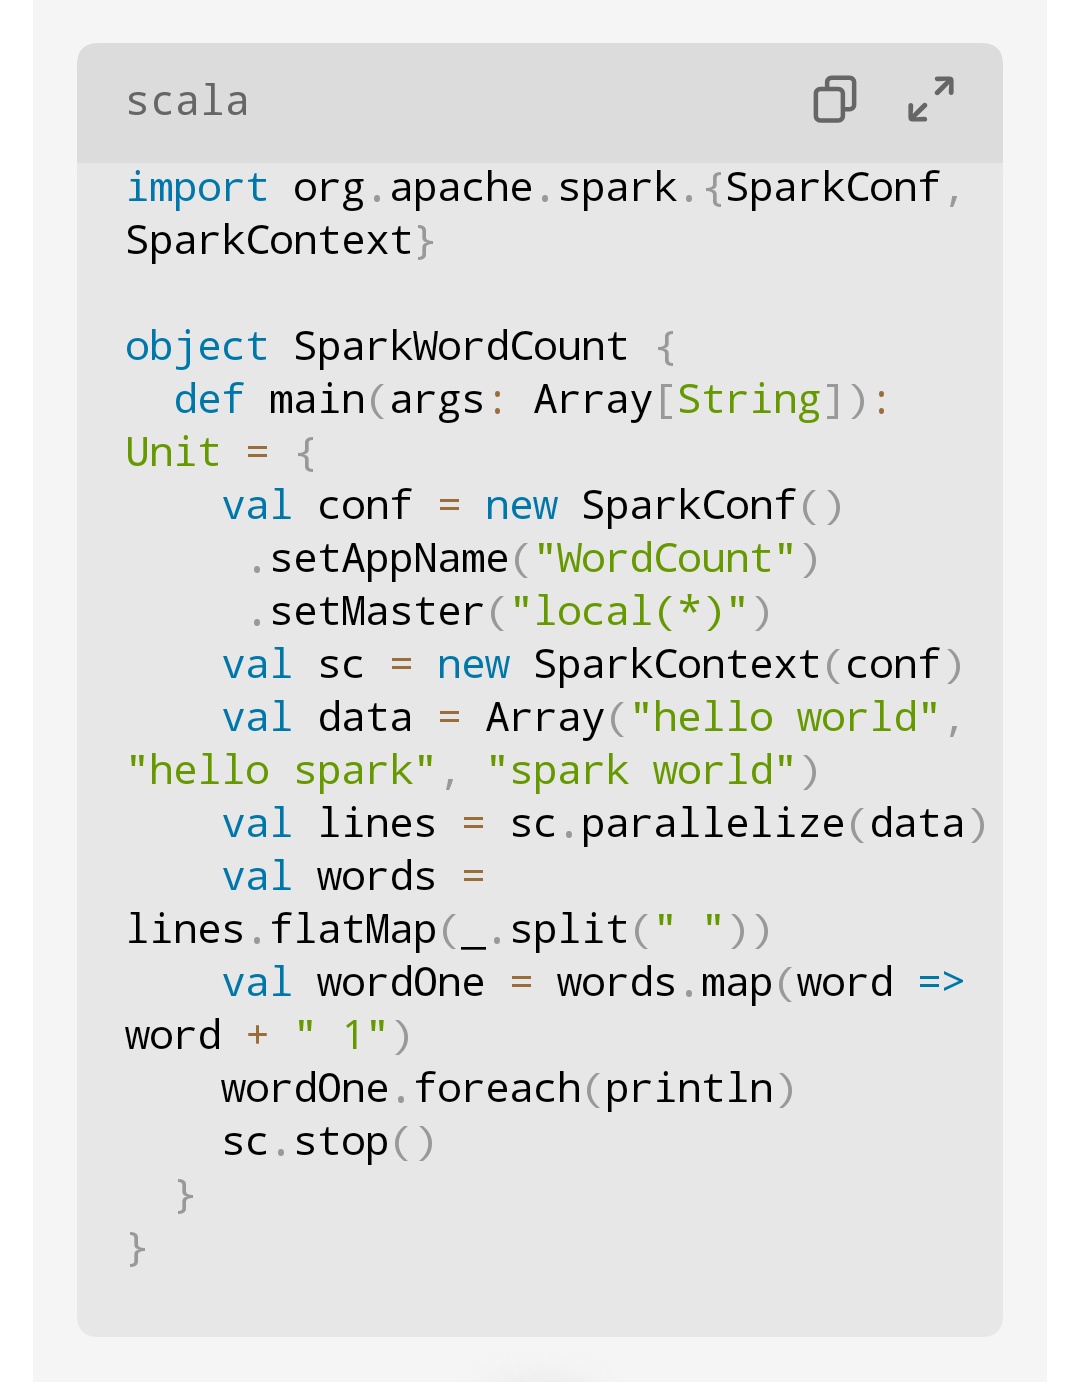
- 使用Scala编写:在 src/main/scala 目录下创建Scala类,如 SparkWordCount.scala 。示例代码如下:
运行Spark程序
-
本地模式运行:在IDEA中直接运行 main 方法,适合开发调试。
-
集群模式运行:在项目根目录执行 mvn clean package 将项目打包成JAR文件 。使用 spark-submit 命令提交到Spark集群运行,如 spark-submit --class com.example.SparkWordCount --master yarn --deploy-mode cluster /path/to/your/jarfile.jar ,需根据实际调整 --master 、 --deploy-mode 等参数 。
注意事项
-
确保代码中 textFile 等方法涉及的文件路径在本地或HDFS中存在。
-
集群模式运行时,合理调整 spark-submit 命令参数,如 --executor-memory (执行器内存) 、 --executor-cores (执行器核心数) 。