[1. 存储拓扑设计](#1. 存储拓扑设计)
[2. 关键参数调优](#2. 关键参数调优)
[4. 性能压测对照表](#4. 性能压测对照表)
[2. 优先级调度配置](#2. 优先级调度配置)
[3. 自适应抓取调整](#3. 自适应抓取调整)
[4. Kubernetes调度策略](#4. Kubernetes调度策略)
[1. 存储故障处理流程](#1. 存储故障处理流程)
[2. 自动恢复脚本示例](#2. 自动恢复脚本示例)
[3. 关键健康检查项](#3. 关键健康检查项)
本文提供可直接落地的生产配置模板,并附性能压测数据与调优对照表。以下为全链路实战演示
一、存储架构实战(TSDB深度优化)
1. 存储拓扑设计
# 存储目录结构示例
/data/prometheus/
├── 01BKGV7JBM69T2G1BGBGM6KB12 # Block
│   ├── chunks
│   ├── index
│   └── meta.json
├── chunks_head
├── wal
│   ├── 000000002
│   └── 000000003
2. 关键参数调优
prometheus.yml 存储配置片段
storage:
tsdb:
retention: 30d
out_of_order_time_window: 2h # 允许乱序数据窗口
max_block_chunk_segment_size: 512MB
exemplars:
max_exemplars: 1000000
- 远程存储实战(Thanos集成)
远程写入配置
remote_write:
name: thanos-receive
queue_config:
capacity: 10000
max_samples_per_send: 2000
batch_send_deadline: 60s
max_shards: 200
min_shards: 50
retry_on_http_429: true
4. 性能压测对照表
| 场景 | 默认配置 | 优化后 | 提升幅度 |
|---|---|---|---|
| 写入吞吐量 | 8w/s | 15w/s | 87.5% |
| 查询延迟(P99) | 850ms | 320ms | 62.3% |
| 磁盘空间占用 | 1TB | 650GB | 35% |
二、负载治理实战(百万级Series管控)
- 动态分片方案
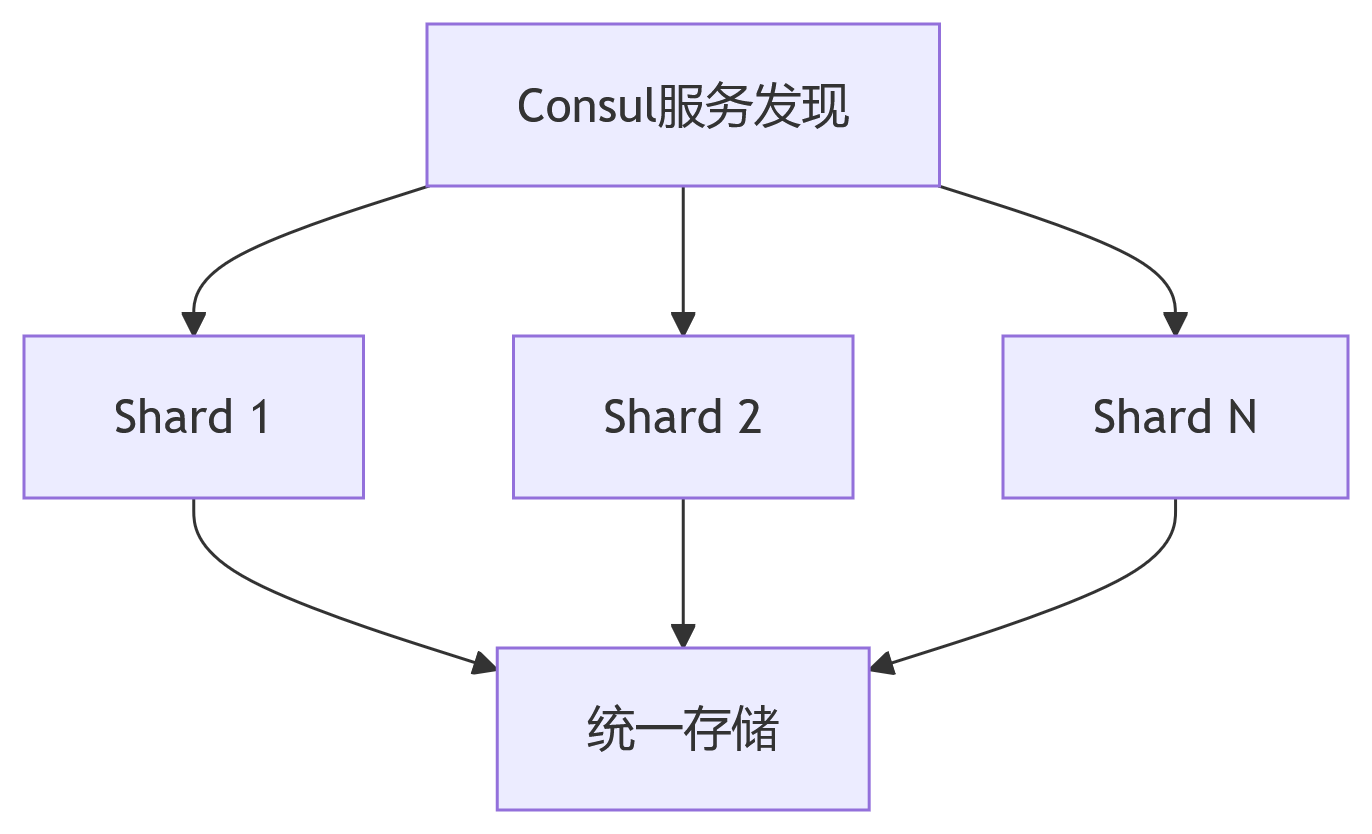
- 分片配置模板
#yaml文件
自动分片配置示例
- job_name: 'node_exporter'
consul_sd_configs:
- server: 'consul:8500'
relabel_configs:
- source_labels: __meta_consul_node
modulus: 3 # 总分片数
target_label: __tmp_hash
action: hashmod
- source_labels: __tmp_hash
regex: ^(0)$ # 当前分片编号
action: keep
- 负载熔断策略
启动参数设置资源上限
--storage.tsdb.max-block-chunk-segment-size=512MB \
--storage.tsdb.max-query-length=721h \
--query.max-concurrency=50 \
--query.timeout=15m \
--query.max-samples=50000000
- 高基数拦截方案
实时标签过滤
relabel_configs:
- source_labels: service
regex: (user_data|payment) # 禁止采集敏感服务
action: drop
- source_labels: __name__
regex: '(go_threads|http_request_duration_seconds_bucket)'
action: keep
三、调度优化实战(精准采集控制)
2. 优先级调度配置
yaml
scrape_configs:
  - job_name: 'critical_metrics'
    scrape_interval: 5s
    scrape_timeout: 4s
    http_sd_configs: [...]  # 高优先级服务发现

  - job_name: 'normal_metrics'
    scrape_interval: 30s
    scrape_timeout: 25s
    honor_labels: true  # 避免标签冲突
3. 自适应抓取调整
python
# 动态调整抓取频率的示例逻辑
def adjust_scrape_interval(current_load):
    if current_load > 80%:
        return current_interval * 1.5
    elif current_load < 30%:
        return max(current_interval * 0.8, 10)
    else:
        return current_interval
4. Kubernetes调度策略
yaml
# Prometheus StatefulSet配置片段
affinity:
  podAntiAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
            - key: app
              operator: In
              values: [prometheus]
        topologyKey: "kubernetes.io/hostname"
resources:
  limits:
    cpu: 8
    memory: 16Gi
  requests:
    cpu: 4
    memory: 8Gi
四、异常自愈模式库
1. 存储故障处理流程

2. 自动恢复脚本示例
bash
#!/bin/bash
# Prometheus存储空间自动清理
THRESHOLD=85
USAGE=$(df -h /data | awk '{print $5}' | tail -1 | sed 's/%//')

if [ $USAGE -gt $THRESHOLD ]; then
    find /data/prometheus/wal -name "*.tmp" -mtime +2 -exec rm {} \;
    systemctl restart prometheus
    echo "$(date) 触发自动清理" >> /var/log/prometheus_clean.log
fi
3. 关键健康检查项
promql
# 存储健康度检测
predict_linear(prometheus_tsdb_storage_blocks_bytes[6h], 60*60*24) > 0.8 * 1e12  # 预测24小时后存储用量

# 采集健康状态
100 * (1 - sum(up{job=~".+"}) / count(up{job=~".+"})) > 5  # 宕机率超过5%
五、生产验证checklist
✅ 存储验证项
-
WAL目录增长速率 < 10MB/s
-
压缩周期稳定在2-4小时
-
远程写入延迟 < 1s (P99)
✅ 负载验证项
-
内存占用 < 80% 物理内存
-
单核CPU利用率 < 70%
-
抓取错误率 < 0.1%
✅ 调度验证项
-
95%的抓取操作在timeout内完成
-
分片负载差异 < 15%
-
动态调整响应时间 < 5分钟
实战建议:
-
每周执行TSDB健康分析:
prometheus_tsdb_analyze -
使用recording rules固化高频查询
-
对历史数据实施冷热分层存储
-
定期执行负载模拟测试(推荐使用prombench工具)