运行Spark程序-在Idea中(二)

(四) 使用Maven创建新项目

核心的操作步骤如下:

1.启动idea,选择新建项目。
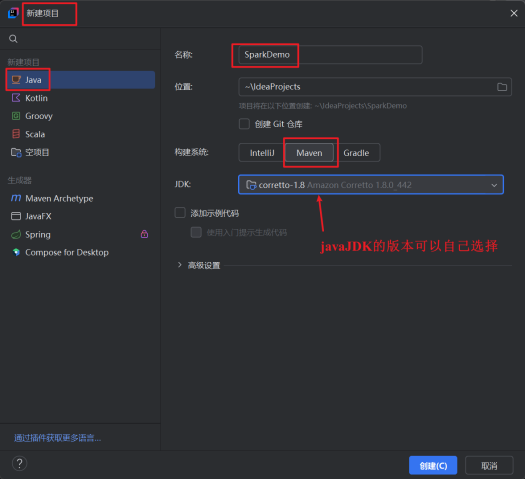
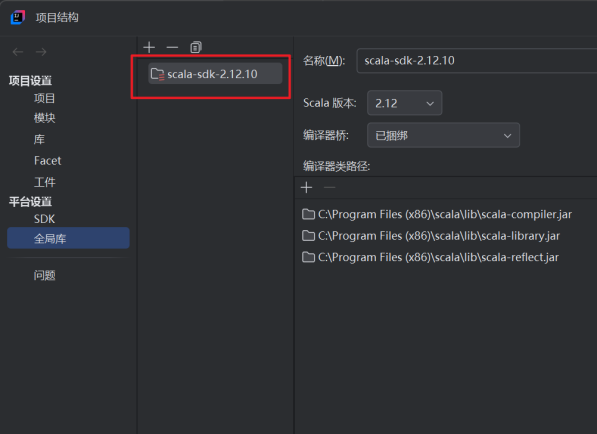
2.将Scala添加到全局库中。
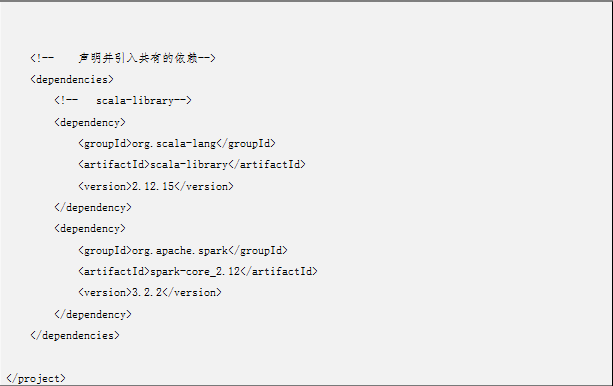
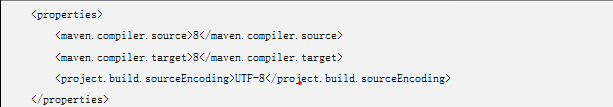
3.设置maven依赖项。修改pom.xml文件,添加如下:

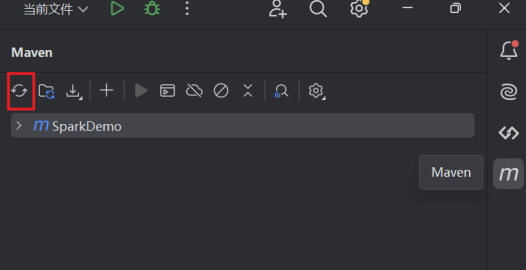
4.下载依赖。添加完成之后,刷新Maven,它会帮助我们去下载依赖。
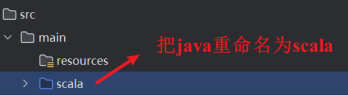
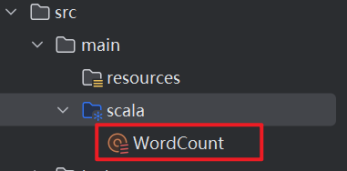
5.编写代码。修改文件夹的名字。
6.新建Scala类。如果这里没有看到Scala类的选项,就去检查第2步。
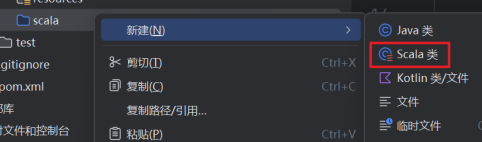
选择Object,输入WordCount

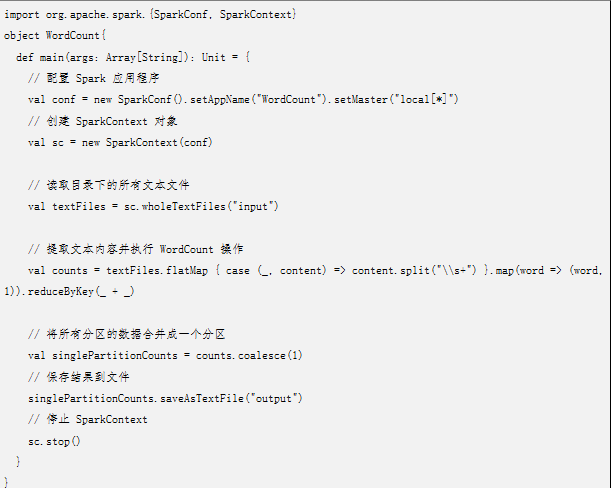
7.编写代码如下

它的功能是wordcount的功能:从指定的文件夹中去读取文件,并做词频统计。

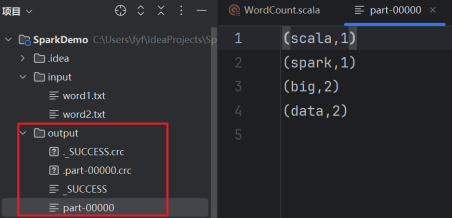
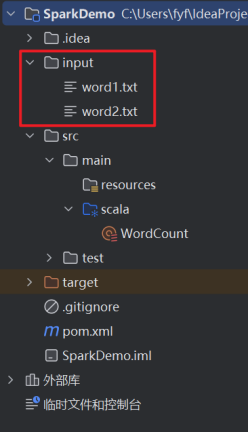
8.准备待统计的词频文件。在项目根目录下建立文件夹input,并穿件两个文本文件:word1.txt, word2.txt。如下图。

9.运行代码。点击运行代码。

10生成结果如上右图。

相关推荐
黑十10 小时前
FDE 怎么快速搭一个可演示页面?最小前端方案
java·大数据·前端·数据库·人工智能
Databend10 小时前
OpenRaft 自定义 Membership,按部署拓扑选择 Quorum
大数据·数据库·数据分析
Databend11 小时前
用 SQL 排查支付故障,OpenTelemetry 接入 Databend Cloud 实战
大数据·数据库·sql
上海潭龙东海科技有限公司11 小时前
智慧堆场动态模型三维实时孪生重构智能管控
大数据·网络·数据库·算法·重构
尹文祥12 小时前
Apache Doris 2.1.10:存储结构、索引与查询优化详解
大数据
isfox15 小时前
Hadoop 序列化:为什么不用 Java 自带 Serializable?
大数据
字节跳动数据平台16 小时前
火山引擎 VeKnow 落地指南(下):从知识编译到价值渗透
大数据
AI源码18 小时前
基于Spark的期刊推荐系统的设计与实现
大数据·分布式·spark
玩美数据18 小时前
海外市场数据分析驱动下的产业趋势演变与竞争格局深度解读
大数据·人工智能
wuyk5551 天前
Spider-第16讲-线程池与竞态问题
大数据·爬虫·python·elasticsearch·搜索引擎