一、先创一个order.csv文件
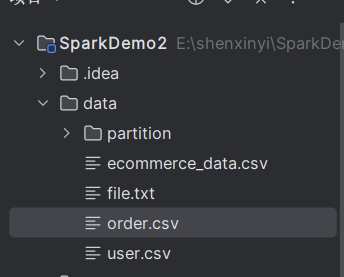
内容如下:
1,99,备注1
222,92,备注2
1101,99,备注1
232,392,备注2
2110,99,备注1
二、建一个scala的object类,代码如下
Scala
import org.apache.spark.{Partitioner, SparkConf, SparkContext}

// 创建一个类继承Partitioner
class OrderPartitioner extends Partitioner {

  override def numPartitions: Int = 2 // 两个分区,编号就是: 0, 1

  // key - value
  override def getPartition(key: Any): Int = {
// 如果key在2001和2003之间,就返回 0
// 否则,返回 1
val keyInt = key.asInstanceOf[Int]
    if (keyInt > 2000 && keyInt < 2003) {
      0
    } else {
      1
    }
  }
}

// case class
case class Order(id: Int, price: Double, category: String)

object PartitionOrder {
  def main(args: Array[String]): Unit = {
    // 创建SparkContext
    val conf = new SparkConf().setAppName("Partition").setMaster("local[*]")
    val sc = new SparkContext(conf)

    // 初始数据
    val rdd = sc.textFile("data/order.csv")

    val rdd1 = rdd.map(line => {
      val fields = line.split(",")
      (fields(0).toInt, Order(fields(0).toInt, fields(1).toDouble, fields(2)))
    })


    // 使用自定义分区器
    val rdd2 = rdd1.partitionBy(new OrderPartitioner)

    rdd2.map(x => x._2).saveAsTextFile("output18")

    val regionTotalAmount = rdd2.mapPartitions((iter) => {
      var count = 0
      var totalAmount = 0.0

      // 同时计算件数和总金额
      while (iter.hasNext) {
        val item = iter.next()
        count += 1
        val price = item._2.price
        println(price)
        totalAmount += price
      }

      Iterator(s"${count}件,$totalAmount")
    })

    // 在分区完成之后的基础上,只保留key
    //    val rdd3 = rdd2.map( x => x._2)

    regionTotalAmount.saveAsTextFile("output19")
  }
}