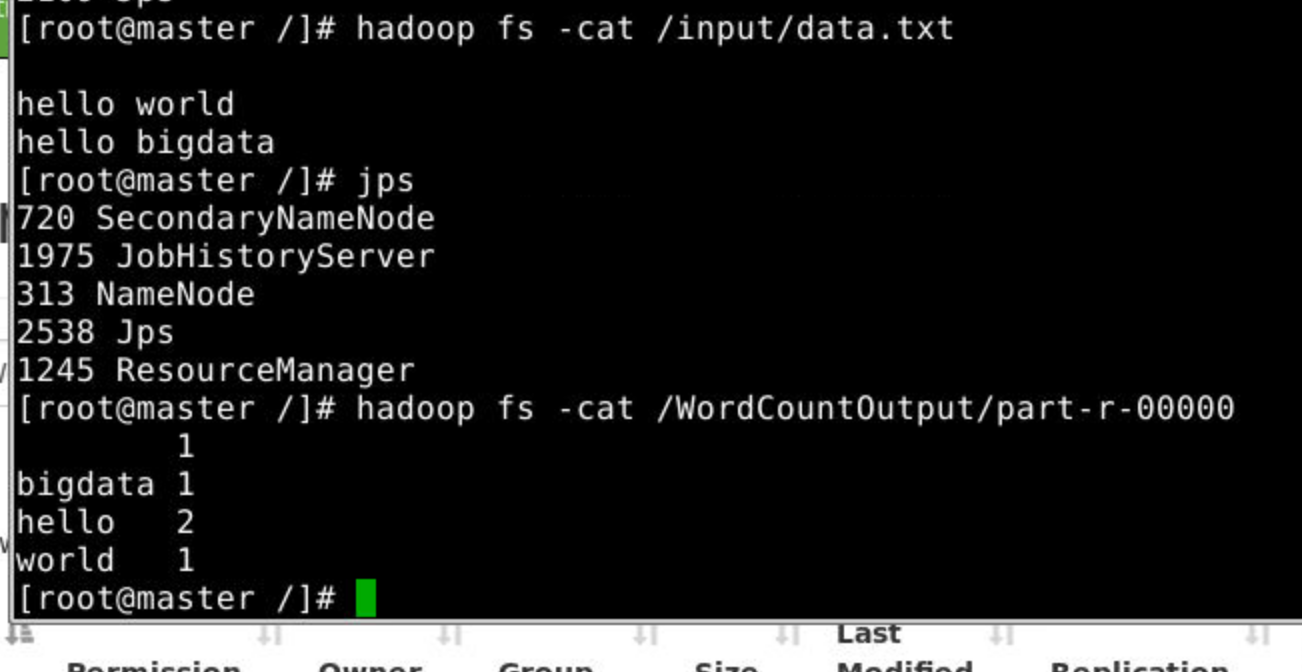
1.启动集群
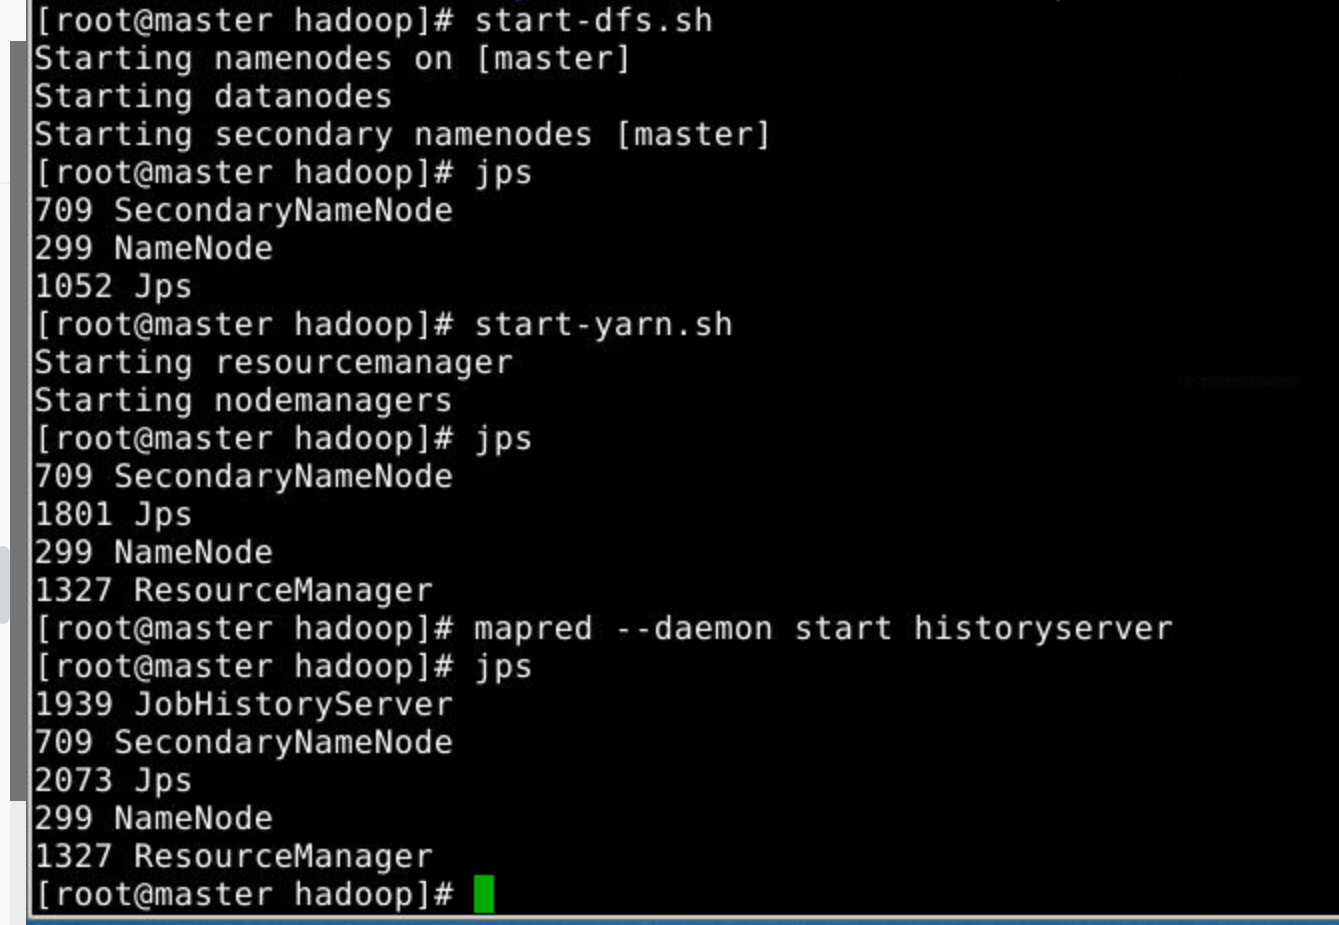
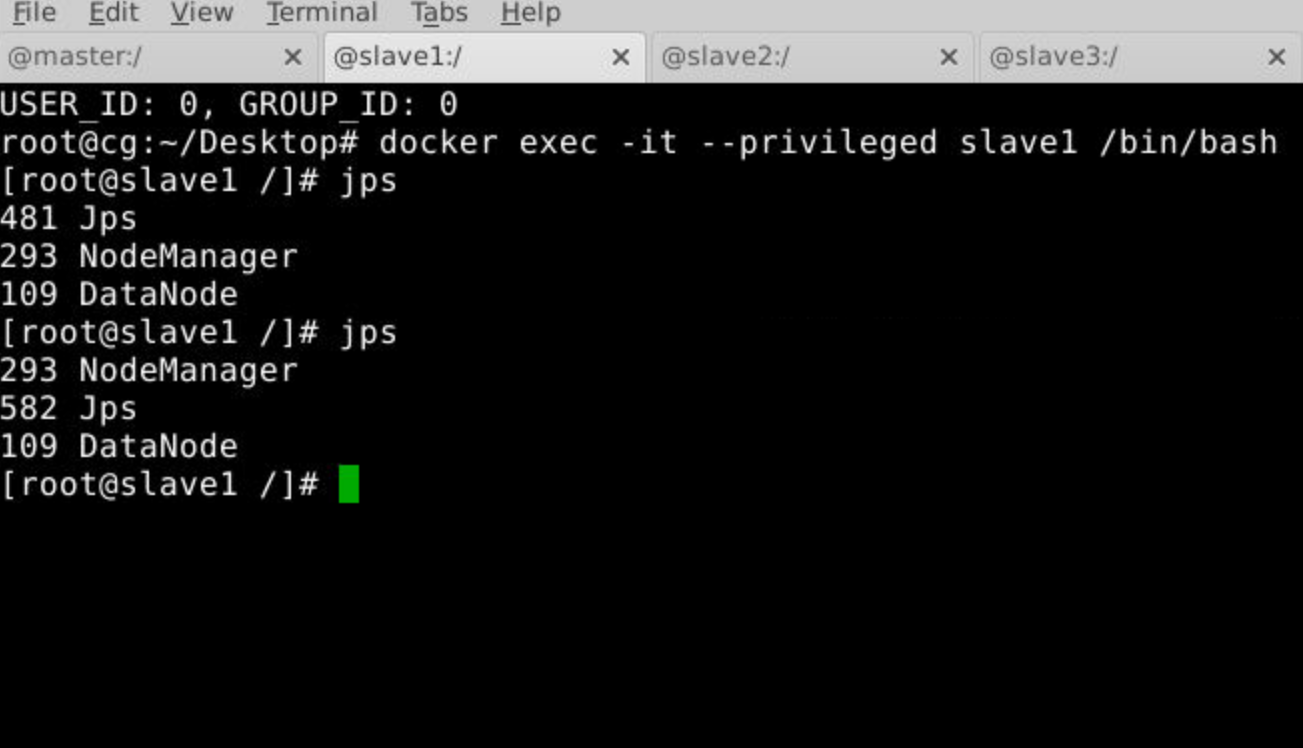
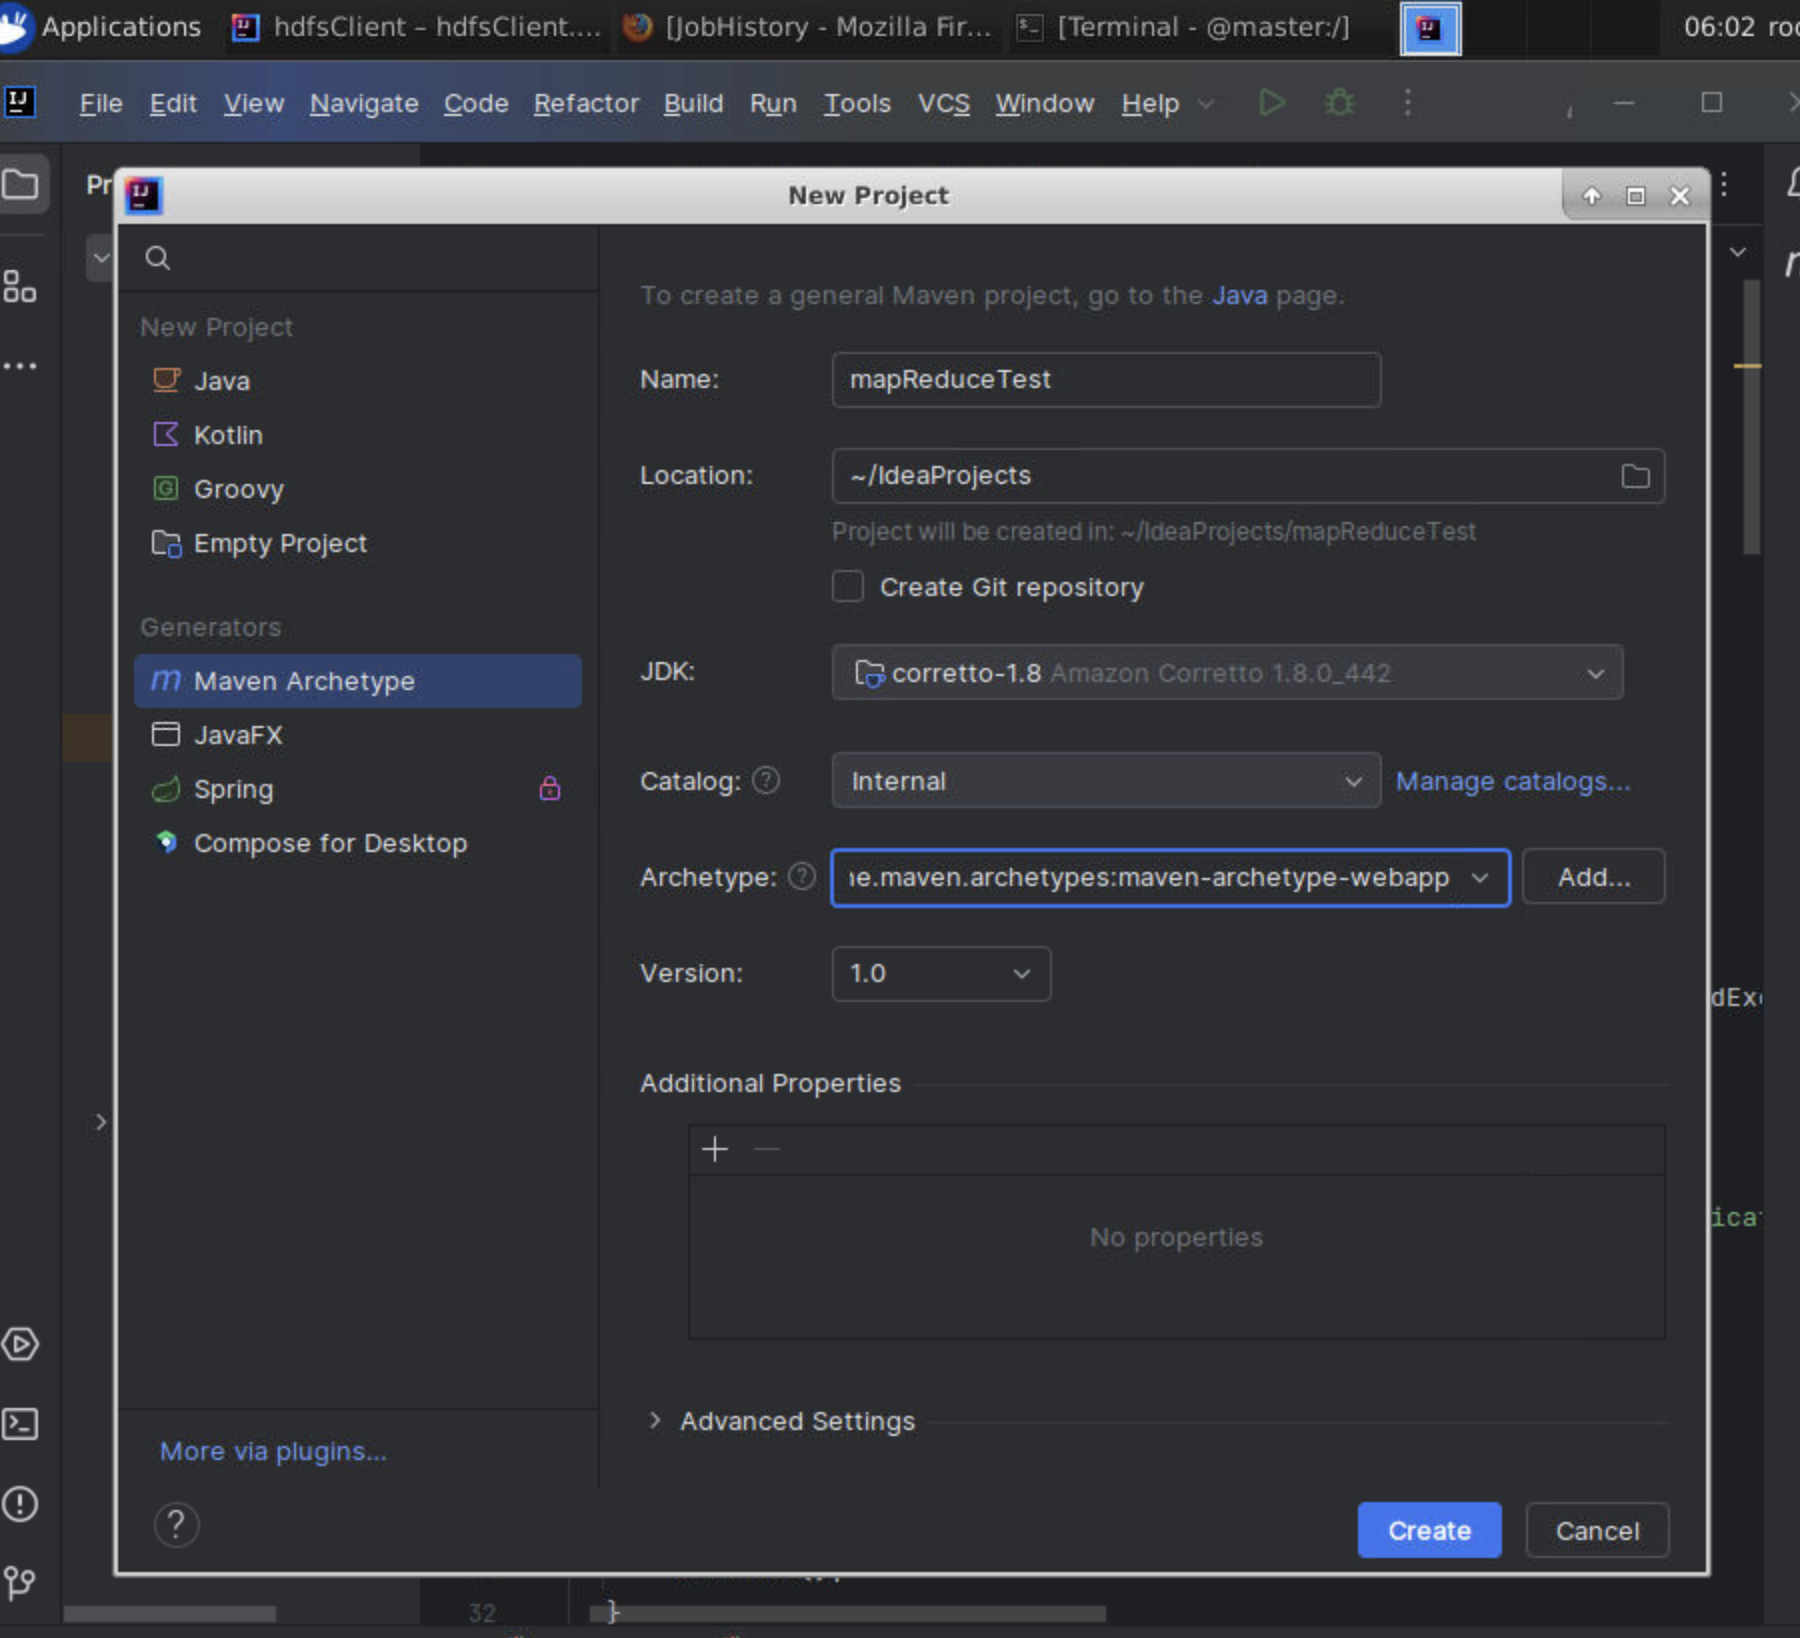
2.创建项目
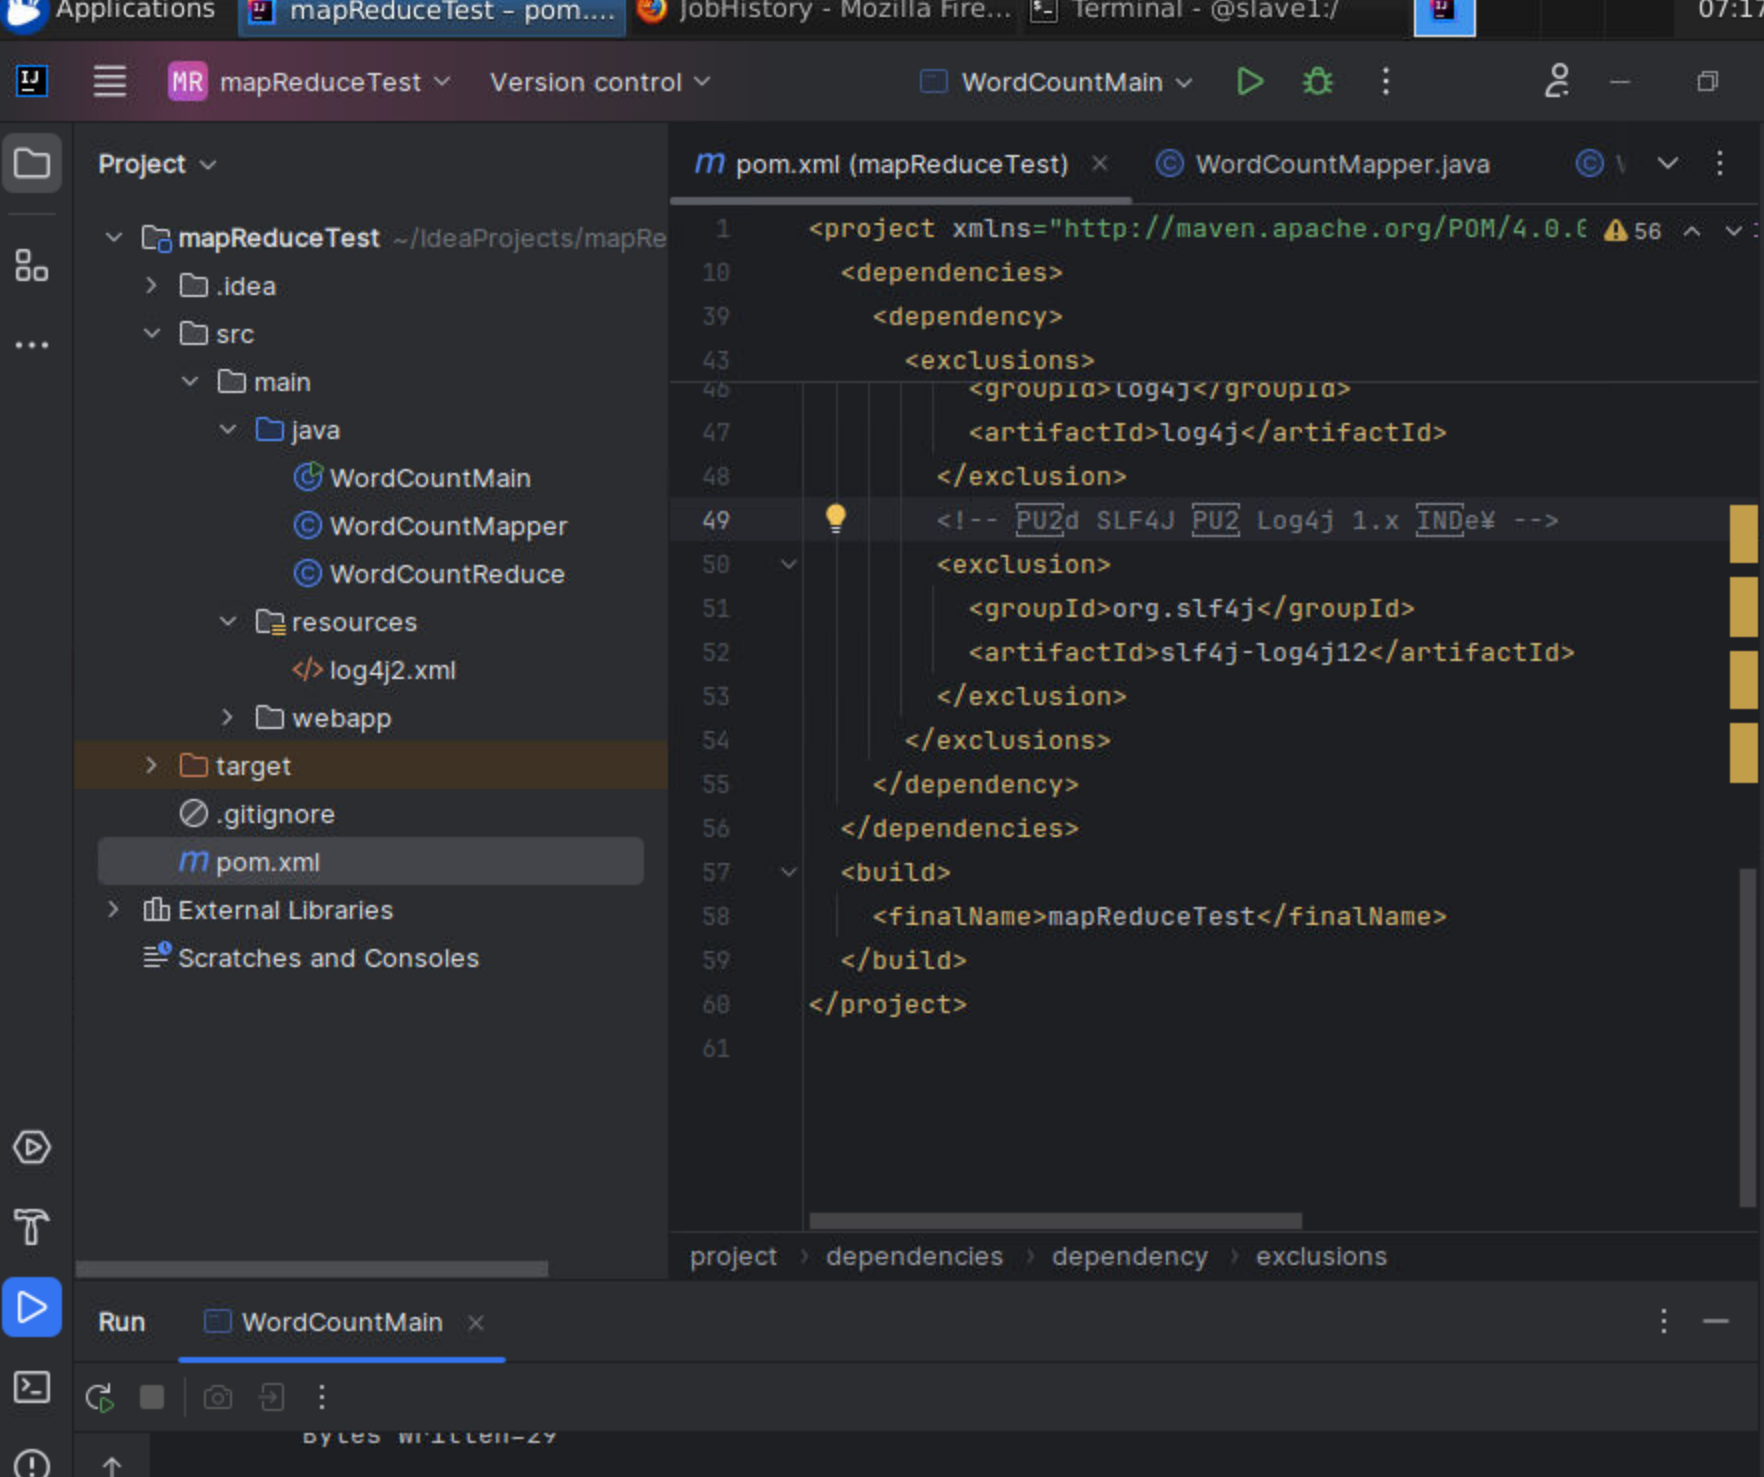
项目结构为:
3.pom.xml文件为
bash
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/maven-v4_0_0.xsd">
<modelVersion>4.0.0</modelVersion>
<groupId>org.example</groupId>
<artifactId>mapReduceTest</artifactId>
<packaging>war</packaging>
<version>1.0-SNAPSHOT</version>
<name>mapReduceTest Maven Webapp</name>
<url>http://maven.apache.org</url>
<dependencies>
<dependency>
<groupId>junit</groupId>
<artifactId>junit</artifactId>
<version>3.8.1</version>
<scope>test</scope>
</dependency>
<dependency>
<groupId>org.apache.logging.log4j</groupId>
<artifactId>log4j-slf4j-impl</artifactId>
<version>2.12.0</version>
</dependency>
<dependency>
<groupId>org.apache.hadoop</groupId>
<artifactId>hadoop-common</artifactId>
<version>3.1.3</version>
</dependency>
<dependency>
<groupId>org.apache.hadoop</groupId>
<artifactId>hadoop-hdfs</artifactId>
<version>3.1.3</version>
</dependency>
<dependency>
<groupId>org.apache.hadoop</groupId>
<artifactId>hadoop-mapreduce-client-core</artifactId>
<version>3.1.3</version>
</dependency>
<dependency>
<groupId>org.apache.hadoop</groupId>
<artifactId>hadoop-client</artifactId>
<version>3.1.3</version>
<exclusions>
<!-- d Log4j 1.x -->
<exclusion>
<groupId>log4j</groupId>
<artifactId>log4j</artifactId>
</exclusion>
<!-- d SLF4J Log4j 1.x e¥ -->
<exclusion>
<groupId>org.slf4j</groupId>
<artifactId>slf4j-log4j12</artifactId>
</exclusion>
</exclusions>
</dependency>
</dependencies>
<build>
<finalName>mapReduceTest</finalName>
</build>
</project>4.WordCountMapper代码为
java
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

public class WordCountMapper extends Mapper<LongWritable,Text,Text,IntWritable> {
    @Override
    protected void map(LongWritable key1,Text value1,Context context) throws IOException, InterruptedException {
        String data=value1.toString();
        String[] words=data.split(" ");
        for(String w:words){
            context.write(new Text(w),new IntWritable(1));
        }
    }

}
5.WordCountReduce代码为:
java
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

public class WordCountReduce extends Reducer<Text,IntWritable,Text,IntWritable> {
    @Override
    protected void reduce(Text k3,Iterable<IntWritable> v3,Context context) throws IOException, InterruptedException {
        int total=0;
        for(IntWritable v:v3){
            total+=v.get();
        }
        context.write(k3,new IntWritable(total));
    }
}
6.WordCountMain代码为:
java
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;
import org.apache.hadoop.mapreduce.Job;

public class WordCountMain {
    public static void main(String[] args) throws Exception {
        Job job = Job.getInstance(new Configuration());
        job.setJarByClass(WordCountMain.class);

        job.setMapperClass(WordCountMapper.class);
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(IntWritable.class);

        job.setReducerClass(WordCountReduce.class);
        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(IntWritable.class);

        FileInputFormat.setInputPaths(job, new Path("hdfs://172.18.0.2:9000/input"));
        FileOutputFormat.setOutputPath(job, new Path("hdfs://172.18.0.2:9000/WordCountOutput"));

        job.waitForCompletion(true);
    }
}
7.测试结果
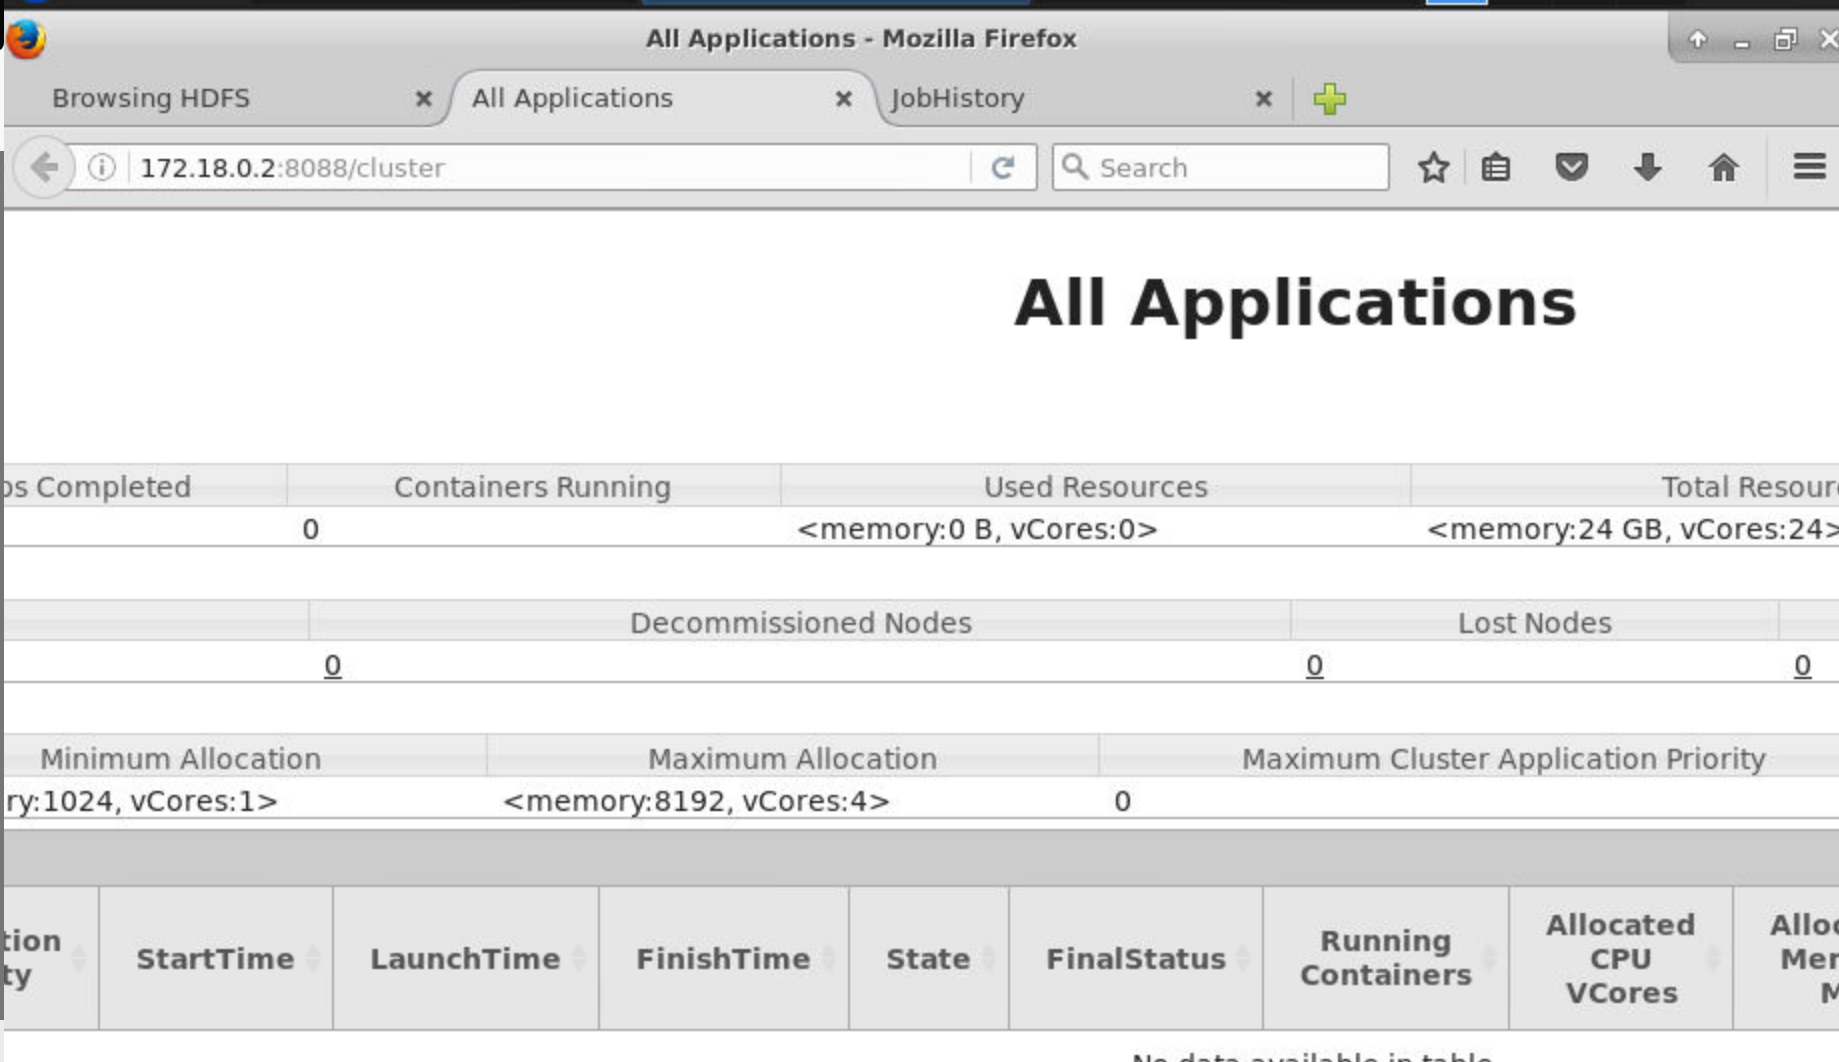
运行这个main,可以看到
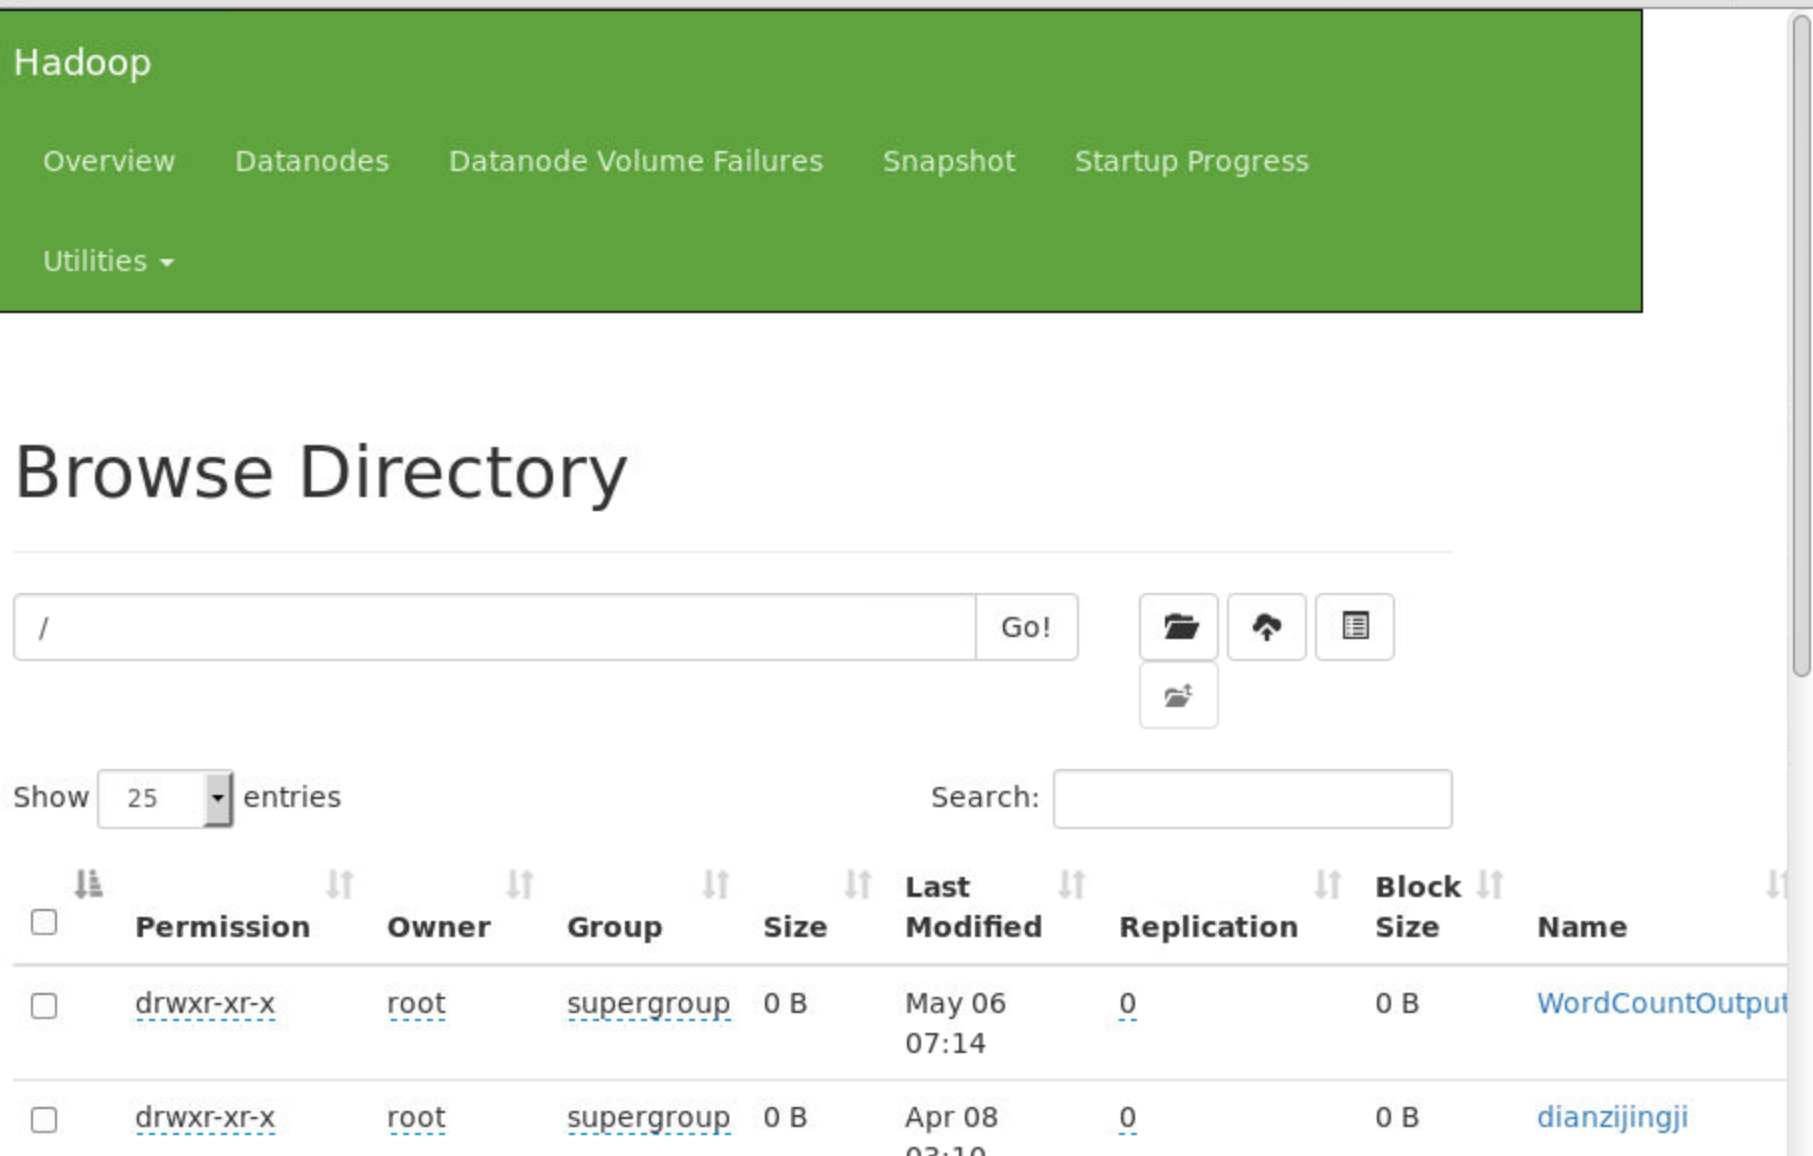
用shell脚本可以查看