目录
[1、Apache Kafka](#1、Apache Kafka)
[1.1、 kafka架构设](#1.1、 kafka架构设)
[3.1、 架构设计](#3.1、 架构设计)
前言
消息队列(Message Queue,简称 MQ)是一种用于在分布式系统中实现异步通信的技术。它提供了一个可靠的机制,可以在应用程序或服务之间传递消息,以提高系统的解耦性、可扩展性和容错能力。
如下图所示:

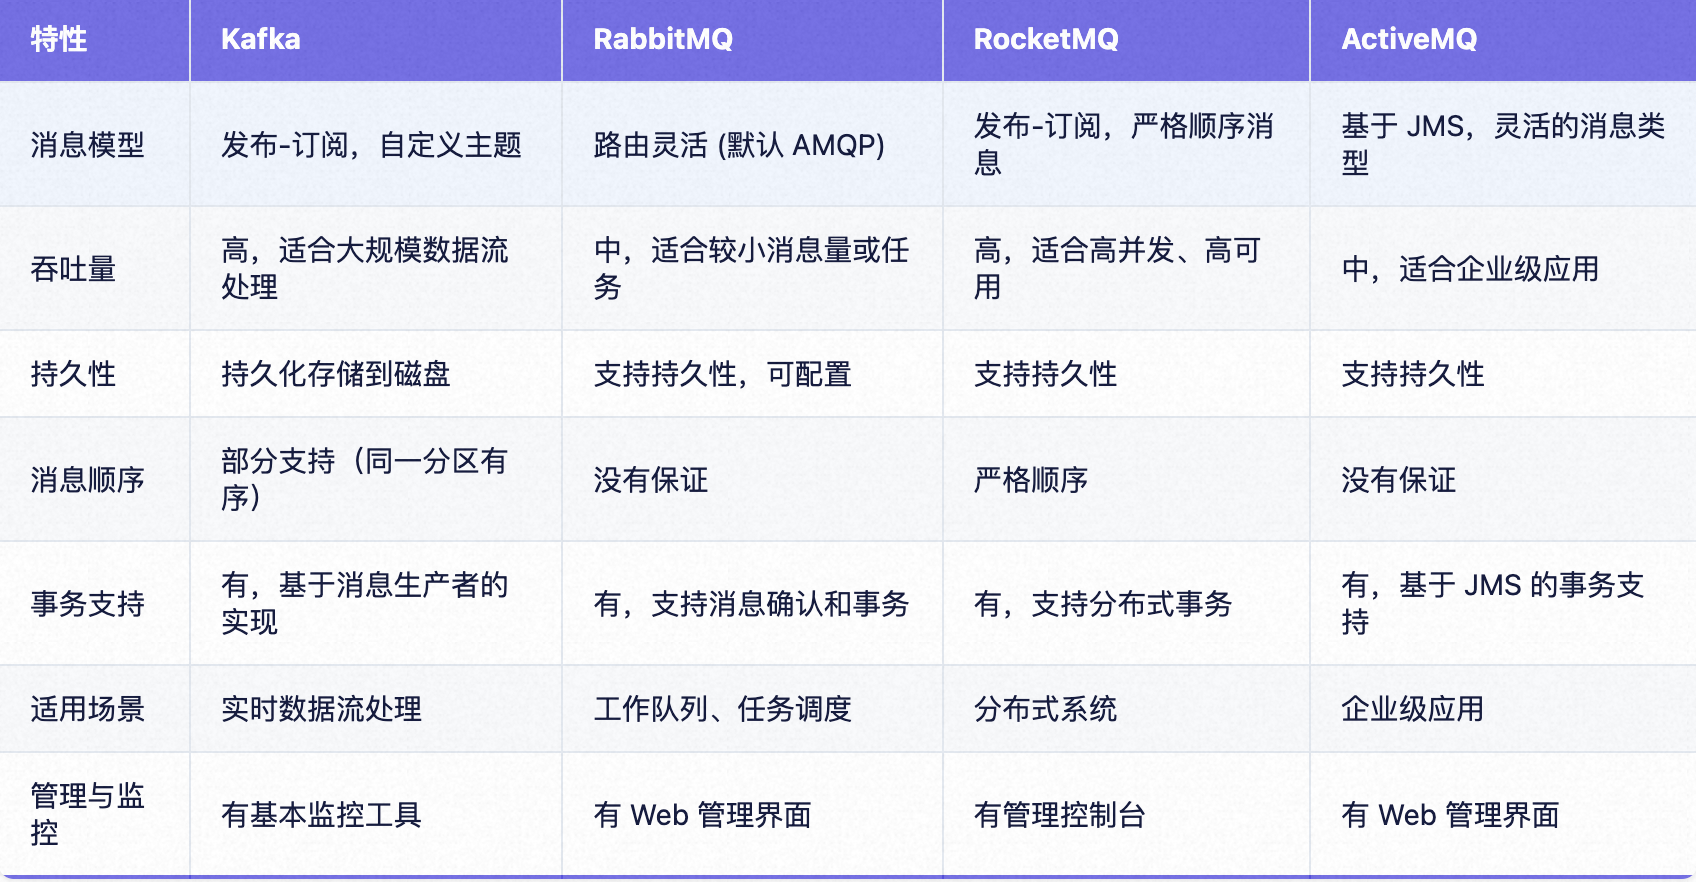
Apache Kafka、RabbitMQ、RocketMQ 和 ActiveMQ 是流行的消息队列解决方案,它们在架构设计、性能、特性和适用场景上各有不同。
如下图所示:

如上图可知:
Kafka 适合高吞吐量和流式数据处理,RabbitMQ 适合需要复杂路由和灵活性场景,RocketMQ 适用于高并发的应用场景,而 ActiveMQ 则适合企业级 Java 应用集成。
1、Apache Kafka
1.1、 kafka架构设计
kafka的架构设计如下图所示:

Kafka 的架构主要由以下几个组件组成:
1.Broker:
每个 Kafka 服务器实例称为 Broker。Kafka 集群中可以有多个 Broker。每个 Broker 负责存储一部分主题的分区数据。
2.主题(Topic):
Kafka 使用主题来组织消息。生产者可以将消息发送到特定的主题,而消费者可以从主题中消费消息。
3.分区(Partition):
每个主题可以划分为多个分区。分区是 Kafka 中实现并行处理的基本单位。不同的分区可以被分布在不同的 Broker 上以提高性能和可靠性。
4.消费者(Consumer):
消费者是从 Kafka 主题中读取消息的应用程序。多个消费者可以组成一个消费者组,共享一个主题的数据。
消息读取:
- 消费者可以通过订阅主题来接收消息。消费者可以设置其消费者组,这样同一组内的多个消费者可以共享处理主题的负载。
消费位移:
- 每个消费者在 Kafka 中维护自己的消费位移(offset),用于记录它已经消费到的位置。Kafka 允许消费者能够记录和管理自己的消费进度。
组管理:
- 在消费者组内,Kafka 会将各个分区的消息分配给不同的消费者。确保每个分区只能被组内一个消费者处理,避免重复消费。
5.生产者(Producer):
生产者是向 Kafka 主题发送消息的应用程序。生产者可以选择把消息发送到特定的分区。
消息发送:
- 当生产者发送消息时,首先计算消息的哈希值,以决定将消息发送到哪个分区。默认情况下,Kafka 使用轮询策略和关键字哈希来分配消息。
异步发送:
- 生产者可以选择异步发送消息,这样可以提升发送效率。Kafka 会在后台处理消息的生产,在网络性能允许的情况下,可以并行发送。
确认机制:
- 生产者可以配置确认等级(
acks),如:acks=0:不要求确认,速度最快。acks=1:主 Broker 确认(数据成功写入到领导者)。acks=all(或acks=-1):所有副本都成功确认,最高的可靠性。
6.Zookeeper:
Zookeeper 是 Kafka 的协调服务,用于管理分布式系统中的元数据,包括 Broker 的实例、主题、分区的状态等。
1.2、最大特点
高吞吐量:
Kafka 设计用于处理大量的事件流,支持高并发的消息生产和消费。其底层使用高效的磁盘 I/O 和数据压缩机制,保证了在大数据场景中的高效性。
1.3、功能介绍
1.分布式日志系统:
Kafka 可以被视作一个分布式的发布-订阅消息系统,广泛用于实时数据流处理。它通过持久化日志记录实现高效的消息存储。
2.架构设计:
它采用分区和复制机制,能够在多个服务器上并行处理,确保数据的可靠性和可用性。每个主题可以被划分为多个分区,并且每个分区在一个或多个 broker 上有副本。
关于更多broker的介绍如下图所示:

Kafka 集群由多个 Broker 组成,每个 Broker 存储一部分数据。集群中的所有 Broker 之间共享数据,实现了高可用性和负载均衡。生产者将消息发送给指定的主题,Broker 会将消息路由到正确的分区,同时分配给消费者。
3.消息顺序保证:
对于同一个分区(会有顺序),Kafka 保证消息的严格顺序,这对某些应用是很重要的,比如金融交易。
4.流处理:
Kafka Streams API 提供了流处理能力,使得用户可以轻松地在流数据上进行复杂的操作。
5.数据持久性
所有消息都持久地存储在磁盘上,并以分区的方式组织。
1.4、Broker数据共享
如下图所示:

假设我们有一个 Kafka Topic 叫 my-topic,其中有 3 个分区(P0, P1, P2),且在 3 个不同的 Broker 上有如下分布:
- Broker 1 (Leader for P0):
- P0 的领导者,保存消息,并异步通知其副本。
- Broker 2 (Leader for P1):
- P1 的领导者,并保存数据。
- Broker 3 (Leader for P2):
- P2 的领导者,处理数据流。
每当有生产者向 my-topic 发送消息,当前的领导者(如 Broker 1)会接收到这条数据。
Broker 之间的数据共享主要是通过副本机制实现的。虽然每个 Broker 存储了自己的一部分数据,Broker 之间的存储是逻辑上分割的, 通过一致的复制机制确保了各个 Broker 能够访问和保持数据的一致性。
下面详细解释这一机制。
1、领导者与追随者:
每个分区在 Kafka 中都有一个领导者(Leader)和多个追随者(Follower)。所有对该分区的读写请求都由领导者处理。
例如,假设有 my-topic 的分区 P0,服务于 P0 的 Broker 1 是领导者,而 Broker 2 和 Broker 3 是 P0 的追随者。
2、消息发送:
当一个生产者向主题发送消息时,这条消息首先发送到领导者 Broker(在这个例子中是 Broker 1)。
Broker 1 接收到消息后,会将该消息保存到其本地的日志中。
3、异步复制:
接收消息后,Broker 1 会异步地将该消息复制给它的追随者(Broker 2 和 Broker 3)。
追随者 Broker 在后台会定期向领导者发出请求以获取新消息。这种方式允许追随者在任何时间内保持最新的数据,通常会使用一些内部机制,比如发送"心跳"或使用"元数据"的结构,来确保它们知道领导者的状态。
4、确认机制:
追随者接收到消息后,会将其写入到本地存储。在大多数配置中,领导者会等待读取到指定数量的确认消息(例如,从追随者确认接收的数量),然后才会将这次写操作视为成功。这可以通过设置 acks 参数进行配置。
例如,设置 acks=all 可以确保所有的追随者都成功确认了消息之后,领导者才会认为消息被成功处理。
1.5、数据一致性
1、如果领导者失败:
如果 Broker 1(领导者)发生故障,Zookeeper 会感知到这一点,并进行领导者选举,选择其他的 Broker(如 Broker 2 或 Broker 3)作为新领导者。新领导者将能够继续处理请求,确保系统的高可用性。
2、数据的可用性:
通过这种设计,Kafka 确保了每个分区的数据一致性和可用性。即使某个 Broker 失败,只要其他 Broker 中有足够的副本可用,就可以恢复服务。
示例:
下面是一个简单的 Apache Kafka 代码示例,包括生产者和消费者的实现,展示如何使用 Kafka 在 Java 中发送和接收消息。
场景:简单聊天应用
在这个简单的聊天应用中:
- 生产者:用户输入的消息。
- 消费者:接收并显示来自其他用户的消息。
- Maven 依赖
首先,确保在 pom.xml 文件中包含 Kafka 的依赖:
java
<dependency>
    <groupId>org.apache.kafka</groupId>
    <artifactId>kafka-clients</artifactId>
    <version>3.5.1</version> <!-- 使用合适的版本 -->
</dependency>- Kafka 生产者示例
以下是生产者的代码示例,模拟用户发送消息到 Kafka 主题(聊天通道):
java
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerRecord;

import java.util.Properties;
import java.util.Scanner;

public class ChatProducer {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put("bootstrap.servers", "localhost:9092"); // Kafka broker 地址
        props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer");
        props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer");

        // 创建 Kafka 生产者
        KafkaProducer<String, String> producer = new KafkaProducer<>(props);
        Scanner scanner = new Scanner(System.in);

        System.out.println("请输入消息(输入 'exit' 退出):");

        // 发送消息
        while (true) {
            String message = scanner.nextLine();
            if ("exit".equalsIgnoreCase(message)) {
                break; // 退出
            }

            ProducerRecord<String, String> record = new ProducerRecord<>("chat-topic", message); // 发送到 "chat-topic"
            producer.send(record);
            System.out.println("发送消息: " + message);
        }

        // 关闭生产者
        producer.close();
        scanner.close();
    }
}- Kafka 消费者示例
以下是消费者的代码示例,模拟用户接收来自其他用户的消息:
java
import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.KafkaConsumer;

import java.time.Duration;
import java.util.Arrays;
import java.util.Properties;

public class ChatConsumer {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092"); // Kafka broker 地址
        props.put(ConsumerConfig.GROUP_ID_CONFIG, "chat-group"); // 消费者组ID
        props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringDeserializer");
        props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringDeserializer");

        // 创建 Kafka 消费者
        KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props);

        // 订阅主题
        consumer.subscribe(Arrays.asList("chat-topic"));

        System.out.println("开始接收消息...");

        // 持续拉取消息
        while (true) {
            for (ConsumerRecord<String, String> record : consumer.poll(Duration.ofMillis(100))) {
                System.out.printf("收到消息: %s%n", record.value());
            }
        }
    }
}-
运行与测试
-
启动 Kafka Broker :确保 Kafka 正在运行,并监听
localhost:9092。 -
创建主题 :运行以下命令创建
chat-topic主题(如果尚未创建的话): -
运行消费者 :首先启动
ChatConsumer代码来监听消息。 -
运行生产者 :随意运行
ChatProducer代码,开始测试输入和发送消息。输入 "exit" 将退出发送过程。
创建主题:
bash
kafka-topics.sh --create --topic chat-topic --bootstrap-server localhost:9092 --partitions 1 --replication-factor 1使用 Kafka 实现了一种基本的消息传递机制,允许用户输入消息并将其发送到 Kafka 主题同时从中接收消息。通过这种方式,我们可以观察到 Kafka 在处理实时消息传递中的功能。
使用场景
Kafka 适合用于实时分析、日志聚合、数据流处理、大数据和异步事件驱动的架构中。
2、RabbitMQ
RabbitMQ 是一个开源的消息代理软件,广泛用于构建企业级消息传递系统。它实现了高级消息队列协议(AMQP),提供了丰富的功能和灵活性,以满足不同的消息传递需求。
2.1、架构图
如下所示:

核心组件
1.Producer(生产者):
生成并发送消息到 RabbitMQ 的组件。生产者发布消息到交换机,而不是直接发到队列。
2.Exchange(交换机):
负责接收生产者发送的消息,并根据一定的路由规则将消息路由到一个或多个队列中。交换机类型决定了消息路由策略(如 Direct、Fanout、Topic、Headers)。
3.Queue(队列):
消息在 RabbitMQ 中存储的地方。消息被路由到一个或多个队列后,消费者可以从队列中获取消息进行处理。
4.Consumer(消费者):
从队列中接收并处理消息的组件。消费者可以对消息进行确认(ack),表明消息已被处理。
5.Bindings(绑定):
定义交换机和队列之间的关系,通过绑定键来定义消息的路由规则。
6.Virtual Hosts(虚拟主机):
提供逻辑隔离,使得多个应用可以安全地使用相同的 RabbitMQ 实例。
2.2、最大特点
灵活的消息路由:
RabbitMQ 基于 AMQP(Advanced Message Queuing Protocol)协议,支持多种消息传递模式,如直连、主题、发布-订阅等,具有强大的消息路由能力。
如下所示:

2.3、工作原理
工作原理如下所示:

1.消息发布 :
生产者将消息发送到指定的交换机,提供一个路由键以指出如何路由消息。
2.消息路由 :
交换机根据绑定键,将消息分发到一个或多个与其绑定的队列中。如果没有找到匹配的队列,消息可能被丢弃。
3.消息消费 :
消费者从队列中拉取消息进行处理。消费者可以通过自动或手动消息确认机制来确保消息已成功处理。
4.消息确认和重发 :
当消费者确认接收到消息后,RabbitMQ 从队列中删除消息。未确认的消息可以重发给其他消费者。
2.4、功能介绍
1、消息模型:
RabbitMQ 的消息传递机制支持复杂的路由逻辑。用户可以根据需要定义交换机(Exchange)和队列(Queue),然后制定路由规则,实现灵活的消息传递。
2、协议丰富:
除了 AMQP,RabbitMQ 还支持多种协议(如 STOMP、MQTT 和 HTTP),使其能够与多种客户端集成。
3、持久性与确认机制:
RabbitMQ 可以对消息进行持久化,确保消息不会因崩溃丢失。还提供了确认机制,使得生产者可以确保消息被消费者处理。
4、可扩展性:
RabbitMQ 支持集群配置,可以实现更高的吞吐量和弹性扩展。支持消息分区(通过 Virtual Hosts 和 Queue 分拆)以实现更高的隔离性和安全性。
5、管理界面:
提供了 Web 界面,方便用户查看消息队列的状态、队列的监控和管理。
使用场景
RabbitMQ 适用于需要复杂路由或任务队列功能的应用程序,如实时数据处理、工作流、异步处理和消息传递。
3、RocketMQ
3.1、 架构设计
如下图所示:

RocketMQ的架构主要由以下几个核心组件构成:
1.Producer(生产者):
消息的创建者,负责将消息发送到Broker。生产消息,将消息推送到指定的Topic中。
2.Consumer(消费者):
分为两种模式:Push 和Pull,分别主动获取和被动接收所需Topic的消息,负责从Broker处拉取消息并进行处理。
3.Broker:
消息的存储和转发者,负责接收、存储、发送和转发消息。Broker是RocketMQ系统的核心部分,可以设置为集群,以提高可用性和性能。并与Name Server保持同步以更新路由信息。
4.Name Server:
生产者和消费者通过Name Server获取Broker的地址。通常为无状态的,支持水平扩展,以提供可靠的路由信息服务。
5.Topic:
消息的逻辑分类,用作消息的路由和隔离。
3.2、工作原理
- 消息发送:生产者通过Name Server获取Broker的地址,并将消息发送到指定Topic的Broker。
- 消息存储:Broker接收到消息后,会将其存储到磁盘,并提供给Consumer拉取。
- 消息拉取:消费者通过Name Server获取到Broker的地址后,从Broker拉取指定Topic的消息。
- 消息消费:消费者在拉取到消息后根据业务逻辑进行处理。
3.3、最大特点
高可用与高并发 :
RocketMQ 设计用于支持高并发场景,能够提供高可用性和可靠的消息传递。
3.4、功能介绍
1.顺序消息支持:
RocketMQ 提供了严格的顺序消息处理能力,无论是在分发消息还是消费消息,都能够保证相同分组的消息按顺序处理。
如下图所示:

顺序消息原理
1.消息队列:
在RocketMQ中,一个Topic会分为多个消息队列(Queue)。消息的顺序是通过队列保证的。生产者在发送消息时,根据某种规则(如消息的key)将属于同一组的消息发送到同一个队列中。
2.单线程消费:
消费者从某个队列中按顺序拉取消息。为了保证顺序,该队列的消息通常会由消费者的同一线程处理。
3.消息发送策略:
生产者可以通过选择某种消息发送策略,将需要严格顺序处理的消息发送到同一个Queue,这通常通过消息中的业务key进行hash计算,然后选择一个具体的Queue。
4.故障恢复:
如果队列中的消息因为消费失败而需要重试,RocketMQ支持将消费失败的消息重新放回到队列的头部,从而保持顺序性。
2.水平扩展:
RocketMQ 采用分布式架构,允许通过增加更多的 broker 来扩展系统的吞吐能力。
3.多种协议支持:
支持广泛的协议,包括 JMS、HTTP、TCP 等,使得它更容易与其他系统集成。
4.监控和管理工具:
RocketMQ 提供了 Web 管理界面和监控工具,便于用户监测消息的状态和消费情况。
3.5、数据一致性
数据同步主要涉及到消息的复制和一致性问题,通常是通过主从复制(Master-Slave Replication)机制来实现。这种机制确保消息在不同 Broker 之间的一致性和可靠性。这是一种常见的实现可靠性和数据冗余的方式。以下是如何在 RocketMQ 中实现数据同步的细节:
1、主从复制机制
如下图所示:

1、Master-Slave 架构:
RocketMQ 支持 Broker 的主从架构,每个主 Broker(Master)可以有一个或多个从 Broker(Slave)。消息首先写入主 Broker,然后异步或同步地复制到从 Broker。
1.同步过程分为以下两种:
同步复制(Synchronous Replication):
在主 Broker 上写入消息的同时,消息会被复制到从 Broker。只有当从 Broker 确认收到消息后,主 Broker 才认为写入成功。这种方式提供了更高的可靠性,但可能会影响性能。
异步复制(Asynchronous Replication):
主 Broker 在写入消息后立即返回成功,而不等待从 Broker 的确认。这种方式性能较好,但在主 Broker 故障时可能导致数据丢失。
2、事务消息
RocketMQ 支持事务消息,通过两阶段提交机制确保消息在生产者和消费者之间的一致性。
两阶段提交包括:预发送(半消息)和提交/回滚。生产者先发送半消息,执行本地事务后根据结果提交或回滚。这种机制确保消费者不会提前接收到未提交的消息,从而保证消息的一致性。
3、消息确认机制
RocketMQ 使用消费确认机制来保证消息一致性。消费者在处理消息后,发送确认(ACK)来告知 Broker 消息已被成功处理。如果消费者未能及时确认,消息可以重新投递,确保消息不丢失。
4、消息重试机制
消费者在处理消息失败时,RocketMQ提供重试机制,可以在配置中设定重试次数和重试间隔。通过自动重试,确保消息最终被成功处理或根据策略进行其他处理。
5、数据冗余和故障转移
如果主 Broker 出现故障,从 Broker 可以快速接管,提高系统的可用性。从 Broker 提供了数据冗余,可以在主 Broker 故障时继续提供消息服务。
6、幂等性设计
在消费端,设计幂等性可以确保即使消息被重复消费,也不会导致数据处理的错误或异常。幂等性通常通过请求唯一标识或去重复机制实现。
示例:Java 消费端幂等性实现
假设我们有一个订单处理系统,收到消息后需要更新订单状态。我们可以通过记录已处理的消息 ID 来实现幂等性。
步骤
-
使用唯一标识 :每条消息应该有一个唯一标识符(如
messageId)来区分是否已被处理。 -
存储已处理的消息 ID:可以使用数据库或内存存储来记录已处理的消息 ID。
-
检查重复处理:在处理消息之前,首先检查消息 ID 是否已经存在于记录中,如果存在则不再处理。
示例代码
下面是一个简单的 Java 代码示例,使用一个 Set 来存储已经处理的消息 ID。
java
import java.util.HashSet;
import java.util.Set;

public class OrderConsumer {

    // 模拟用来存储已处理的消息ID,可以替换为数据库或分布式缓存
    private static final Set<String> processedMessageIds = new HashSet<>();

    public static void main(String[] args) {
        // 示例消息
        Message message = new Message("12345", "Order123", "NewStatus");

        processMessage(message);
    }

    public static void processMessage(Message message) {
        // 检查消息ID是否已被处理
        if (isMessageProcessed(message.getId())) {
            System.out.println("Message ID " + message.getId() + " already processed.");
            return;
        }

        // 执行业务逻辑,例如更新订单状态
        updateOrderStatus(message.getOrderId(), message.getStatus());

        // 将消息ID标记为已处理
        markMessageAsProcessed(message.getId());
    }

    private static boolean isMessageProcessed(String messageId) {
        return processedMessageIds.contains(messageId);
    }

    private static void markMessageAsProcessed(String messageId) {
        processedMessageIds.add(messageId);
    }

    private static void updateOrderStatus(String orderId, String status) {
        // 执行更新操作(示例为输出)
        System.out.println("Updating order " + orderId + " to status " + status);
    }

    // 简单的消息类
    private static class Message {
        private final String id;
        private final String orderId;
        private final String status;

        public Message(String id, String orderId, String status) {
            this.id = id;
            this.orderId = orderId;
            this.status = status;
        }

        public String getId() {
            return id;
        }

        public String getOrderId() {
            return orderId;
        }

        public String getStatus() {
            return status;
        }
    }
}
建议使用数据库或分布式缓存(如 Redis)来存储已处理的消息 ID,以确保多实例部署时的一致性。对于持久化存储的消息 ID,可能需要设计定期清理的机制,以防止数据膨胀。
使用场景
RocketMQ 适用于大规模的分布式系统,特别是在需要高并发、高可用性和有序消息的场景中,如金融交易、日志收集等。
4、ActiveMQ
ActiveMQ 是由 Apache 软件基金会开发的一个开源消息中间件,支持多种消息传递协议,并且符合Java消息服务(JMS)规范。它是一个成熟的、具有高性能的消息代理,广泛应用于企业消息传递系统。
4.1、架构图
核心组件
1.Broker(消息代理):
负责接收、存储和转发消息。它在 ActiveMQ 中扮演核心角色,管理 Queues 和 Topics。
2.Producer(生产者):
负责创建并发送消息到指定的目的地(Queue/Topic)。ActiveMQ 生产者可以通过 JMS 接口创建。
3.Consumer(消费者):
从 Broker 的指定目的地接收并处理消息的组件。ActiveMQ 支持同步和异步消息消费。
4.Queue(队列):
点对点消息模型的基础组件,消息在队列中排队,多个消费者可以消费队列中的消息,但每个消息只能被一个消费者处理。
5.Topic(主题):
发布-订阅模式的基础组件,消息被发送到主题,所有订阅该主题的消费者都可以接收到消息。
4.2、工作原理
如下图所示:

1.消息生产 :
生产者将消息发送到 Broker 上的特定目的地(Queue 或 Topic),使用 JMS 提供的 API 处理。
2.消息持久化 :
根据配置,ActiveMQ 会将消息持久化存储,再交付给消费者。
3.消息消费 :
消费者从 Broker 获取消息,可以选择不同的模式(同步、异步、事务等)实现。
4.消息确认 :
消费者处理完消息后,发送确认信息给 Broker。未确认的消息可以重新投递。
4.3、最大特点
基于 JMS(Java Message Service) :
ActiveMQ 是一个实现了 JMS 标准的消息代理,能够提供标准的 Java 消息服务,适用于 Java EE 环境。
4.3、工作原理
1、消息生产 :
生产者将消息发送到 Broker 上的特定目的地(Queue 或 Topic),使用 JMS 提供的 API 处理。
2、消息持久化 :
根据配置,ActiveMQ 会将消息持久化存储,再交付给消费者。
3、消息消费 :
消费者从 Broker 获取消息,可以选择不同的模式(同步、异步、事务等)实现。
4、消息确认 :
消费者处理完消息后,发送确认信息给 Broker。未确认的消息可以重新投递。
4.4、功能介绍
多协议支持:
除了 JMS,ActiveMQ 还支持其他通讯协议(如 STOMP、AMQP 和 MQTT),可以与多种语言和平台的客户端兼容。
易于集成:
ActiveMQ 与 Spring 的集成非常简单,适合在企业应用中实现消息传递。
持久性和事务支持:
ActiveMQ 支持消息持久化,并在同一事务中支持多条消息的发送和确认。
管理控制台:
提供丰富的管理和监控功能,能够实时查看消息的状态和系统的性能。
使用场景
通常适用于企业级应用、异步处理和复杂工作流处理场景,尤其在 Java EE 环境中表现良好。
5、MQ特点
1.异步通信:
生产者和消费者之间的联系是松散耦合的,生产者无需等待消费者处理完消息,可以立即继续处理下一个任务。
2.缓冲机制:
消息队列提供了一个缓冲区,能够临时存储消息,从而使得系统能够平滑处理峰值数据流。
3.可靠性:
消息队列通常具备持久性,能够确保消息在传输过程中不丢失,提供重试机制。
4.解耦:
系统中的各个模块可以独立运行,降低了系统各部分之间的依赖性。
5.削峰
通过以上四种mq的介绍,可以对性能进行以下归纳。
总结:
参考文章: