内容来自黑马程序员
这里写目录标题
认识AI和大模型
- AI的发展
AI,人工智能(Artificial Intelligence),使机器能够像人类一样思考、学习和解决问题的技术。

- 大语言模型
我们所熟知的大模型 (Large Language Models, LLM),例如GP、DeepSeek底层都是采用Transformer神经网络模型。

- Transformer


大模型应用开发
模型部署方案对比

模型部署-云服务
国内知名的云服务平台都提供了全球知名的大模型的私有部署功能,甚至还提供了这些模型的API开发平台,无需部署就能提供。
| 云平台 | 公司 | 地址 |
|---|---|---|
| 阿里百炼 | 阿里巴巴 | https://bailian.console.aliyun.com |
| 干帆平台 | 百度 | https://console.bce.baidu.com/qianfan/overview |
| 腾讯TI平台 | 腾讯 | https://cloud.tencent.com/product/ti |
| SiliconCloud | 硅基流动 | https://siliconflow.cn/zh-cn/siliconcloud |
| 火山方舟-火山引擎 | 字节跳动 | https://www.volcengine.com/product/ark |
模型部署-本地部署
本地部署最简单的一种方案就是使用ollama,官网地址:https//ollama.com


调用大模型
以下是DeepSeek官方给出的一段API实例代码:
python
# Please install OpenAI SDK first: `pip3 install openai`

from openai import OpenAI

client = OpenAI(api_key="<DeepSeek API Key>", base_url="https://api.deepseek.com")

response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "system", "content": "You are a helpful assistant"},
        {"role": "user", "content": "Hello"},
    ],
    stream=False
)

print(response.choices[0].message.content)
什么是大模型应用
传统应用和大模型应用
大模型应用是基于大模型的推理、分析、生成能力,结合传统编程能力,开发出的各种应用。

大模型应用
| 大模型 | 对话产品 | 公司 | 地址 |
|---|---|---|---|
| GPT-3.5、GPT-4o | ChatGPT | OpenAI | https://chatgpt.com/ |
| Claude 3.5 | Claude AI | Anthropic | https://claude.ai/chats |
| DeepSeek-R1 | DeepSeek | DeepSeek | https://www.deepseek.com/ |
| 文心大模型3.5 | 文心一言 | 百度 | https://yiyan.baidu.com/ |
| 星火3.5 | 讯飞星火 | 科大讯飞 | https://xinghuo.xfyun.cn/desk |
| Qwen-Max | 通义千问 | 阿里巴巴 | https://tongyi.aliyun.com/qianwen/ |
| Moonshoot | Kimi | 月之暗面 | https://kimi.moonshot.cn/ |
| Yi-Large | 零一万物 | 零一万物 | https://platform.lingyiwanwu.com/ |

大模型应用开发技术架构


SpringAI

对话机器人
快速入门
- 引入依赖
xml
<dependencyManagement>
	<dependencies>
		<dependency>
			<groupId>org.springframework.ai</groupId>
			<artifactId>spring-ai-bom</artifactId>
			<version>${spring-ai.version}</version>
			<type>pom</type>
			<scope>import</scope>
		</dependency>
	</dependencies>
</dependencyManagement>- 配置模型
yml
spring:
  ai:
    ollama:
      base-url: http://localhost:11434
      chat:
        model: deepseek-r1:7b
yml
spring:
  ai:
    openai:
      base-url: https://dashscope.aliyuncs.com/compatible-model
      api-key: ${OPENAI_API_KEY}
      chat:
        options:
          model: qwen-max # 模型名称
temperature: 0.8 # 模型温柔度,值越大,输出结果越随机- 配置客户端
java
   @Bean
   public ChatClient chatClient(OllamaChatModel model){
       return ChatClient.builder(model)
               .defaultSystem("你是可爱的助手,名字叫小团团")
               .build();
   }
java
 String content = chatClient.prompt()
          .user("你是谁?")
          .call()
          .content();

// 流式
Flux<String> content = chatClient.prompt()
           .user("你是谁?")
           .stream()
           .content();
会话日志
SpringAI利用了AOP原理提供了AI会话是的拦截、增强等功能,也就是Advisor。

java
@Bean
public ChatClient chatClient(OllamaChatModel model){
    return ChatClient.builder(model)   // 创建ChatClient工厂实例
            .defaultSystem("你是可爱的助手,名字叫小团团")
            .defaultAdvisors(new SimpleLoggerAdvisor()) // 配置日志Advisor
            .build(); // 构建ChatClient实例
}
会话记忆
大模型是具备记忆能力的,要想让大模型记住之前聊天的内容,唯一的办法就是把之前聊天的内容与新的提示词一起发给大模型。
python
from openai import OpenAI

#1.初始化OpenAI客户端
from openai import OpenAI

#1.初始化OpenAI客户端
client = OpenAI(
    api_key="<DeepSeek API Key>",
    base_url="https://api.deepseek.com")

#2.发送http请求到大模型
response = client.chat.completions.create(
    model="deepseek-r1",
    temperature=0.7,
    messages=[
        {"role":"system","content":"你是一个热心的AI助手,你的名字叫小团团"},
        {"role":"user","content":"你好,你是谁? "},
    ],
    stream=False
)
# 3.打印返回结果
print(response.choices[o].message.content)
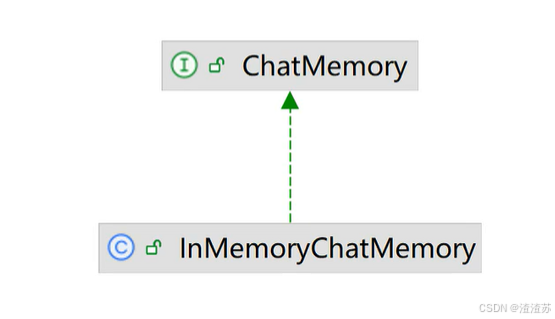
- 定义会话存储方式
java
 public interface ChatMemory {
     void add(String conversationId, List<Message> messages);

     List<Message> get(String conversationId, int lastN);

     void clear(String conversationId);
 }
java
   @Bean
   public ChatMemory chatMemory(){
       return new InMemoryChatMemory();
}- 配置会话记忆
java
 @Bean
 public ChatClient chatClient(OllamaChatModel model){
     return ChatClient.builder(model)
             .defaultSystem("你是可爱的助手,名字叫小团团")
             .defaultAdvisors(
                     new SimpleLoggerAdvisor(),
                     new MessageChatMemoryAdvisor(chatMemory())
             )
             .build();
}- 添加会话id
java
Flux<String> content = chatclient.prompt()
    .user("你好,我叫小明")
    .advisors(a -> a.param(CHAT_MEMORY_CONVERSATION_ID_KEY, chatId))
    .stream()
    .content();
添加会话id到AdvisorContext上下文中