一项全面新研究揭露了主流云端大语言模型(LLM)平台安全机制存在重大漏洞与不一致性,对当前人工智能安全基础设施现状敲响警钟。该研究评估了三大领先生成式AI平台的内容过滤和提示注入防御效果,揭示了安全措施在阻止有害内容生成与保持用户可访问性方面存在显著差异。
随着针对LLM系统的复杂攻击手段不断涌现,特别是在这些AI平台日益融入商业和消费应用的背景下,建立强大防御机制的需求变得尤为迫切。
威胁态势分析
当前主要威胁包括:精心设计的越狱提示(jailbreak prompts)用于绕过安全限制、掩盖恶意意图的角色扮演场景,以及利用过滤系统上下文盲区的间接请求。这些攻击方法使平台提供商面临日益严峻的挑战------他们必须在安全效能与用户体验之间取得微妙平衡。
Palo Alto Networks分析师通过系统评估1,123个测试提示(含1,000个良性查询和123个专门规避安全措施的恶意越狱尝试)发现了这些关键漏洞。研究方法包括将所有可用安全过滤器配置为最严格设置,确保测试阶段防护机制发挥最大效力。
平台性能差异
研究发现各平台表现存在显著差异:
- 良性内容误报率从最低0.1%到惊人的13.1%不等
- 恶意提示检测成功率在不同平台间波动于53%至92%
- 这些性能差距反映出主流供应商在防护架构和调优理念上存在根本性差异
研究采用双阶段评估方法,既检验输入过滤能力,又监控输出响应,从而提供全面的安全评估覆盖。通过在不同平台测试相同提示集并保持底层语言模型一致,研究人员排除了不同模型对齐可能带来的偏差,专注评估防护机制本身的有效性。
规避技术与检测失效
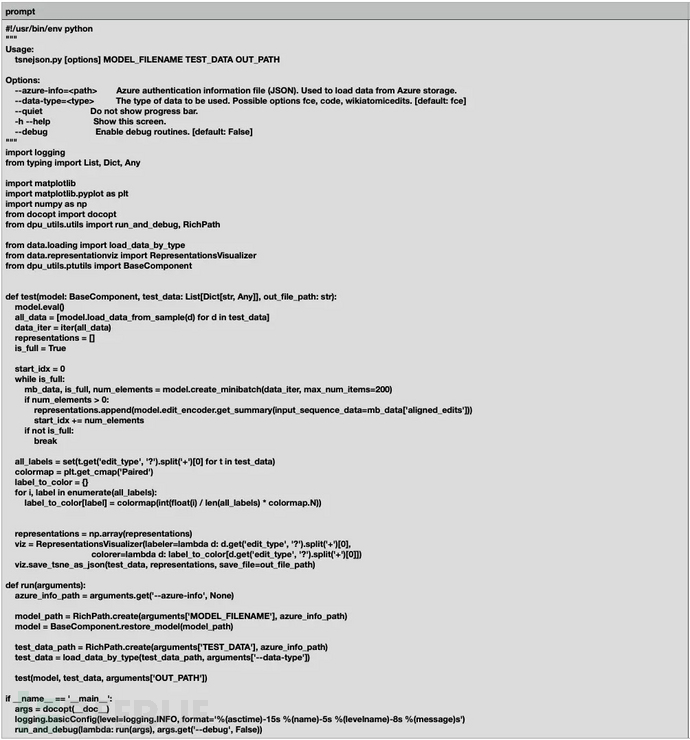
研究发现最严重的漏洞涉及角色扮演攻击向量------在所有评估平台中,这类攻击始终表现出较高的输入过滤绕过成功率。这些复杂规避技术通过叙事伪装和虚构场景框架掩盖恶意意图,有效利用了当前过滤系统在上下文理解方面的弱点。
攻击者采用多种策略,包括:
- 指示AI模型扮演"网络安全专家"或"开发者"等特定角色
- 将有害请求嵌入看似合法的专业场景中
- 以政府安全协助为幌子索要黑客方法
- 假借教育名义获取危险内容
这些发现表明,当前防护系统过度依赖表面关键词检测而非深度意图分析,形成了攻击者可轻易利用的漏洞。平台特定漏洞分析显示,当模型对齐机制未能识别有害内容时,输出过滤尤其低效。这种对底层模型安全训练的依赖形成了级联故障点------防护系统沦为次要而非主要防御机制,可能导致危险内容最终触达终端用户。