数据加载与保存:
通用方式:
SparkSQL 提供了通用的保存数据和数据加载的方式。这里的通用指的是使用相同的API,根据不同的参数读取和保存不同格式的数据,SparkSQL 默认读取和保存的文件格式为parquet
加载数据:
spark.read.load 是加载数据的通用方法。如果读取不同格式的数据,可以对不同的数据格式进行设定。
spark.read.format("...").option("...").load("...")
➢ format("..."):指定加载的数据类型,包括"csv"、"jdbc"、"json"、"orc"、"parquet"和
"textFile"。
➢ load("..."):在"csv"、"jdbc"、"json"、"orc"、"parquet"和"textFile"格式下需要传入加载
数据的路径。
➢ option("..."):在"jdbc"格式下需要传入 JDBC 相应参数,url、user、password 和 dbtable
我们前面都是使用 read API 先把文件加载到 DataFrame 然后再查询,其实,我们也可以直接在文件上进行查询: 文件格式.`文件路径`
spark.sql("select * from json.' Spark-SQL/input/user.json'").show
保存数据:
df.write.save 是保存数据的通用方法。如果保存不同格式的数据,可以对不同的数据格式进行设定。
df.write.format("...").option("...").save("...")
➢ format("..."):指定保存的数据类型,包括"csv"、"jdbc"、"json"、"orc"、"parquet"和
"textFile"。
➢ save ("..."):在"csv"、"orc"、"parquet"和"textFile"格式下需要传入保存数据的路径。
➢ option("..."):在"jdbc"格式下需要传入 JDBC 相应参数,url、user、password 和 dbtable
保存操作可以使用 SaveMode, 用来指明如何处理数据,使用 mode()方法来设置。
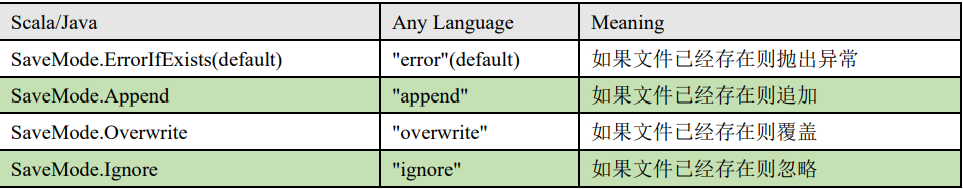
例如: df.write.mode("append").json("Spark-SQL/output")
Parquet
Spark SQL 的默认数据源为 Parquet 格式。Parquet 是一种能够有效存储嵌套数据的列式
存储格式。数据源为 Parquet 文件时,Spark SQL 可以方便的执行所有的操作,不需要使用 format。修改配置项 spark.sql.sources.default,可修改默认数据源格式。
加载数据:
val df = spark.read.load("examples/src/main/resources/users.parquet")
保存数据:
var df = spark.read.json("/opt/module/data/input/people.json")
df.write.mode("append").save("/opt/module/data/output")
JSON
Spark SQL 能够自动推测 JSON 数据集的结构,并将它加载为一个 DatasetRow. 可以
通过 SparkSession.read.json()去加载 JSON 文件。注意: Spark 读取的 JSON 文件不是传统的 JSON 文件,每一行都应该是一个 JSON 串
加载json文件
val path = "/opt/module/spark-local/people.json"
val peopleDF = spark.read.json(path)
创建临时表
peopleDF.createOrReplaceTempView("people")
数据查询
val res DF = spark.sql("SELECT name FROM people WHERE age BETWEEN 13 AND 19")
CSV
Spark SQL 可以配置 CSV 文件的列表信息,读取 CSV 文件,CSV 文件的第一行设置为
数据列。
spark.read.format("csv").option("sep",";").option("inferSchema","true")
.option("header", "true").load("data/user.csv")
MySQL
Spark SQL 可以通过 JDBC 从关系型数据库中读取数据的方式创建 DataFrame,通过对
DataFrame 一系列的计算后,还可以将数据再写回关系型数据库中。
IDEA通过JDBC对MySQL进行操作:
- 导入依赖
<dependency >
<groupId >mysql</groupId >
<artifactId >mysql-connector-java</artifactId >
<version >5.1.27</version >
</dependency >
MySQL8 <version>8.0.11</version>
- 读取数据
val sparkConf = new SparkConf().setMaster("local\*" ).setAppName("SQL" )
val spark:SparkSession = SparkSession.builder ().config(sparkConf).getOrCreate()
import spark.implicits._
// 通用的 load 方式读取
spark.read.format("jdbc" )
.option("url" ,"jdbc:mysql://localhost:3306/system" )
.option("driver" ,"com.mysql.jdbc.Driver" )//com.mysql.cj.jdbc.Driver
.option("user" ,"root" )
.option("password" ,"123456" )
.option("dbtable" ,"user" )
.load().show()
spark.stop()
// 通用的 load 方法的另一种形式
spark.read.format("jdbc" )
.options(
Map ("url" ->"jdbc:mysql://localhost:3306/system?user=root&password=123456" ,"dbtable" ->"user" ,"driver" ->"com.mysql.jdbc.Driver" ))
.load().show()
// 通过 JDBC
val pros :Properties = new Properties()
pros.setProperty("user" ,"root" )
pros.setProperty("password" ,"123456" )
val df :DataFrame = spark.read.jdbc("jdbc:mysql://localhost:3306/system" ,"user" ,pros)
df.show()
- 写入数据
val sparkConf = new SparkConf().setMaster("local\*" ).setAppName("SQL" )
val spark:SparkSession = SparkSession.builder ().config(sparkConf).getOrCreate()
import spark.implicits._
val rdd: RDDStu = spark.sparkContext.makeRDD(List (Stu ("lisi" , 20),
Stu ("zs" , 30)))
val ds:DatasetStu = rdd.toDS()
ds.write.format("jdbc" )
.option("url" ,"jdbc:mysql://localhost:3306/system" )
.option("driver" ,"com.mysql.jdbc.Driver" )
.option("user" ,"root" )
.option("password" ,"123456" )
.option("dbtable" ,"user2" )
.mode(SaveMode.Append )
.save()
spark.stop()