C++中的stack和queue
前言
这一节的内容对于stack和queue的使用介绍会比较少,主要是因为stack和queue的使用十分简单,而且他们的功能主要也是在做题的时候才会显现。这一栏目暂时不会写关于做题的内容,后续我会额外开一个做题日记的栏目的。
这节内容主要给大家讲解一下stack和queue的特殊性,和相关实现。
使用
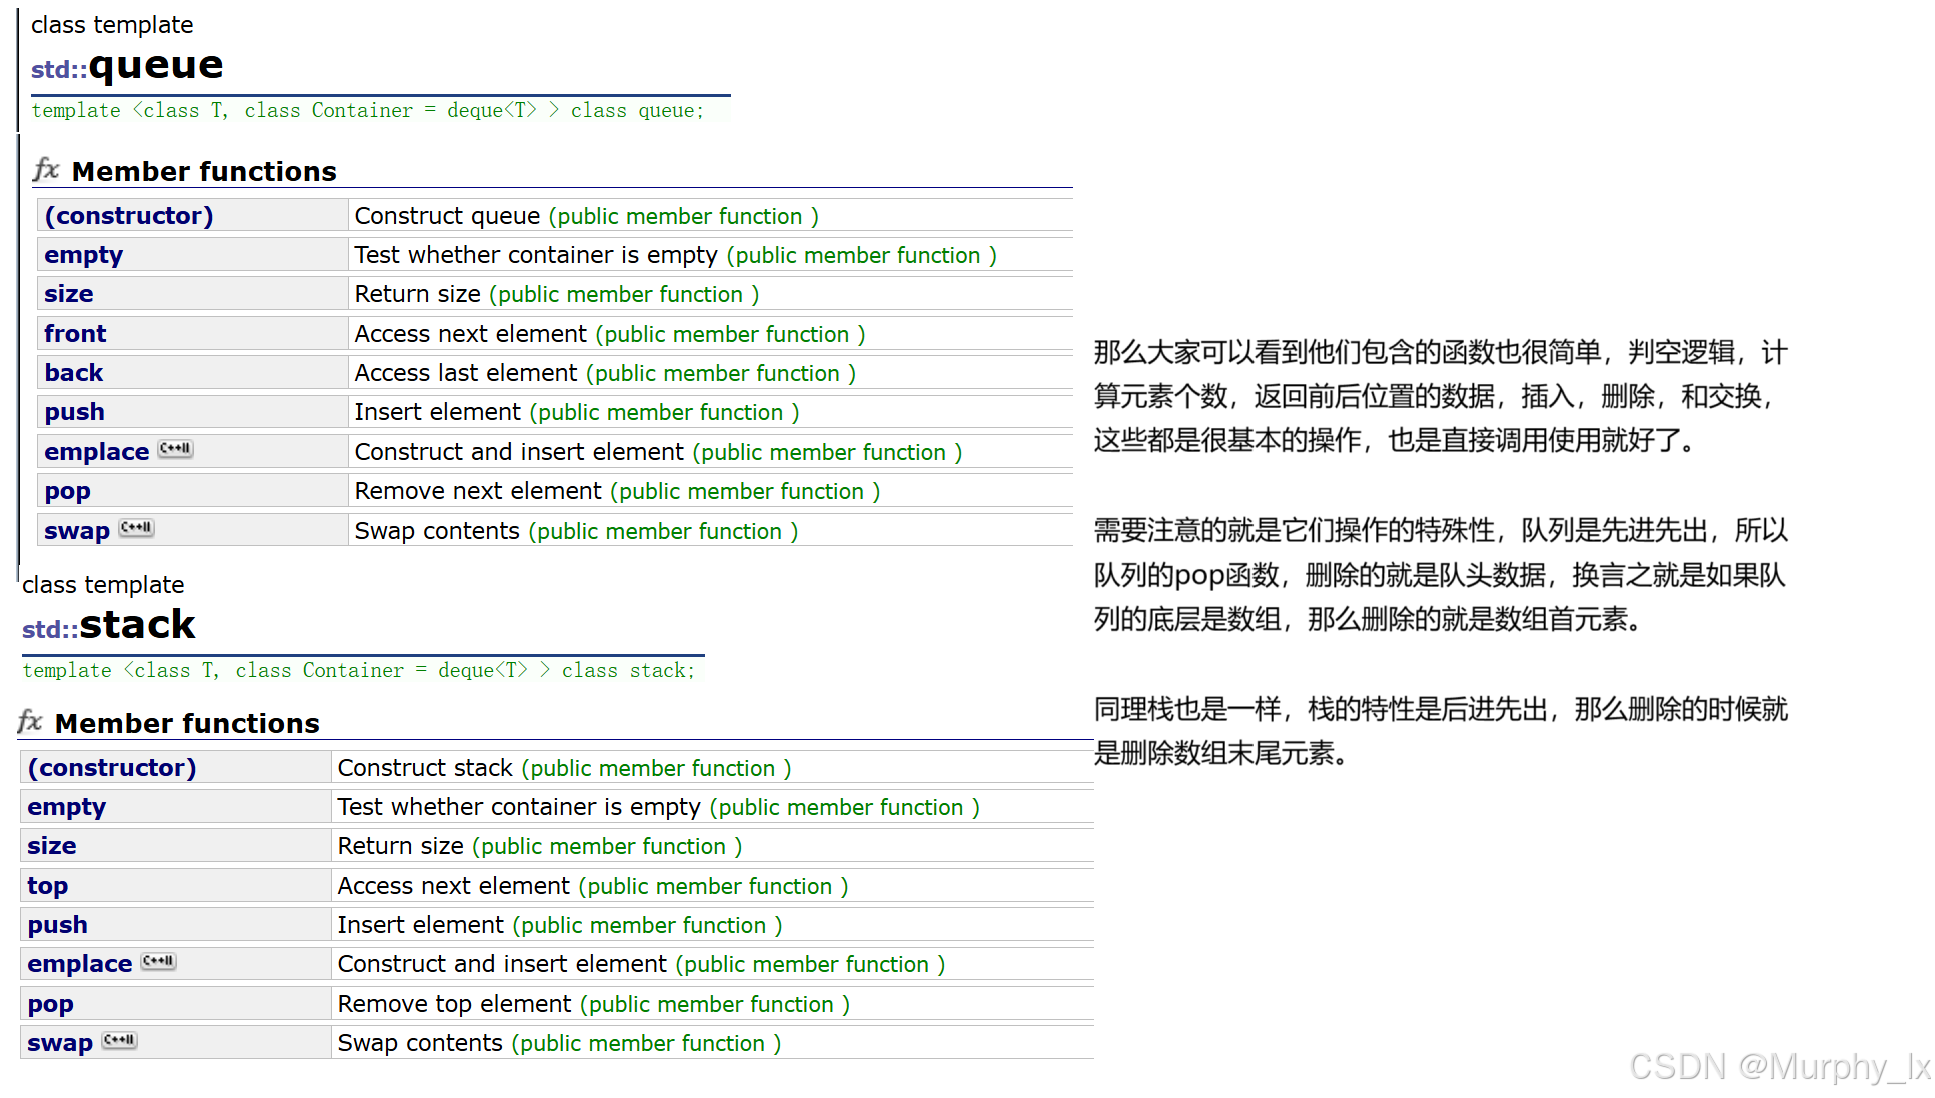
对stack和queue的简单介绍
一、基本概念
-
Stack(栈):
- 后进先出(LIFO):最后插入的元素最先被移除。
- 类比:一摞盘子(只能从顶部取放)。
- 核心操作:
push(入栈)、pop(出栈)、top(访问栈顶)。
-
Queue(队列):
- 先进先出(FIFO):最先插入的元素最先被移除。
- 类比:排队购票(队尾进,队头出)。
- 核心操作:
push(入队)、pop(出队)、front/back(访问队头/队尾)。
二、底层实现原理//重点
-
容器适配器 :
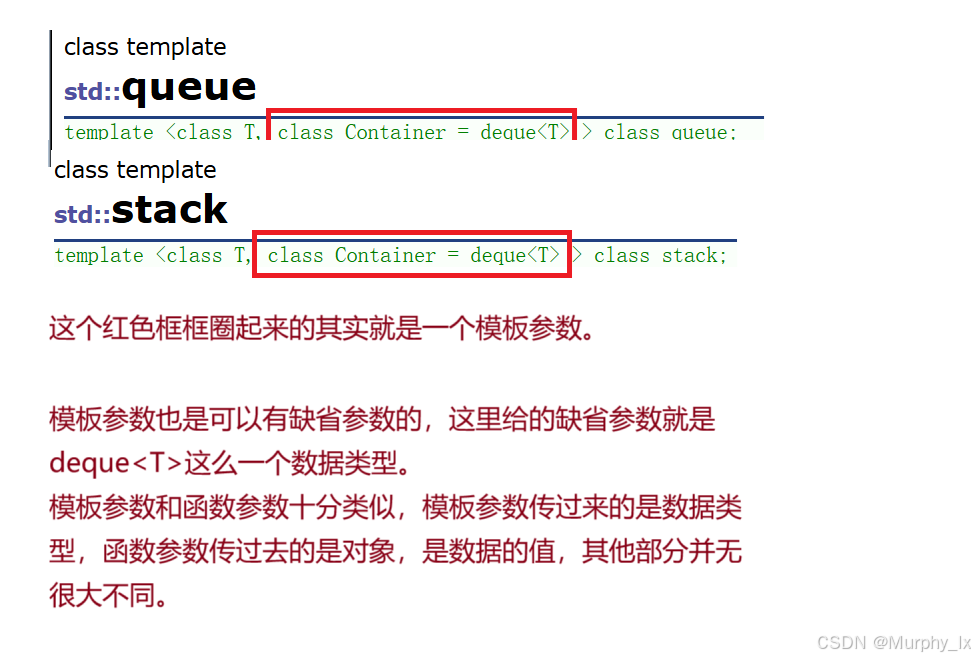
stack和queue不是独立的容器,而是基于其他容器(如deque、list)的接口封装。cpp// 默认底层容器:deque(双端队列)//这个容器会在下一节讲解 stack<int> s; // 等价于 stack<int, deque<int>> queue<int> q; // 等价于 queue<int, deque<int>> // 自定义底层容器(需满足操作要求) stack<int, vector<int>> s_vec; // 使用 vector queue<int, list<int>> q_list; // 使用 list
-
底层容器要求:
操作 stack所需支持queue所需支持尾部插入 push_back()push_back()尾部删除 pop_back()❌ 头部删除 ❌ pop_front()访问尾部 back()back()访问头部 ❌ front()⚠️ 注意 :
vector不能直接用于queue(缺少pop_front())。
三、核心操作与时间复杂度
| 操作 | stack |
queue |
时间复杂度 |
|---|---|---|---|
| 插入元素 | push(val) |
push(val) |
O(1) |
| 删除元素 | pop() |
pop() |
O(1) |
| 访问顶部/头部元素 | top() |
front() |
O(1) |
| 访问尾部元素 | ❌ | back() |
O(1) |
| 检查是否为空 | empty() |
empty() |
O(1) |
| 获取元素数量 | size() |
size() |
O(1) |
💡 为什么高效?
默认基于
deque(动态数组分块存储),插入/删除操作均摊常数时间。
四、使用示例
-
Stack 示例:括号匹配
cpp#include <stack> bool isValid(string s) { stack<char> st; for (char c : s) { if (c == '(' || c == '[') st.push(c); else { if (st.empty()) return false; char top = st.top(); if ((c == ')' && top != '(') || (c == ']' && top != '[')) return false; st.pop(); } } return st.empty(); } -
Queue 示例:BFS 算法框架
cpp#include <queue> void BFS(Node* start) { queue<Node*> q; q.push(start); while (!q.empty()) { Node* cur = q.front(); q.pop(); // 处理当前节点 for (Node* neighbor : cur->neighbors) { q.push(neighbor); } } }
五、应用场景
| 数据结构 | 典型应用场景 |
|---|---|
stack |
函数调用栈、表达式求值、DFS 遍历、撤销操作(Ctrl+Z) |
queue |
消息队列、BFS 遍历、缓冲区管理(如打印机任务)、多线程任务调度 |
六、注意事项
-
空容器操作禁止:
cppstack<int> s; s.pop(); // 未定义行为(崩溃)! if (!s.empty()) s.pop(); // 正确做法 -
不支持遍历 :
二者均没有迭代器 ,无法用
for (auto x : s)遍历。 -
底层容器选择:
stack优先选vector(内存局部性好)。queue只能选deque或list(避免用vector)。
-
线程安全 :
STL 的
stack/queue不是线程安全的,多线程需手动加锁。
七、进阶技巧
-
用
vector模拟栈(简化内存管理):cppvector<int> v_stack; v_stack.push_back(10); // push int top = v_stack.back(); // top v_stack.pop_back(); // pop -
双栈实现队列:
cppclass Queue { stack<int> in, out; void push(int x) { in.push(x); } int pop() { if (out.empty()) { while (!in.empty()) { out.push(in.top()); in.pop(); } } int val = out.top(); out.pop(); return val; } };
总结
| 特性 | stack |
queue |
|---|---|---|
| 数据顺序 | LIFO(后进先出) | FIFO(先进先出) |
| 核心接口 | push(), pop(), top() |
push(), pop(), front() |
| 底层依赖 | deque/vector/list |
deque/list |
| 遍历 | 不支持 | 不支持 |
| 适用场景 | 逆序操作、递归 | 顺序处理、缓冲 |
✅ 选择原则:
- 需要回溯操作 →
stack(如 DFS、撤销机制)- 需要公平调度 →
queue(如 BFS、消息队列)
C++ priority_queue (优先队列)详解
一、本质与核心概念
优先队列(priority_queue) 是一种特殊的队列,元素按优先级顺序出队 (而非插入顺序)。它是基于堆数据结构(通常是二叉堆)实现的容器适配器。
也就是说,当我们需要使用到堆这个数据结构的时候,使用这个优先级队列就ok了,它也是被包括在queue头文件中的。
关键特性:
- 队首元素 总是当前队列中优先级最高的元素
- 默认行为:最大元素优先(大顶堆//堆顶元素最大)
- 底层结构 :默认使用
vector作为容器//这个优先级队列也是一个容器适配器 - 时间复杂度 :
- 访问队首:O(1)
- 插入元素:O(log n)
- 删除队首:O(log n)
二、底层实现原理
cpp
template<
    class T,
    class Container = std::vector<T>,
    class Compare = std::less<typename Container::value_type>
> class priority_queue;-
堆结构维护:
- 插入时 (
push):将元素添加到末尾,然后进行上浮操作(sift up)//也就是我们学习堆数据结构时候的向上调整。 - 删除时 (
pop):交换首尾元素,删除尾部,然后进行下沉操作(sift down)//也就是我们学习堆数据结构时候的向下调整。
- 插入时 (
-
堆算法函数(底层实际调用):
cppstd::make_heap() // 建堆 std::push_heap() // 插入后调整 std::pop_heap() // 删除前调整
三、模板参数详解
| 参数 | 说明 | 默认值 |
|---|---|---|
T |
元素类型 | 必填 |
Container |
底层容器 | vector<T> |
Compare |
优先级比较函数 | less<T> |
底层容器要求:
- 必须支持随机访问迭代器(
vector/deque) - 必须支持
front(),push_back(),pop_back() - 不兼容
list(缺少随机访问)
四、核心操作与时间复杂度
| 操作 | 函数 | 时间复杂度 | 说明 |
|---|---|---|---|
| 插入元素 | push(const T& val) |
O(log n) | 添加元素并调整堆 |
| 删除队首 | pop() |
O(log n) | 移除最高优先级元素 |
| 访问队首 | top() |
O(1) | 返回队首元素(只读) |
| 检查空 | empty() |
O(1) | 判断是否为空 |
| 获取大小 | size() |
O(1) | 返回元素数量 |
五、创建与初始化
cpp
// 默认创建(大顶堆)
std::priority_queue<int> max_heap;

// 预分配空间
std::vector<int> vec{3,1,4,1,5};
std::priority_queue<int> pre_heap(vec.begin(), vec.end());

// 自定义比较函数(小顶堆)
auto cmp = [](int a, int b) { return a > b; };
std::priority_queue<int, std::vector<int>, decltype(cmp)> min_heap(cmp);

// 使用函数对象(推荐)//这其实就是仿函数,等会后面会讲
struct Compare {
    bool operator()(const Person& a, const Person& b) {
        return a.age < b.age; // 年龄大的优先
    }
};
std::priority_queue<Person, std::vector<Person>, Compare> age_heap;
六、自定义优先级规则(关键技巧)
cpp
// 方法1:重载 operator<
struct Task {
    int priority;
    std::string name;

    bool operator<(const Task& other) const {
        return priority < other.priority; // 大顶堆要求
    }
};

// 方法2:自定义函数对象
struct TaskComparator {
    bool operator()(const Task& a, const Task& b) {
        return a.priority < b.priority; // 注意:返回true表示a优先级低于b
    }
};

// 方法3:使用标准函数对象(创建小顶堆)
std::priority_queue<int, std::vector<int>, std::greater<int>> min_heap;
⚠️ 比较函数重要规则:
- 当
comp(a, b) == true时,a的优先级将低于b- 对于大顶堆:
return a < b;- 对于小顶堆:
return a > b;
七、典型应用场景
-
任务调度系统:
cppstruct Task { int priority; std::function<void()> job; bool operator<(const Task& t) const { return priority < t.priority; } }; std::priority_queue<Task> scheduler; -
Dijkstra 最短路径算法:
cppstd::priority_queue<std::pair<int, int>> pq; // { -distance, node } pq.push({0, start}); // 使用负值实现最小堆 -
合并K个有序链表:
cppauto cmp = [](ListNode* a, ListNode* b) { return a->val > b->val; }; std::priority_queue<ListNode*, std::vector<ListNode*>, decltype(cmp)> pq(cmp); -
实时获取中位数(双堆法):
cppstd::priority_queue<int> max_heap; // 存储较小一半 std::priority_queue<int, std::vector<int>, std::greater<int>> min_heap; // 存储较大一半
八、底层容器选择策略
| 容器 | 随机访问 | 内存连续性 | 适用性 | 推荐场景 |
|---|---|---|---|---|
vector |
✅ | ✅ | 推荐 | 通用场景 |
deque |
✅ | ❌(分块) | 可用 | 避免尾部扩容 |
list |
❌ | ❌ | 不兼容 | - |
为什么用
vector不用deque?
vector内存连续,缓存友好- 堆操作主要依赖随机访问,
vector性能更优
九、特殊操作与技巧
-
高效初始化:
cppstd::vector<int> data{3,1,4,5,9,2,6}; // 直接通过迭代器建堆(O(n) 时间复杂度) std::priority_queue<int> pq(data.begin(), data.end()); -
清空队列的陷阱:
cpp// 错误方式(低效): while (!pq.empty()) pq.pop(); // O(n log n) // 正确方式: std::priority_queue<int> empty; std::swap(pq, empty); // O(1) -
修改队首元素(高级技巧):
cpp// 1. 取出队首 auto top = pq.top(); pq.pop(); // 2. 修改元素 top.value = new_value; // 3. 重新插入 pq.push(top);
十、与相似数据结构的对比
| 特性 | priority_queue |
set/multiset |
map/multimap |
|---|---|---|---|
| 排序方式 | 堆序 | 红黑树序 | 红黑树序 |
| 重复元素 | 允许 | multiset允许 |
multimap允许 |
| 随机访问 | 仅队首 | 不支持 | 不支持 |
| 插入删除 | O(log n) | O(log n) | O(log n) |
| 查找元素 | 不支持 | O(log n) | O(log n) |
| 内存开销 | 低 | 高(指针) | 高(指针) |
十一、性能优化指南
-
元素使用移动语义:
cppstruct HeavyObject { std::vector<int> big_data; HeavyObject(HeavyObject&& other) noexcept = default; }; pq.push(std::move(obj)); // 避免大对象复制 -
预留空间(仅
vector底层):cpp// 直接访问底层容器(不推荐但有效) std::priority_queue<int, std::vector<int>> pq; pq.c.reserve(1000); // 访问底层容器的reserve -
自定义内存分配器:
cpptemplate<typename T> class CustomAllocator { /* ... */ }; using CustomPQ = std::priority_queue<int, std::vector<int, CustomAllocator<int>>;
十二、常见错误与陷阱
-
错误比较函数:
cpp// 错误:返回true表示a优先级低于b auto cmp = [](int a, int b) { return a < b; }; // 正确的大顶堆 auto wrong_cmp = [](int a, int b) { return a > b; }; // 错误!实际创建了小顶堆 -
修改队首破坏堆结构:
cpp// 错误:直接修改队首元素 pq.top().priority = 100; // 破坏堆性质! -
遍历队列陷阱:
cppwhile (!pq.empty()) { process(pq.top()); // 错误:忘记pop()导致死循环 pq.pop(); // 必须显式pop }
十三、最佳实践总结
| 场景 | 推荐方案 |
|---|---|
| 需要最高优先级元素 | priority_queue |
| 需要完整排序 | set 或 map |
| 需要遍历元素 | vector + std::sort |
| 需要快速查找 | unordered_map |
| 内存敏感场景 | priority_queue + vector |
✅ 黄金法则:
- 优先使用
vector作为底层容器- 比较函数中明确优先级规则
- 避免直接修改队列内部元素
- 批量初始化优于逐个插入
- 使用移动语义减少拷贝开销
十四、C++20 新特性
-
范围构造支持:
cppstd::vector data{5, 3, 8, 1}; std::priority_queue pq(std::less{}, data); // C++20 类型推导 -
透明比较器优化:
cppstd::priority_queue<std::string, std::vector<std::string>, std::less<>> pq; // 支持异构查找 pq.push("test"); auto it = find_if(begin(pq.c), end(pq.c), [](auto& s){ return s == "test"; }); // 直接比较
十五、综合示例:医院急诊系统
cpp
struct Patient {
    std::string name;
    int severity; // 1-10, 10为最严重
    time_t arrival_time;

    bool operator<(const Patient& other) const {
        // 优先级规则:先按严重程度,再按到达时间
        return std::tie(severity, arrival_time) <
               std::tie(other.severity, other.arrival_time);
    }
};

std::priority_queue<Patient> emergency_queue;

void admit_patient(std::string name, int severity) {
    emergency_queue.push({name, severity, time(nullptr)});
}

void treat_next_patient() {
    if (emergency_queue.empty()) return;

    Patient next = emergency_queue.top();
    emergency_queue.pop();

    std::cout << "Treating: " << next.name
              << " (Severity: " << next.severity << ")\n";
}
总结:优先队列三要素
- 数据结构核心:二叉堆实现
- 优先级控制:通过比较函数定制
- 性能平衡 :
- O(1) 访问队首
- O(log n) 插入/删除
- O(n) 建堆
📌 使用决策树 :
需要不断获取 最大值/最小值 + 频繁插入删除 → 选择
priority_queue需要完整排序/遍历 → 选择
set或排序vector需要键值关联 → 选择
map
容器适配器
那么我们这一节的重点其实就是这个知识点:容器适配器。弄清楚容器适配器是啥?怎么使用。
一、什么是容器适配器?
容器适配器 (Container Adapter)是 STL 中的特殊容器,它们不直接管理数据 ,而是通过"借用"已有容器(如 deque、vector、list)的功能,提供特定接口来实现特定数据结构行为。
类比解释:
这里我结合stack和现实生活中的样例给大家解释一下:
stack(也就是栈)它的特点不就是后进先出嘛,那么要怎么实现后进先出呢?那其实也很简单,首先栈的插入,也就是栈的push功能,其实就是尾部插入数据嘛。那么后进先出,这里其实涉及到的就是pop删除元素的功能函数嘛,后进先出,也就是pop元素的时候默认调用一个尾部删除pop_back函数。栈的一些其余功能,如取栈顶元素是返回数组末尾元素。之前在讲栈的时候就说过栈其实是一个特殊的线性表,特殊在它的操作(如删除操作就是指定尾部删除数据)。但是这些特殊操作我们也可以调用普通数据结构中的某些函数来实现,就好比如vector就可以完美的转换成stack。之前我们学习数据结构的时候,因为没有模板,所以我们要额外写一份栈的代码,但是现在有了模板之后,我们就可以借助模板,将某些容器转换成某些别的容器,就好比如vector转换成stack。
用生活中的例子给大家解释的话,我觉得大家可以这样想:假设现在电脑上没有网线接口或者有线耳机的线孔,只有一个Type-C接口,那么这个Type-C接口我们就可以把它当作vector。现在网上不是有很多扩展坞嘛,扩展坞上啥孔都有,我们把这个扩展坞想象成模板。假设我现在想给我的笔记本电脑插上网线,但是没有网线接口。那么我们就可以使用扩展坞将原来的Type-C接口变成网线接口。在C++中,vector转换成stack是容器转容器,在现实里,Type-C接口转网线接口是接口转接口。大家可以这样类比的理解,虽然这是一个不太严谨的例子,但是我个人觉得还是不错的。
所以说这里的网线其实是借用Type-C接口进行与电脑的连接。
二、为什么需要容器适配器?
| 方式 | 直接实现数据结构 | 使用容器适配器 |
|---|---|---|
| 开发成本 | 需从头实现所有操作 | 复用已有容器代码 |
| 灵活性 | 固定实现 | 可自由切换底层容器 |
| 维护性 | 需单独维护 | 依赖 STL 标准容器 |
| 性能优化 | 优化困难 | 轻松切换高效底层容器 |
三、三大容器适配器
stack:后进先出(LIFO)结构queue:先进先出(FIFO)结构priority_queue:优先级队列(元素按优先级排序)
四、底层容器要求(核心知识)
每个适配器对底层容器有特定接口要求:
1. stack 的底层容器必须支持:
cpp
push_back()  // 尾部插入
pop_back()   // 尾部删除
back()       // 访问尾部元素
✅ 兼容容器:deque(默认)、vector、list
2. queue 的底层容器必须支持:
cpp
push_back()  // 尾部插入
pop_front()  // 头部删除
front()      // 访问头部元素
back()       // 访问尾部元素(非必须但常用)
✅ 兼容容器:deque(默认)、list
❌ 不兼容:vector(缺少 pop_front)
3. priority_queue 的额外要求:
cpp
// 需要随机访问迭代器
front()             // 访问首元素
push_back()         // 尾部插入
pop_back()          // 尾部删除
// 内部使用堆算法(需支持随机访问)
✅ 兼容容器:vector(默认)、deque
五、底层容器性能对比
| 操作 | vector | deque | list |
|---|---|---|---|
| 尾部插入 | O(1) 均摊 | O(1) | O(1) |
| 头部插入 | O(n) | O(1) | O(1) |
| 随机访问 | O(1) | O(1) | O(n) |
| 内存布局 | 连续内存 | 分块连续 | 非连续 |
| 适配 stack | ✅ 推荐 | ✅ | ✅ |
| 适配 queue | ❌ 不兼容 | ✅ 默认 | ✅ |
💡 黄金搭配:
stack+vector:内存连续,缓存友好queue+deque:高效头尾操作priority_queue+vector:堆算法需要随机访问
六、自定义底层容器(实战示例)
cpp
#include <stack>
#include <vector>
#include <list>
#include <queue>

// 自定义stack底层容器
std::stack<int, std::vector<int>> vec_stack;  // 基于vector
std::stack<int, std::list<int>> list_stack;    // 基于list

// 自定义queue底层容器
std::queue<int, std::list<int>> list_queue;    // 基于list

// priority_queue使用vector
std::priority_queue<int, std::vector<int>> max_heap;
七、容器适配器 VS 普通容器
| 特性 | 普通容器(vector/list) | 容器适配器(stack/queue) |
|---|---|---|
| 迭代器 | ✅ 支持完整迭代器 | ❌ 无迭代器 |
| 遍历 | ✅ 可随机访问任意元素 | ❌ 只能访问特定端元素 |
| 底层数据 | ✅ 可直接访问 | ❌ 隐藏底层实现 |
| 功能接口 | 提供完整容器操作 | 仅暴露特定数据结构接口 |
| 设计目的 | 通用数据存储 | 特定数据行为抽象 |
八、实现原理揭秘
cpp
template<typename T, typename Container = std::deque<T>>
class stack //栈
{
    public:
    void push(const T& value) {
        c.push_back(value);  // 调用底层容器的push_back
    }

    void pop() {
        c.pop_back();        // 调用底层容器的pop_back
    }

    T& top() {
        return c.back();     // 调用底层容器的back
    }

    size_t size()
    {
        return c.size();//调用底层容器的size
    }

    bool empty()
    {
        return c.empty();//调用底层容器的empty
    }
    private:
    Container c;  // 底层容器对象
};
cpp
template<class T, class Container = std::deque<T>>
	class queue//队列
	{
	public:
		void push(const T& x)
		{
			_con.push_back(x);
		}

		void pop()
		{
			_con.pop_front();
		}

		const T& front()
		{
			return _con.front();
		}

		const T& back()
		{
			return _con.back();
		}

		size_t size()
		{
			return _con.size();
		}

		bool empty()
		{
			return _con.empty();
		}

	private:
		Container _con;
	};
cpp
#include <vector>
#include <functional> // 用于 std::less
#include <algorithm> // 用于 std::swap

template <typename T,
          typename Container = std::vector<T>,
          typename Compare = std::less<typename Container::value_type>>
class priority_queue //优先队列
{
public:
    // 默认构造函数
    priority_queue() = default;

    // 使用自定义比较器的构造函数
    explicit priority_queue(const Compare& comp)
        : comp(comp) {}

    // 通过迭代器范围构造
    template <typename InputIterator>
    priority_queue(InputIterator first, InputIterator last,
                  const Compare& comp = Compare())
        : c(first, last), comp(comp)
    {
        build_heap(); // 构建堆
    }

    // 插入元素
    void push(const T& value)
    {
        c.push_back(value);       // 添加到末尾
        sift_up(c.size() - 1);    // 上浮新元素
    }

    // 删除堆顶元素
    void pop()
    {
        if (c.empty()) return;

        std::swap(c[0], c.back()); // 交换首尾元素
        c.pop_back();              // 删除原堆顶

        if (!c.empty()) {
            sift_down(0);          // 下沉新堆顶
        }
    }

    // 访问堆顶元素(只读)
    const T& top() const
    {
        return c.front();
    }

    // 元素数量
    size_t size() const
    {
        return c.size();
    }

    // 检查是否为空
    bool empty() const
    {
        return c.empty();
    }

private:
    Container c;     // 底层容器
    Compare comp;    // 比较函数对象

    // 构建堆(Floyd算法)
    void build_heap()
    {
        // 从最后一个非叶子节点开始下沉
        for (int i = (c.size() / 2) - 1; i >= 0; --i) {
            sift_down(i);
        }
    }

    // 上浮操作
    void sift_up(size_t idx)
    {
        while (idx > 0)
        {
            size_t parent = (idx - 1) / 2;

            // 如果当前节点优先级高于父节点
            if (comp(c[parent], c[idx]))
            {
                std::swap(c[parent], c[idx]);
                idx = parent;
            }
            else
            {
                break; // 堆条件已满足
            }
        }
    }

    // 下沉操作
    void sift_down(size_t idx)
    {
        size_t largest = idx;
        const size_t n = c.size();

        while (true)
        {
            size_t left = 2 * idx + 1;
            size_t right = 2 * idx + 2;

            // 检查左子节点
            if (left < n && comp(c[largest], c[left]))
            {
                largest = left;
            }

            // 检查右子节点
            if (right < n && comp(c[largest], c[right]))
            {
                largest = right;
            }

            // 如果当前节点不是最大,交换并继续下沉
            if (largest != idx)
            {
                std::swap(c[idx], c[largest]);
                idx = largest;
            }
            else
            {
                break; // 堆条件已满足
            }
        }
    }
};关键点:所有操作转发到底层容器的特定接口
九、特殊行为解析
-
为什么
stack不提供clear()?因为标准委员会认为
while(!s.empty()) s.pop()已足够清晰 -
priority_queue的排序控制:cpp// 创建小顶堆(默认是大顶堆) std::priority_queue<int, std::vector<int>, std::greater<int>> min_heap; -
queue的back()不是必须的 :某些实现(如早期 STL)允许使用不支持
back()的容器
十、设计思想与最佳实践
-
适配器模式精髓:
- 不改变已有容器代码
- 通过限制接口实现新功能
- 符合开闭原则(对扩展开放,对修改封闭)
-
使用建议:
cpp// 需要后进先出 → 选择 stack stack<int, vector<int>> s; // 推荐 vector 提高缓存命中率 // 需要先进先出 → 选择 queue queue<int> q; // 默认 deque 最均衡 // 需要优先级处理 → priority_queue priority_queue<int> pq; // 默认 vector 大顶堆 -
避免的陷阱:
cpp// 错误:vector 缺少 pop_front() std::queue<int, std::vector<int>> invalid_queue; // 错误:尝试遍历适配器 for(auto it = s.begin(); it != s.end(); ++it) // stack 无迭代器
十一、性能优化技巧
-
预分配内存(
vector底层时):cppstd::stack<int, std::vector<int>> s; s.c.reserve(1000); // 直接访问底层容器预分配 -
选择分块存储容器避免扩容:
cpp// 处理超大数据时使用 deque std::stack<int, std::deque<int>> big_stack; -
自定义内存分配器:
cppstd::stack<int, std::vector<int, MyAllocator<int>>> custom_stack;
十二、总结:容器适配器的本质
| 维度 | 说明 |
|---|---|
| 身份 | 底层容器的"接口转换器" |
| 核心能力 | 通过限制/转发底层容器接口实现特定数据结构 |
| 价值 | 代码复用 + 接口统一 + 灵活切换 |
| 哲学思想 | "不要重复发明轮子"(Don't Reinvent The Wheel) |
| 典型应用 | 算法中的临时数据结构(DFS/BFS)、消息系统、撤销操作栈 |
✅ 使用口诀 :
栈用 vector,队列用 deque
优先队列 vector,底层切换要合规
迭代遍历不可为,专用接口记心间!
仿函数
一、什么是仿函数?
仿函数(Function Object)是C++中行为类似函数的对象 。它们通过重载函数调用运算符operator()实现,使得对象可以像函数一样被调用。
基本特征:
- 是类对象,不是函数
- 重载了
operator()运算符 - 可以保存状态(成员变量)
- 可以作为参数传递
- 可以像普通函数一样调用
简单示例:
cpp
#include <iostream>

// 定义一个加法仿函数
struct Adder {
    int operator()(int a, int b) const {
        return a + b;
    }
};

int main() {
    Adder add; // 创建仿函数对象
    std::cout << add(3, 4); // 像函数一样调用:输出7
    return 0;
}
二、为什么需要仿函数?
1. 相比普通函数的优势:
| 特性 | 普通函数 | 仿函数 |
|---|---|---|
| 状态保持 | ❌ 无状态 | ✅ 可保存状态 |
| 内联优化 | ❌ 通常不能 | ✅ 可内联 |
| 作为模板参数 | ❌ 不支持 | ✅ 支持 |
| 多态行为 | ❌ 不支持 | ✅ 支持 |
2. 实际应用场景:
- STL算法的自定义行为(如排序、查找)
- 回调机制
- 策略模式实现
- 函数组合
三、仿函数的类型分类
1. 按参数数量分类:
| 类型 | 参数数量 | 示例 |
|---|---|---|
| 生成器(Generator) | 0 | rand() |
| 一元仿函数(Unary) | 1 | negate<T>() |
| 二元仿函数(Binary) | 2 | plus<T>() |
2. 按行为分类:
| 类型 | 返回值 | 用途 | 示例 |
|---|---|---|---|
| 算术仿函数 | 数值 | 数学运算 | plus, minus |
| 关系仿函数 | bool | 比较操作 | less, greater |
| 逻辑仿函数 | bool | 逻辑运算 | logical_and, logical_or |
四、STL内置仿函数详解
STL在<functional>头文件中提供了常用仿函数:
1. 算术仿函数:
cpp
#include <functional>

std::plus<int> add;
int result = add(5, 3); // 8

std::minus<int> subtract;
result = subtract(10, 4); // 6

std::multiplies<int> multiply;
result = multiply(3, 4); // 12

std::divides<int> divide;
result = divide(10, 2); // 5

std::modulus<int> mod;
result = mod(10, 3); // 1

std::negate<int> neg;
result = neg(7); // -7
2. 关系仿函数:
cpp
std::equal_to<int> equal;
bool isEqual = equal(5, 5); // true

std::not_equal_to<int> notEqual;
isEqual = notEqual(5, 3); // true

std::greater<int> greater;
isEqual = greater(5, 3); // true

std::less<int> less;
isEqual = less(3, 5); // true

std::greater_equal<int> ge;
isEqual = ge(5, 5); // true

std::less_equal<int> le;
isEqual = le(4, 5); // true
3. 逻辑仿函数:
cpp
std::logical_and<bool> and_op;
bool res = and_op(true, false); // false

std::logical_or<bool> or_op;
res = or_op(true, false); // true

std::logical_not<bool> not_op;
res = not_op(true); // false
五、自定义仿函数实现
1. 基本实现:
cpp
// 幂运算仿函数
class Power {
public:
    double operator()(double base, int exponent) const {
        double result = 1.0;
        for (int i = 0; i < exponent; ++i) {
            result *= base;
        }
        return result;
    }
};

// 使用
Power power;
double eight = power(2, 3); // 8.0
2. 带状态的仿函数:
cpp
// 计数器仿函数
class Counter {
    int count = 0;
public:
    int operator()() {
        return ++count;
    }

    void reset() {
        count = 0;
    }
};

// 使用
Counter c;
c(); // 1
c(); // 2
c.reset();
c(); // 1
3. 模板仿函数:
cpp
template <typename T>
class Clamp {
    T min_val;
    T max_val;
public:
    Clamp(T min, T max) : min_val(min), max_val(max) {}

    T operator()(T value) const {
        if (value < min_val) return min_val;
        if (value > max_val) return max_val;
        return value;
    }
};

// 使用
Clamp<int> intClamp(0, 100);
int value = intClamp(150); // 100

Clamp<double> doubleClamp(0.0, 1.0);
double dval = doubleClamp(-0.5); // 0.0
六、仿函数在STL算法中的应用
1. 排序算法:
cpp
#include <algorithm>
#include <vector>

std::vector<int> numbers = {5, 3, 8, 1, 4};

// 升序排序
std::sort(numbers.begin(), numbers.end(), std::less<int>());

// 降序排序
std::sort(numbers.begin(), numbers.end(), std::greater<int>());
2. 查找算法:
cpp
// 查找第一个大于5的元素
auto it = std::find_if(numbers.begin(), numbers.end(),
                      [](int x) { return x > 5; });

// 使用仿函数替代lambda
struct GreaterThan {
    int threshold;
    GreaterThan(int t) : threshold(t) {}
    bool operator()(int x) const { return x > threshold; }
};

it = std::find_if(numbers.begin(), numbers.end(), GreaterThan(5));
3. 转换算法:
cpp
#include <vector>
#include <cmath>

struct SquareRoot {
    double operator()(double x) const {
        return std::sqrt(x);
    }
};

std::vector<double> values = {1.0, 4.0, 9.0, 16.0};
std::vector<double> roots;

// 计算平方根
std::transform(values.begin(), values.end(),
              std::back_inserter(roots),
              SquareRoot());
七、仿函数适配器
1. 绑定器(Binder):
cpp
#include <functional>
#include <algorithm>

using namespace std::placeholders; // 用于 _1, _2 等占位符

// 绑定第一个参数为10
auto greaterThan10 = std::bind(std::greater<int>(), _1, 10);

std::vector<int> data = {5, 12, 8, 15, 3};
int count = std::count_if(data.begin(), data.end(), greaterThan10); // 2
2. 取反器(Negator):
cpp
// 创建不等于5的谓词
auto notEqual5 = std::not1(std::bind2nd(std::equal_to<int>(), 5));

count = std::count_if(data.begin(), data.end(), notEqual5); // 4
八、仿函数 vs Lambda表达式
比较:
| 特性 | 仿函数 | Lambda表达式 |
|---|---|---|
| 语法简洁性 | ❌ 需要完整类定义 | ✅ 简洁 |
| 状态管理 | ✅ 显式成员变量 | ✅ 捕获列表 |
| 复用性 | ✅ 可多次使用 | ❌ 通常一次性 |
| 模板支持 | ✅ 完全支持 | ⚠️ C++20起支持 |
| 调试 | ✅ 更容易 | ❌ 匿名类型 |
转换示例:
cpp
// Lambda表达式
auto lambda = [](int a, int b) { return a * b; };

// 等效仿函数
class Multiplier {
public:
    int operator()(int a, int b) const {
        return a * b;
    }
};
九、高级技巧与最佳实践
1. 函数组合:
cpp
template <typename F, typename G>
class Compose {
    F f;
    G g;
public:
    Compose(F f, G g) : f(f), g(g) {}

    template <typename T>
    auto operator()(T x) const -> decltype(f(g(x))) {
        return f(g(x));
    }
};

// 使用:先平方再取负
Compose<std::negate<double>, std::multiplies<double>>
    squareAndNegate(std::negate<double>(), std::multiplies<double>());

double result = squareAndNegate(4.0); // -16.0
2. 性能优化:
- 声明
operator()为inline - 对于简单操作,使用空仿函数(无状态)
- 优先传递仿函数对象而非函数指针
3. 现代C++改进(C++11/14/17/20):
-
自动类型推导 :
auto关键字简化声明 -
泛型Lambda (C++14):
cppauto genericAdder = [](auto a, auto b) { return a + b; }; -
模板Lambda (C++20):
cppauto templated = []<typename T>(T a, T b) { return a + b; };
十、实际应用案例
1. 自定义排序:
cpp
struct Person {
    std::string name;
    int age;
    double salary;
};

// 多级排序仿函数
class PersonSorter {
public:
    bool operator()(const Person& a, const Person& b) const {
        // 先按年龄升序
        if (a.age != b.age)
            return a.age < b.age;

        // 年龄相同按薪资降序
        if (a.salary != b.salary)
            return a.salary > b.salary;

        // 最后按名字升序
        return a.name < b.name;
    }
};

std::vector<Person> people;
std::sort(people.begin(), people.end(), PersonSorter());
2. 策略模式实现:
cpp
// 支付策略接口
class PaymentStrategy {
public:
    virtual double calculate(double amount) const = 0;
    virtual ~PaymentStrategy() = default;
};

// 信用卡支付策略
class CreditCardStrategy : public PaymentStrategy {
    double feeRate;
public:
    CreditCardStrategy(double rate) : feeRate(rate) {}
    double calculate(double amount) const override {
        return amount * (1 + feeRate);
    }
};

// 支付处理器
class PaymentProcessor {
    PaymentStrategy* strategy;
public:
    void setStrategy(PaymentStrategy* s) { strategy = s; }
    double processPayment(double amount) {
        return strategy->calculate(amount);
    }
};
总结:仿函数的优势与选择
何时使用仿函数:
- 需要保持状态或多次复用
- 作为模板参数传递
- 需要复杂的行为或策略
- 需要多态行为
- 性能敏感场景(内联优化)
何时使用Lambda:
- 简单、一次性操作
- 需要捕获局部变量
- 代码简洁性优先
- C++11及以上环境
仿函数设计原则:
- 保持
operator()为const(除非需要修改状态) - 提供清晰的命名
- 确保无副作用(或明确文档说明)
- 对于模板仿函数,提供类型约束(C++20概念)