来自上传文件中的文章《Evolving from Rule-based Classifier: Machine Learning Powered Auto Remediation in Netflix Data Platform》
本文介绍了Netflix如何将基于规则的错误分类器与机器学习服务集成,实现Spark作业失败的自动修复。技术亮点包括结合规则和ML智能、多目标优化性能与成本、全自动化配置应用。方法通过ML模型预测重试成功率和成本,利用贝叶斯优化推荐最佳配置。应用场景如自动修复内存配置错误和未分类错误,显著提升修复率和节省计算成本。
文章目录
-
- [1 引言](#1 引言)
- 1基于规则的分类器:基础与挑战
-
- [1.1 基础](#1.1 基础)
- [1.2 挑战](#1.2 挑战)
- [2 进化为自动修复:服务架构](#2 进化为自动修复:服务架构)
-
- [2.1 方法论](#2.1 方法论)
- [2.2 服务集成](#2.2 服务集成)
- [3 进化为自动修复:机器学习服务](#3 进化为自动修复:机器学习服务)
-
- [3.1 概述](#3.1 概述)
- [3.2 预测模型](#3.2 预测模型)
- [3.3 优化器](#3.3 优化器)
- [4 生产环境推广](#4 生产环境推广)
- [5 超越错误处理:迈向资源合理配置](#5 超越错误处理:迈向资源合理配置)
本文是Netflix利用数据洞察和机器学习(ML)提升大数据作业性能和成本效率的系列工作中的第一篇。运营自动化------包括但不限于自动诊断、自动修复、自动配置、自动调优、自动扩展、自动调试和自动测试------是现代数据平台成功的关键。在这篇博客中,我们介绍了"自动修复"项目,该项目将当前使用的基于规则的分类器与机器学习服务集成,旨在实现对失败作业的自动修复,无需人工干预。我们已在生产环境中部署了自动修复,用于处理Spark作业的内存配置错误和未分类错误,观察到其高效性和有效性(例如,自动修复了56%的内存配置错误,节省了所有错误导致的50%货币成本),并展现出进一步提升的巨大潜力。
1 引言
Netflix每天在多个大数据平台层级运行成千上万的工作流和数百万个作业。由于如此分布式大规模系统的广泛范围和复杂性,即使失败作业仅占总负载的一小部分,诊断和修复作业失败也会带来巨大的运营负担。
为实现高效的错误处理,Netflix开发了一个名为Pensive的错误分类服务,利用基于规则的分类器进行错误分类。该规则分类器基于预定义规则集对作业错误进行分类,并为调度器决定是否重试作业以及工程师诊断和修复失败提供洞察。
然而,随着系统规模和复杂性的增加,基于规则的分类器面临挑战,尤其是在支持运营自动化方面有限,特别是处理内存配置错误和未分类错误时。因此,运营成本随着失败作业数量线性增长。在某些情况下------例如诊断和修复因内存溢出(OOM)错误导致的失败------需要跨团队的联合努力,涉及用户本人、支持工程师和领域专家。
为解决这些挑战,我们开发了一个新功能,称为_自动修复_,它将规则分类器与机器学习服务集成。基于规则分类器的分类结果,机器学习服务预测重试成功概率和重试成本,并选择最佳候选配置作为推荐;配置服务则自动应用这些推荐。其主要优势如下:
- 集成智能。 自动修复并未完全废弃现有的规则分类器,而是将其与机器学习服务结合,充分利用两者优势:规则分类器提供基于领域专家上下文的静态、确定性的错误类别分类结果;机器学习服务则针对每个作业提供性能和成本感知的推荐。通过集成智能,我们能够满足不同错误修复的需求。
- 全自动化。 错误分类、获取推荐和应用推荐的流程完全自动化。它将推荐与重试决策一起提供给调度器,特别是使用在线配置服务存储并应用推荐配置,从而无需人工干预。
- 多目标优化。 自动修复生成推荐时同时考虑性能(即重试成功概率)和计算成本效率(即作业运行的货币成本),避免盲目推荐资源消耗过高的配置。例如,对于内存配置错误,它搜索多个与作业执行内存使用相关的参数,推荐能最小化失败概率与计算成本线性组合的配置组合。
这些优势已通过生产环境中修复Spark作业失败的部署得到验证。我们观察到自动修复能够成功修复约56%的内存配置错误,在线应用推荐配置无需人工干预;同时,由于能够推荐新配置使内存配置成功,或禁用不必要的重试,节省了约50%的成本。我们还注意到通过模型调优有很大的提升潜力(详见"生产环境推广"部分)。
1基于规则的分类器:基础与挑战
1.1 基础
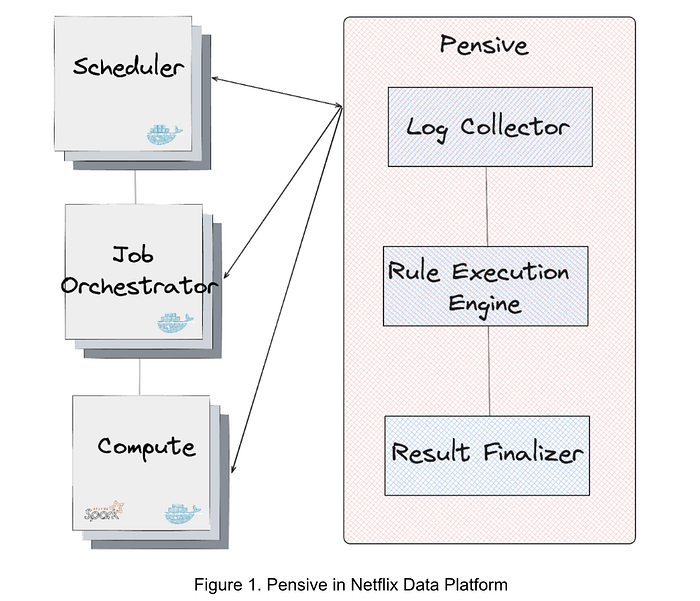
图1展示了数据平台中的错误分类服务Pensive。它利用基于规则的分类器,由三个组件组成:
- 日志收集器负责从不同平台层(如调度器、作业编排器和计算集群)拉取日志以进行错误分类。
- 规则执行引擎 负责将收集的日志与预定义规则集匹配。每条规则包含(1)错误名称、来源、日志和摘要,以及该错误是否可重启;(2)用于从日志中识别错误的正则表达式。例如,名为SparkDriverOOM的规则包含信息:如果Spark作业的stdout日志匹配正则表达式
_SparkOutOfMemoryError:_,则该错误被分类为用户错误,且不可重启。 - 结果终结器负责基于匹配的规则最终确定错误分类结果。如果匹配到一条或多条规则,则优先级最高(列表中最前)的规则决定最终结果;若无规则匹配,则该错误视为未分类。
1.2 挑战
尽管基于规则的分类器简单且有效,但其在处理配置错误和分类新错误方面能力有限,面临以下挑战:
- 内存配置错误。 规则分类器提供是否重启的错误分类结果,但对于非暂时性错误,仍依赖工程师手动修复。最显著的例子是内存配置错误。此类错误通常由作业内存配置不当引起:内存过小导致OOM错误,内存过大则浪费集群资源。更复杂的是,某些内存配置错误需调整多个参数,正确配置不仅需要手动操作,还需Spark作业执行的专业知识。此外,数据规模和作业定义变化也会导致性能退化。数据平台每月约有600个内存配置错误,及时修复需要大量工程投入。
- 未分类错误。 规则分类器依赖工程师基于已知上下文手动添加识别错误的规则,否则错误将被归为未分类。由于数据平台各层迁移及应用多样性,现有规则可能失效,新增规则需投入工程且受部署周期限制。尽管已添加300多条规则,但约50%的失败仍未分类。对于未分类错误,作业可能按照默认重试策略多次重试,若错误为非暂时性,这些失败重试导致不必要的运行成本。
2 进化为自动修复:服务架构
2.1 方法论
为应对上述挑战,我们的基本方法是将规则分类器与机器学习服务集成生成推荐,并使用配置服务自动应用推荐:
- 生成推荐。 首先用规则分类器对所有错误进行基于预定义规则的初步分类,随后由机器学习服务对内存配置错误和未分类错误提供推荐。
- 应用推荐。 使用在线配置服务存储并应用推荐配置。该流程全自动,生成推荐和应用推荐的服务解耦。
2.2 服务集成
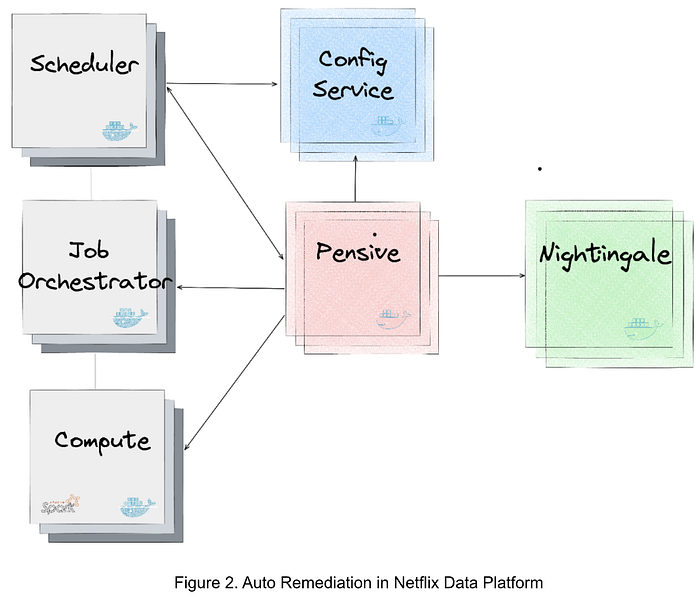
图2展示了数据平台中生成和应用推荐的服务集成。主要服务如下:
- Nightingale 是运行机器学习模型的服务,该模型使用Metaflow训练,负责生成重试推荐。推荐包括(1)错误是否可重启;(2)若可重启,推荐的重试配置。
- ConfigService 是在线配置服务。推荐配置以JSON补丁形式保存,作用域定义了可使用推荐配置的作业。当调度器调用ConfigService获取推荐配置时,传入原始配置,ConfigService返回应用JSON补丁后的变更配置,调度器据此用新配置重试作业。
- Pensive 是利用规则分类器的错误分类服务。它调用Nightingale获取推荐并将推荐配置存入ConfigService,供调度器重试时使用。
- Scheduler 负责调度作业(当前实现基于Netflix Maestro)。每当作业失败,调用Pensive获取错误分类以决定是否重试,并调用ConfigService获取重试配置。
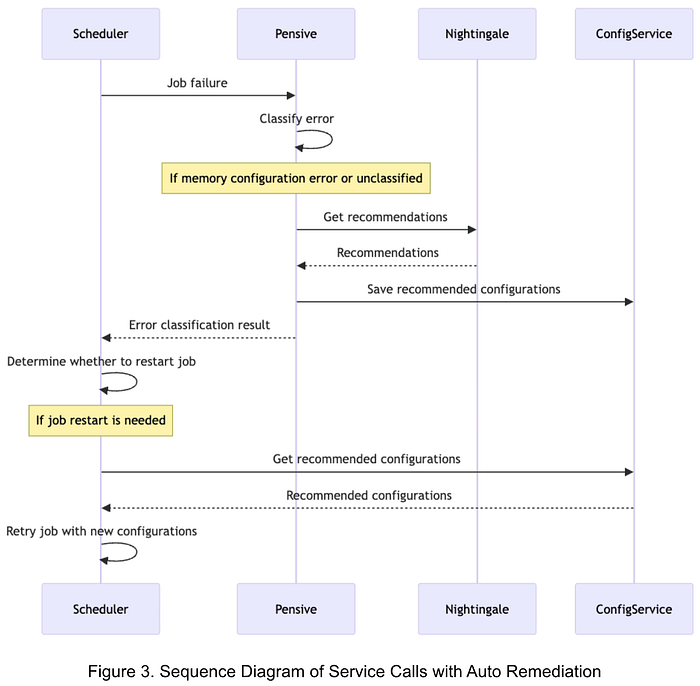
图3展示了自动修复的服务调用顺序:
- 作业失败时,调度器调用Pensive获取错误分类。
- Pensive基于规则分类器进行错误分类。若判定为内存配置错误或未分类错误,则调用Nightingale获取推荐。
- Pensive更新错误分类结果,保存推荐配置至ConfigService,并将分类结果返回调度器。
- 调度器根据分类结果决定是否重试。
- 重试前,调度器调用ConfigService获取推荐配置,使用新配置重试作业。
3 进化为自动修复:机器学习服务
3.1 概述
机器学习服务Nightingale旨在为失败作业生成兼顾重试成功概率和运行成本的重试策略。它包含两个主要组件:
- 预测模型:联合估计重试成功概率和重试成本(美元),条件基于重试属性。
- 优化器:探索Spark配置参数空间,推荐最小化重试失败概率和成本线性组合的配置。
预测模型每日离线重新训练,优化器在RESTful服务中运行,作业失败时调用。若找到可行配置,响应包含推荐配置,ConfigService据此变更重试配置;若无可行方案,响应包含禁用重试的标志,避免浪费计算资源。
3.2 预测模型
为探索不同配置下的重试成功率和成本变化,我们利用作业日志中记录的重试结果和执行成本作为可靠标签。由于共享特征集预测两个目标,标签充足且需快速在线推理以满足SLO,我们将问题建模为多输出监督学习,采用简单的多层感知机(MLP)模型,设有两个输出头分别预测两个目标。
训练: 训练集中的每条记录代表一次潜在重试,之前因内存配置错误或未分类错误失败。标签为:a)重试是否失败,b)重试成本。输入特征主要是作业的非结构化元数据,如Spark执行计划、执行用户、Spark配置参数及其他作业属性。我们将特征分为可解析为数值和不可解析两类。对高基数且动态的非数值特征(如用户名)使用特征哈希处理,生成低维嵌入,与归一化数值特征连接后输入后续层。
推理: 通过验证审核后,模型版本存储于内部ML平台提供的Metaflow Hosting服务。优化器针对每个配置请求多次调用模型预测函数,详见下文。
3.3 优化器
作业失败时,向Nightingale发送作业标识符,服务据此构造用于推理的特征向量。部分特征为可变的Spark配置参数(如spark.executor.memory、spark.executor.cores),这些是领域专家精选的调优参数。我们使用Meta的Ax库实现贝叶斯优化,探索配置空间并生成推荐。每次迭代,优化器生成一组候选参数值(如spark.executor.memory=7192 MB,spark.executor.cores=8),调用预测模型估计该配置下的重试失败概率和成本(即修改特征向量中的参数值)。迭代固定次数后,优化器返回最优配置(最小化失败概率和成本的线性组合),供ConfigService使用。如无可行配置,禁用重试。
迭代式设计的缺点是任何瓶颈都会阻塞完成并导致超时,初期我们观察到不少此类情况。通过分析发现,延迟主要来自候选生成步骤(即基于前次评估结果决定下一步方向)。该问题已反馈至Ax库开发者,新增了GPU加速API选项。利用该选项后,超时率显著降低。
4 生产环境推广
我们已在生产环境部署自动修复,处理Spark作业的内存配置错误和未分类错误。除重试成功率和成本效率外,用户体验是主要关注点:
- 内存配置错误: 由于无新配置的重试通常失败,自动修复能成功重试,减少运营负担并节省运行成本。失败重试不会恶化用户体验。
- 未分类错误: 自动修复根据机器学习模型预测是否重试。若重试成功概率极低,推荐禁用重试,节省不必要的运行成本。对于业务关键且用户偏好总重试的作业,可通过新增规则使错误由规则分类器识别,跳过机器学习服务推荐。这体现了规则分类器与机器学习服务集成智能的优势。
生产部署表明,自动修复能有效提供内存配置错误的配置推荐,自动修复约56%的内存配置错误,无需人工干预。同时,通过推荐新配置或禁用不必要重试,节省约50%的计算成本。性能与成本的权衡可通过机器学习服务调优来实现更高成功率或更多成本节约。
值得注意的是,目前机器学习服务采用保守策略禁用重试,避免影响偏好总重试的用户。虽然这类情况可通过新增规则解决,我们认为逐步调整目标函数以逐渐禁用更多重试,有助于提供理想用户体验。鉴于当前禁用策略较保守,自动修复未来有潜力在不影响用户体验的前提下带来更多成本节约。
5 超越错误处理:迈向资源合理配置
自动修复是我们利用数据洞察和机器学习提升用户体验、降低运营负担和提升数据平台成本效率的第一步。它聚焦于自动修复失败作业,但也为自动化其他运维任务铺路。
我们正在推动的一个项目称为_资源合理配置_,旨在重新配置定时大数据作业,使其请求适当的资源。例如,我们观察到Spark作业请求的平均执行器内存约为其最大实际使用内存的四倍,存在显著的资源过度配置。除了作业本身配置外,执行作业的容器资源过度配置亦可减少以节省成本。通过启发式和机器学习方法,我们能够推断合适的作业执行配置,最大限度减少资源浪费,节省数百万美元/年且不影响性能。与自动修复类似,这些配置可通过ConfigService自动应用,无需人工干预。资源合理配置项目正在进行中,后续将通过专门的技术博客详细介绍,敬请关注。