本文参考文章0.0 目录-深度学习第一课《神经网络与深度学习》-Stanford吴恩达教授-CSDN博客
1.深度学习的实用层面
1.训练/开发/测试集
在配置训练,验证和测试 数据集的过程在做出正确决策会在很大程度上帮助大家创建高效的神经网络。训练神经网络时,我们需要做很多决策,如:神经网络分多少层,每层的隐藏单元阿是多少,学习速率是多少,各层采用的激活函数
其实应用度学习是一个典型的迭代过程,需要多次循环往复,才能为应用程序找到一个称心的神经网络,因此循环该过程的效率是决定项目进展速度的一个关键因素,而创建高质量的训练数据集,验证集和测试集也有助于提高循环效率。
将数据集分为训练集,验证集和测试集。 在机器学习发展的小数据量时代,常见做法是将所有数据三七分,就是人们常说的70%验证集,30%测试集 ,如果没有明确设置验证集,也可以按照60%训练,20%验证和20%测试集来划分。 在大数据时代,比如说我们有100万条数据,那么取1万条数据便足以进行评估,找出其中表现最好的1-2种算法 。同样地,根据最终选择的分类器,测试集的主要目的是正确评估分类器的性能 ,所以,如果拥有百万数据,我们只需要1000条数据,便足以评估单个分类器,并且准确评估该分类器的性能。假设我们有100万条数据,其中1万条作为验证集,1万条作为测试集,100万里取1万,比例是1%,即:训练集占98%,验证集和测试集各占1%。对于数据量过百万的应用,训练集可以占到99.5%,验证和测试集各占0.25%,或者验证集占0.4%,测试集占0.1%。
总结一下,数据集规模相对较小,适用传统的划分比例,数据集规模较大的,验证集和测试集要小于数据总量的20%或10%。
2偏差/方差
我们总是分别考虑偏差和方差,现在来考虑一下两者的权衡问题
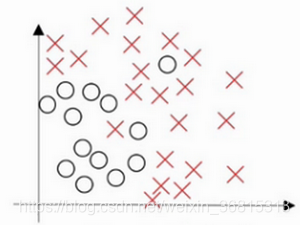
这是一个数据集,假设用一条直线拟合,效果不太理想,这是高偏差的情况, 称之为欠拟合
如果我们用一个非常复杂的分类器(深度神经网络或者含有隐藏单元的神经网络)可能会非常适合这个数据集,但是会出现方差过高的情况,称之为过拟合
在两者之中还有一种拟合度适合的分类器使数据分类更加合理,称之为适度拟合
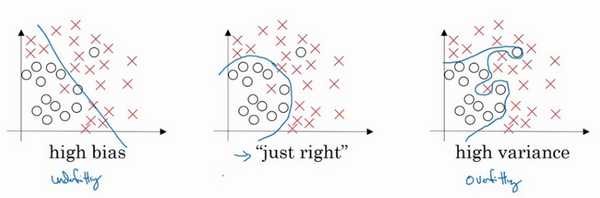
理解偏差和方差的关键是训练集误差和验证集误差
低训练误差 + 高验证误差:可能存在过拟合(高方差)。
高训练误差 + 高验证误差:可能存在欠拟合(高偏差)。
低训练误差 + 低验证误差:模型拟合良好。
训练误差是模型在训练数据集上的预测误差,反映模型对已知数据的拟合程度。验证误差是模型在独立验证数据集上的误差,用于评估模型的泛化能力。
训练误差:
验证误差:
为损失函数,
为模型预测,n和m分别为训练集与验证集样本量
3.机器学习基础
通常会用训练验证集来诊断算法是否存在偏差或方差问题
训练网络,选择网络或者准备更多数据,现在我们有工具可以做到在减少偏差或方差的同时,不对另一方产生过多不良影响
高方差(过拟合)的特征与解决
高方差表现为模型过于复杂,捕获了训练数据中的噪声而非真实规律:
- 特征:训练误差极低,但验证误差显著高于训练误差。
- 解决方法 :
- 增加训练数据量,减少噪声影响。
- 采用正则化技术(如L1/L2正则化)。
- 简化模型结构(如减少神经网络层数)。
- 使用早停(Early Stopping)防止训练过度。
高偏差(欠拟合)的特征与解决
高偏差表现为模型过于简单,无法捕获数据中的关键模式:
- 特征:训练误差和验证误差均较高,且两者接近。
- 解决方法 :
- 增加模型复杂度(如更多层或特征)。
- 延长训练时间或调整学习率。
- 引入更多相关特征或特征工程。
- 尝试更强大的模型(如从线性模型切换到树模型)。
4.正则化
鉴于本人数学水平不高,所以关于正则化的理解还不是很到位,看官可以通过这篇来熟悉熟悉
1.4 正则化-深度学习第二课《改善深层神经网络》-Stanford吴恩达教授_1.4正则化-CSDN博客
用途:增加数据量/正则化(首选)来解决过拟合(高方差)的问题
(正则化参数)通常使用验证集或交叉验证集来配置这个参数
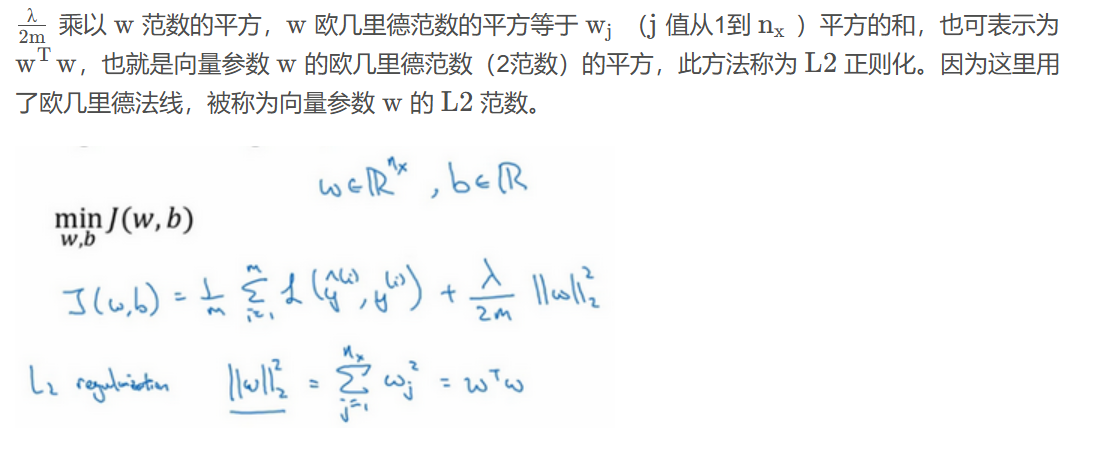
L2正则化(一般用L2而非L1):在损失函数中添加一个与权重平方相关的惩罚项,迫使模型学习更小的权重值,从而降低复杂度。
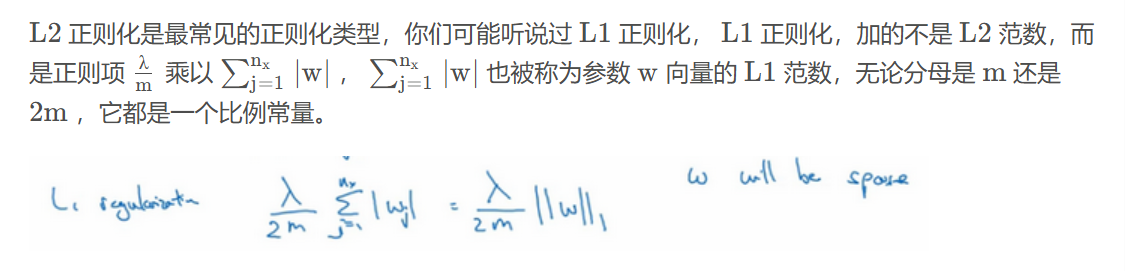
L1正则化:产生稀疏权重,适用于特征选择。
5.为什么正则化可以减少过拟合
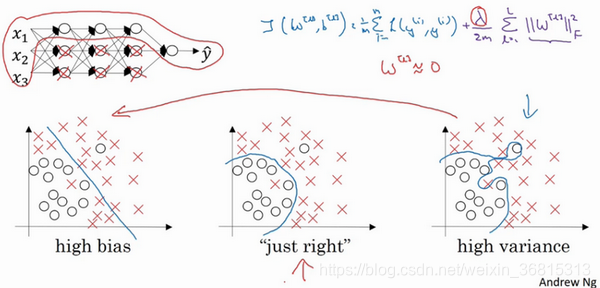
直观理解就是正则化设置得足够大,权重矩阵w被设置为接近于0的值,直观理解就是把多隐藏单元的权重设为0,于是基本上消除了这些隐藏单元的许多影响。可以大大简化神经网络,降低复杂度,这个神经网络越来越接近逻辑回归,可是深度却很大,它会使这个网络从过度拟合的状态更接近左图的高偏差状态。
正则化通过向损失函数中添加惩罚项,限制模型参数的大小或复杂度,从而避免模型过度依赖训练数据中的噪声或无关特征。过拟合通常发生在模型过于复杂时,能够记住训练数据中的噪声和细节。正则化通过限制参数的大小,有效降低了模型的复杂度 ,使其更倾向于学习数据中的普遍模式而非噪声。较小的参数值通常意味着模型对输入的变化更不敏感,从而减少了在训练数据上的过拟合风险。正则化通过平滑模型的输出,使其在未见过的数据上表现更好。某些正则化方法(如Dropout)通过在训练过程中随机丢弃部分神经元,模拟了数据增强的效果。这迫使模型不依赖于任何单一特征,从而提高了泛化能力。
6.Dropout正则化
dropout(随机失活)
工作原理:遍历网络的每一层,并设置消除神经网络中节点的概率。设置完节点概率,我们会消除一些节点,然后删除掉从该节点进出的连线,最后得到一个节点更少,规模更小的网络,然后用反向传播方法进行训练。
下图假设消除概率是0.5
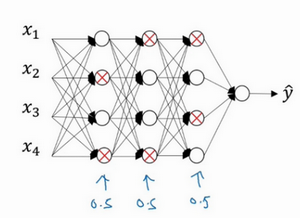
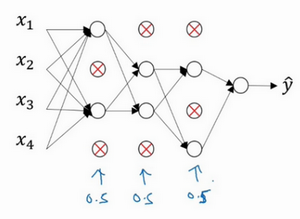
不过可想而知,我们针对每个训练样本训练规模极小的网络,最后你可能会认识到为什么要正则化网络,因为我们在训练极小的网络。
python实现方法:
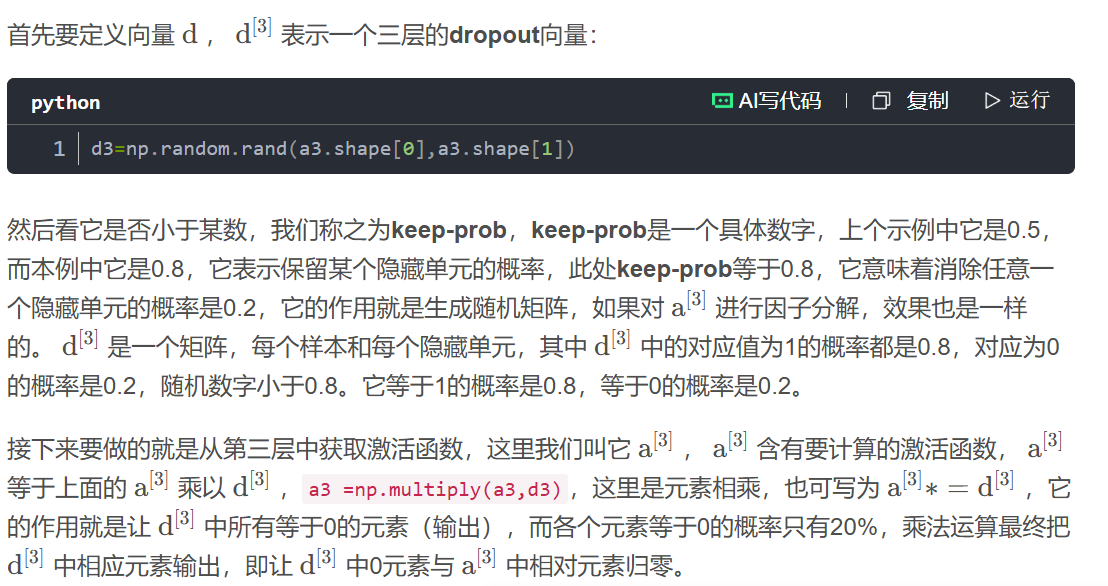
keep-prob(保留概率),下面简称为k,意味着我们删除了(1-k)*原有层节点,为了不影响本层的预测值,我们需要将
/(k),这样
的期望值就不会变
显然在测试阶段,我们并未使用dropout,自然也就不用抛硬币来决定失活概率,以及要消除哪些隐藏单元了,因为在测试阶段进行预测时,我们不期望输出结果是随机的,如果测试阶段应用dropout函数,预测会受到干扰。
7.理解dropout
直观上理解:不要依赖于任何一个特征,因为该单元的输入可能随时被清除,因此该单元通过这种方式传播下去,并为单元的四个输入增加一点权重,通过传播所有权重,dropout将产生收缩权重的平方范数的效果,和之前讲的L2 正则化类似;实施dropout的结果实它会压缩权重,并完成一些预防过拟合的外层正则化;L2 对不同权重的衰减是不同的,它取决于激活函数倍增的大小。
总结一下,dropout的功能类似于L2 正则化,与 L2 正则化不同的是应用方式不同会带来一点点小变化,甚至更适用于不同的输入范围
第二个直观认识是,我们从单个神经元入手,如图,这个单元的工作就是输入并生成一些有意义的输出。通过dropout,该单元的输入几乎被消除,有时这两个单元会被删除,有时会删除其它单元,就是说,我用紫色圈起来的这个单元,它不能依靠任何特征,因为特征都有可能被随机清除,或者说该单元的输入也都可能被随机清除。我不愿意把所有赌注都放在一个节点上,不愿意给任何一个输入加上太多权重,因为它可能会被删除,因此该单元将通过这种方式积极地传播开,并为单元的四个输入增加一点权重,通过传播所有权重,dropout将产生收缩权重的平方范数的效果,和我们之前讲过的L2 正则化类似,实施dropout的结果是它会压缩权重,并完成一些预防过拟合的外层正则化。
事实证明,dropout被正式地作为一种正则化的替代形式,L2 对不同权重的衰减是不同的,它取决于倍增的激活函数的大小。
总结一下,dropout的功能类似于L2 正则化,与 L2 正则化不同的是,被应用的方式不同,dropout也会有所不同,甚至更适用于不同的输入范围。
8.其他正则化方法
除了L2和随机失活(dropout)正则化,还有其他几种方法可以减少神经网络的过拟合
数据扩容:如果你想通过扩增训练数据来解决过拟合,但扩增数据代价高,而且有时候我们无法扩增数据,但我们可以通过添加这类图片来增加训练集
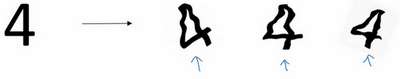
通过随意翻转和裁剪图片,我们可以增大数据集,额外生成假训练数据
对于光学字符识别,我们还可以通过添加数字,随意旋转或扭曲数字来扩增数据,把这些数字添加到训练集,它们仍然是数字。为了方便说明,我对字符做了强变形处理,所以数字4看起来是波形的,其实不用对数字4做这么夸张的扭曲,只要轻微的变形就好,我做成这样是为了让大家看的更清楚。实际操作的时候,我们通常对字符做更轻微的变形处理。因为这几个4看起来有点扭曲。所以,数据扩增可作为正则化方法使用,实际功能上也与正则化相似。
early stopping:在训练过程中,模型的性能通常会在训练集上持续提升,但在验证集上可能达到峰值后开始下降,这表明模型开始过拟合。早期停止通过监测验证集上的损失或准确率,在性能不再改善时终止训练。
9.归一化输入
归一化输入可以加速神经网络的训练,假设训练集有两个特征,输入特征为2维,归一化有两个步骤:1.归零值
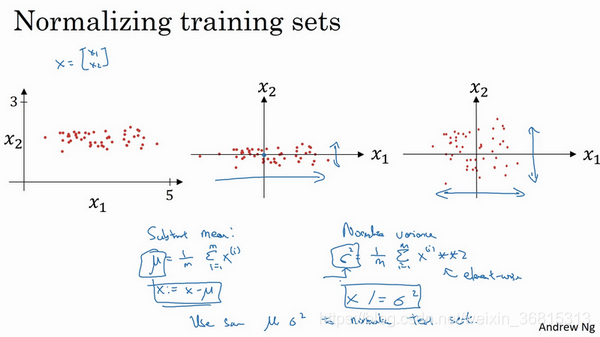
,它是一个向量,x等于每个训练数据x减去
,意思是移动数据集,指到它完成零均值化
2.归一化方差
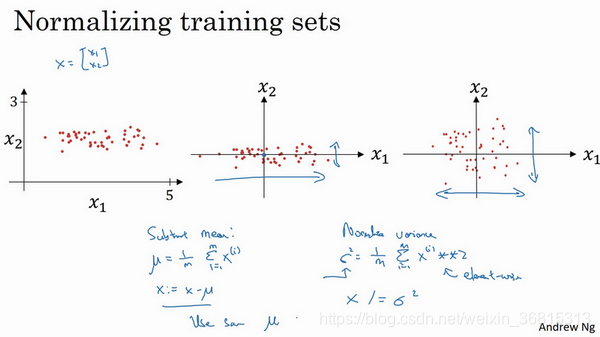
注意x1的方差比x2大,,
是一个向量,他的每个特征都是方差,
就是
的方差,我们把所有数据再除以
最后变成上图形式
训练集和测试集预估和
用的都是相同方法
我们为什么要这么做呢?为什么我们想要归一化输入特征,回想一下右上角所定义的代价函数
如果输入特征处于不同范围内,可能有些特征值从0到1,有些从1到1000,那么归一化特征值就非常重要了。如果特征值处于相似范围内,那么归一化就不是很重要了。
10.梯度消失与梯度爆炸
训练神经网络的时候,导数或坡度有时会变得非常大,或者非常小,甚至于以指数方式变小,这加大了训练的难度。
根据权重w与1的距离,激活函数y将会呈现w的指数级递增/减,导致训练难度上升
11.神经网络的权重初始化
**Xavier初始化(Glorot初始化)**适用于Sigmoid和Tanh激活函数。根据输入和输出的维度调整权重范围,保持方差一致。公式为:
或正态分布版本:
He初始化
针对ReLU及其变体(如Leaky ReLU)设计。放大方差以补偿ReLU的负半区置零。公式为:
或均匀分布:
LeCun初始化
类似Xavier但仅考虑输入维度,适用于SELU激活函数。公式为:
代码示例
python
import torch.nn as nn

# Xavier初始化(均匀分布)
linear = nn.Linear(100, 200)
nn.init.xavier_uniform_(linear.weight)

# He初始化(正态分布)
conv = nn.Conv2d(3, 64, kernel_size=3)
nn.init.kaiming_normal_(conv.weight, mode='fan_in', nonlinearity='relu')
12.梯度数值逼近与梯度检验及其应用注意事项
梯度数值逼近是一种通过有限差分法近似计算梯度的方法,适用于验证解析梯度的正确性。核心思想是利用函数在某点附近的小扰动来估计梯度。
对于函数其第 ( i ) 个参数的梯度可以通过双侧差分逼近:
,其中
是一个极小的正数
是第 ( i ) 个单位向量。
梯度检验通过比较数值梯度与解析梯度的差异,验证反向传播实现的正确性。
计算数值梯度:对每个参数,,使用双侧差分法计算数值梯度
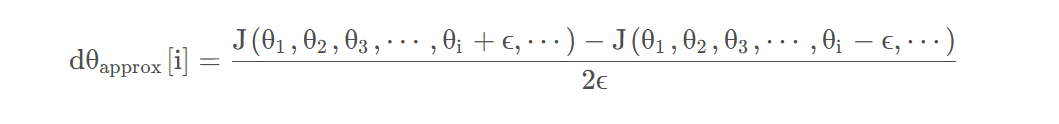
计算解析梯度:通过反向传播得到解析梯度
比较差异:计算相对误差:,若相对误差在 10^{-7} 量级,通常认为实现正确;若在 10^{-5} 量级,可能存在隐患;若超过 10^{-3} ,大概率存在错误。
代码示例
python
def gradient_check(f, x, analytic_grad, epsilon=1e-5):
    numeric_grad = np.zeros_like(x)
    for i in range(x.size):
        x_plus = x.copy()
        x_plus[i] += epsilon
        x_minus = x.copy()
        x_minus[i] -= epsilon
        numeric_grad[i] = (f(x_plus) - f(x_minus)) / (2 * epsilon)

    numerator = np.linalg.norm(analytic_grad - numeric_grad)
    denominator = np.linalg.norm(analytic_grad) + np.linalg.norm(numeric_grad)
    relative_error = numerator / denominator
    return relative_error
应用注意事项:
梯度检验只用于调试,来确认数值是否接近,完成后,会关闭梯度检验,梯度检验的每一个迭代过程都不执行它,因为它太慢了。
如果检验失败,需要检查每一项,找出不同的i值,看看是哪个导致比较差异过大
在梯度检验中,如果使用正则化,请注意正则项,如果代价函数,这就是代价函数J的定义,
等于
相关的J函数的梯度,包含这个正则项
梯度检验不能与dropout同时使用