作者:Gundy
1. 场景与目标
UGC 社区典型特点:内容量大、更新快、长尾重。推荐系统要同时兼顾"眼下的即时兴趣 "和"用户的稳定偏好 ",并在一次请求内完成多路候选召回与融合,保证毫秒级延迟。 本文给出一套双向量用户兴趣 + 一次 SQL 多路召回 的实践方案,数据库层使用 OceanBase 原生向量能力,结构化与向量同库,避免"两库同步/一致性坑"。
2. 为什么选 OceanBase(直说三点)
一体化 :结构化表 + VECTOR 列 + HNSW/IVF 向量索引在同一库里,天然支持事务一致性(更新浏览计数与短期向量可放在一个事务里)。
兼容 MySQL 技术栈:接入/运维成本低,迁移平滑。
分布式弹性:内容库增长和 QPS 抖动时,水平扩展更从容。
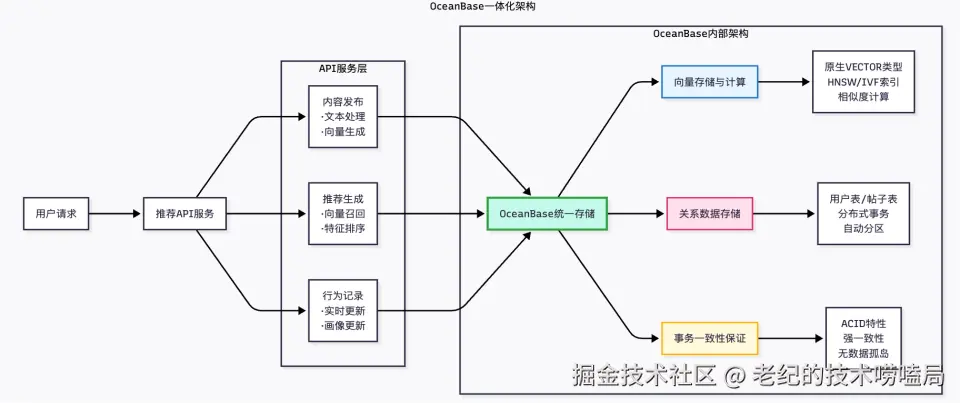
3. 表结构(贴近你 PPT 的建模)
内容表(帖子/短视频等)
plain
CREATE TABLE posts (
  post_id        BIGINTPRIMARY KEY,
  author_id      BIGINT,
  title          VARCHAR(255),
  content        TEXT,
  created_at     DATETIME,
  status         TINYINT DEFAULT1,          -- 1上线
  pop_7d         FLOATDEFAULT0,            -- 近7日人气
  content_vector VECTOR(768),                -- 原生向量
  VECTOR KEY idx_vec (content_vector)
    WITH (DISTANCE = COSINE, TYPE = HNSW, M=16, EF_CONSTRUCTION=200, EF_SEARCH=64)
);
用户表(双向量:短期 + 长期)
plain
CREATE TABLE users (
  user_id            BIGINT PRIMARY KEY,
  short_term_vector  VECTOR(768),  -- 即时兴趣(秒级更新)
  long_term_vector   VECTOR(768),  -- 稳定偏好(天级/小时级更新)
  region             VARCHAR(32),
  updated_at         DATETIME
);
行为表(去重/特征)
plain
CREATE TABLE user_actions (
  user_id  BIGINT,
  post_id  BIGINT,
  action   ENUM('view','like','collect','comment','share'),
  ts       DATETIME,
  PRIMARY KEY(user_id, post_id, action, ts)
);
4. 双向量兴趣:怎么产出 & 怎么更新
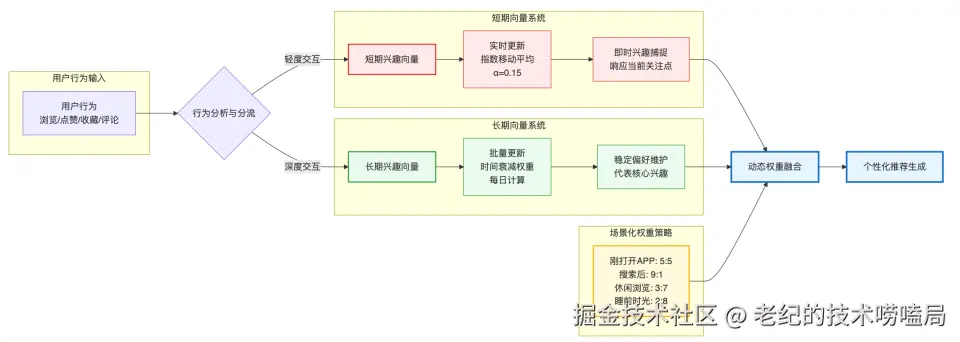
4.1 训练与产出(简述)
长期向量:双塔/对比学习,将历史多天行为聚合(mean/attention pooling),日更或小时更。
短期向量 :会话级序列(最近 N 次曝光/点击)用轻量 Transformer/SASRec 产出,实时/秒级更新。
4.2 在线更新
同一事务中更新浏览计数与短期向量,避免"计数+画像不同步":
plain
BEGIN;
UPDATE posts SET view_count = view_count + 1 WHERE post_id = ?;
UPDATE users SET short_term_vector = ? WHERE user_id = ?;
COMMIT;
短期向量的在线融合
plain
def update_short_term_vector(user_id, post_vec, action):
    w = {'view':0.1, 'like':0.3, 'collect':0.5}.get(action, 0.1)
    new_vec = 0.85 * current_short_vec(user_id) + 0.15 * w * post_vec
sql("UPDATE users SET short_term_vector=? WHERE user_id=?", [new_vec, user_id])直观点:短期追新,长期守稳;两者同时存在才不会"越推越窄"或"越推越慢"。
5. 一次查询,多路召回(核心 SQL)
目标:一次请求 同时召回"短期兴趣近邻""长期兴趣近邻",并叠加新鲜度 与人气,再统一排序。
关键点:强过滤先行(上架、时间窗、地域/类目等),不做过滤等着 P95 爆炸。
plain
-- 取出用户双向量
WITH user_vectors AS (
SELECT short_term_vector AS svec, long_term_vector AS lvec
FROM users WHERE user_id = :uid
),
-- 路1:短期兴趣召回(响应快,抓当前关注)
short_pool AS (
SELECT p.post_id, p.title,
         COSINE_SIMILARITY(p.content_vector, uv.svec) AS sim,
         p.created_at, p.pop_7d, 'short'AS src
FROM posts p, user_vectors uv
WHERE p.status=1
    AND p.created_at > DATE_SUB(NOW(), INTERVAL7DAY)           -- 新鲜度强过滤
    ANDNOTEXISTS (SELECT1FROM user_actions ua
                    WHERE ua.user_id=:uid AND ua.post_id=p.post_id) -- 去已看
ORDERBY p.content_vector <-> uv.svec
  LIMIT 200
),
-- 路2:长期兴趣召回(稳定偏好)
long_pool AS (
SELECT p.post_id, p.title,
         COSINE_SIMILARITY(p.content_vector, uv.lvec) AS sim,
         p.created_at, p.pop_7d, 'long'AS src
FROM posts p, user_vectors uv
WHERE p.status=1
    AND p.created_at > DATE_SUB(NOW(), INTERVAL30DAY)
ORDERBY p.content_vector <-> uv.lvec
  LIMIT 200
),
-- 融合 + 评分(语义相似 + 新鲜度 + 人气)
merged AS (
SELECT post_id, title, src,
         (CASE src WHEN'short'THEN0.7ELSE0.3END) * sim      -- 双向量权重(PPT思路)
         +0.1*LOG(1+ pop_7d)
         +0.2*EXP(- TIMESTAMPDIFF(HOUR, created_at, NOW()) /72.0) AS score
FROM short_pool
UNIONALL
SELECT post_id, title, src,
         (CASE src WHEN'short'THEN0.7ELSE0.3END) * sim
         +0.1*LOG(1+ pop_7d)
         +0.2*EXP(- TIMESTAMPDIFF(HOUR, created_at, NOW()) /72.0) AS score
FROM long_pool
)
SELECT post_id, title, MAX(score) AS final_score
FROM merged
GROUPBY post_id, title
ORDERBY final_score DESC
LIMIT 50;
要点
1.COSINE_SIMILARITY直接用相似度(0~1),不要 distance 再 1-distance,阈值语义清晰。
2.新鲜度、人气做轻权重加成,防止纯语义把"陈年老贴"顶上来。
3.已看过过滤必须在 DB 层完成,避免服务端侧再次 Join 带来不一致。
6. 精排与多样性(简化可上线)
精排 :先上轻量 GBDT/LightGBM,把 sim_short、sim_long、pop_7d、age 等作为特征;预算充足再上 DNN。
多样性:MMR(最大边际相关性)对相似帖子做惩罚,控制主题/作者/价格带占比,避免信息茧房。
业务约束:状态、合规、黑白名单、广告混排(统一归一化,避免量纲冲突)。
7. 性能与运维(踩坑直说)
强过滤先行 :status、时间窗、地域/类目 一定要在 KNN 之前过滤,减少参与向量搜索的数据量。
索引参数 :HNSW 的 M/EF_SEARCH 做 A/B 压测(召回@K vs P95);内容超大时热冷分层(热:HNSW;冷:IVF-PQ)。
一致性 :用户短期向量更新与行为写入同事务 ;模型换代时记得做向量版本与灰度
度量:在线监控 CTR/CVR、P50/P95、短期/长期池贡献占比、已看过命中率、新鲜度指标。
8. MVP 路线(两周能落地)
建表 :posts / users / user_actions(如上)。
向量 :离线产出 long_term_vector;实时流更新 short_term_vector。
召回:用上面"一次 SQL 多路召回",直接能跑;
精排:先用 GBDT,支持快速特征迭代;
监控 :打点记录 sim_top1、来源池(短/长)、延迟、去重率、曝光→点击漏斗;
迭代 :每周校准 HNSW 参数与权重 0.7/0.3、新鲜度衰减系数。
9. 常见问题(按坑给答案)
- Q:只用一个用户向量行不行?
A:不建议。UGC 的兴趣是多峰的,单向量容易"偏科"。短期追新 + 长期守稳是你 PPT 的精华。
- Q:为什么把融合和排序放在数据库里?
A:少一次网络往返 + 数据局部性好,延迟更稳;SQL 清晰可审计,复盘更容易。
- Q:新内容如何冷启动?
A:内容向量 + 新鲜度加权 + 小流量探索(ε-greedy/UCB)。有创作者关系的,优先推给关注者的短期近邻。
结语
UGC 社区的推荐不需要花哨堆栈,核心就三件事:
一是双向量建模同时覆盖即时兴趣与稳定偏好;
二是用 OceanBase 原生向量把"结构化 + 向量 + 事务"放在同一库里;
三是通过 一次 SQL 多路召回把短期池、长期池、时间与人气统一融合,端到端稳定提速。
根据本文结构化表、SQL 与更新策略上线,即可做出一个快、稳、可迭代的 UGC 个性化推荐系统。
最后为大家推荐这个 OceanBase 开源负责人老纪的公众号「老纪的技术唠嗑局」,会持续更新和 #数据库 、#AI 、#技术架构 相关的各种技术内容。欢迎感兴趣的朋友们关注!
「老纪的技术唠嗑局」不仅希望能持续给大家带来有价值的技术分享,也希望能和大家一起为开源社区贡献一份力量。如果你对 OceanBase 开源社区认可,点亮一颗小星星✨吧!你的每一个Star,都是我们努力的动力。