1. 线程概念
1.1 什么是线程
核心定义和特性
-
基本定义
线程(thread)是进程内部的一个执行路线或控制序列,本质上是程序执行流的最小单元。一个进程至少包含一个线程(主线程),也可包含多个线程实现并发执行。
-
与进程的关系
- 资源归属:线程在进程的地址空间内运行,共享进程的资源(如内存、文件描述符、页表等),但拥有独立的执行上下文(如程序计数器、寄存器集合、私有堆栈)。
- 调度单位:线程是操作系统调度的基本单位(处理机分配实体),而进程是资源分配的基本单位。线程切换的开销远小于进程切换,因其无需切换地址空间。
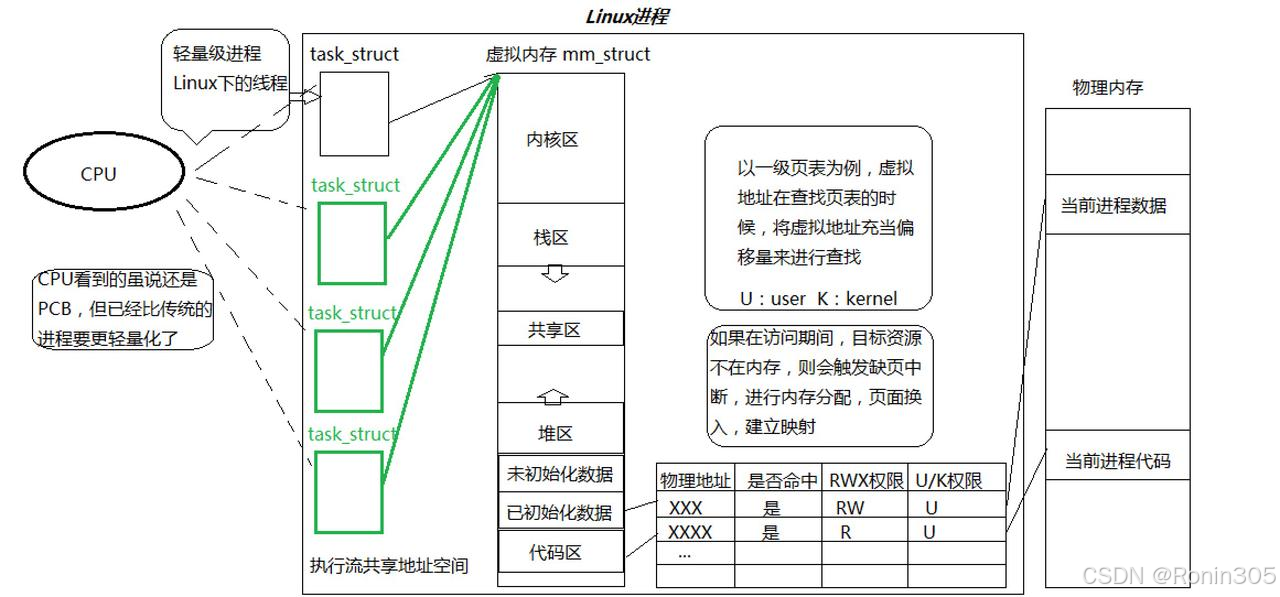
- 轻量化:在Linux中,线程通过复用进程的PCB(进程控制块)实现,称为轻量级进程(LWP),CPU视角下其PCB比传统进程更轻量。
-
资源划分机制
- 共享资源:所有线程共享进程的虚拟地址空间、页表、全局变量等资源。操作系统通过页表机制将物理内存映射到线程的私有堆栈,实现资源隔离与共享。
- 资源分配 :内核将进程资源(如CPU时间片、内存区域)分配给各线程执行流,形成并发执行。例如,主线程从
main()函数启动,其他线程执行特定任务。 - Linux的特殊性:Linux无真正的线程数据结构,而是用进程PCB模拟线程(轻量级进程),用户层通过线程库(如pthread)封装接口。
-
关键特性
- 并发性:多线程使进程内任务并发执行,提高效率(如一个线程处理I/O时,另一线程可计算)。
- 独立性:每个线程有独立的执行流和上下文,但需同步机制(如互斥锁、条件变量)协调共享资源访问。
- 组成要素:线程包含线程ID、程序计数器、寄存器集合和私有堆栈。
示例:某进程创建两个线程执行任务task1和task2,它们共享进程的内存和文件资源,但各自拥有寄存器、堆栈等执行上下文,内核通过调度器分配CPU时间片实现并发运行。
我们可以通过一个通俗一点的示例,来详细的认识一下:
想象一下,你开了一家创业公司(这就是一个进程)。公司有:
-
办公场地 (这就是进程地址空间,包括代码区、数据区、堆、栈等)。
-
营业执照、银行账户、打印机等办公设备 (这些是系统资源,如文件、信号、CPU时间等)。
一开始,公司只有你一个光杆司令(这就是单线程进程)。你既要写代码,又要做设计,还要回复客服邮件。所有事情你都得一件一件做,效率很低。
后来公司发展了,你招了几个员工。现在的情况是:
-
你们共享同一个办公场地、营业执照、银行账户和打印机 。(这就是线程共享进程的大部分资源)。
-
但每个员工都有自己的办公桌和待办事项清单 。(这就是每个线程有自己独立的栈空间 和执行流)。
-
你们可以同时做不同的事情 :你写代码,设计师做图,客服回邮件。(这就是并发执行)。
在这个比喻里,每个员工就是一个线程。他们是公司内部独立的执行路线,共享公司的绝大部分资源,但又有自己独立的任务和"工作台"(栈)。
内核是如何进行资源划分的?
这才是理解线程的关键!操作系统(内核)是这家公司的"物业管理系统"和"调度中心"。
1. 传统进程(单线程)在内核眼中的样子:
内核会为你这家公司(进程)建立一个档案,叫做 PCB(进程控制块 ,在Linux里是 task_struct 结构体)。这个档案非常庞大,记录了公司的所有信息:地址空间、打开的文件、信号、状态、进程ID(PID)等等。在CPU看来,调度一个进程就是根据这个厚厚的档案来安排工作。
2. 多线程进程在内核眼中的样子:
当你创建了多个线程后,内核的做法变了:
-
"分而治之" :内核不会再为整个公司只建立一个厚厚的档案。相反,它会为你和你的每个员工分别建立一个小档案。
-
这些"小档案"就是线程的控制结构 (在Linux中,它同样也叫
task_struct)。这意味着,在内核看来,每一个线程都是一个独立的调度单位,和进程没有区别(这也是为什么Linux的线程被称为"轻量级进程(LWP)")。 -
资源共享 :这些"小档案"(线程的
task_struct)中,绝大部分内容都是指向同一个地址空间和同一套系统资源的指针。也就是说,它们记录的是:"这个线程属于哪家公司(哪个进程),共享着哪里的资源"。
所以,内核进行资源划分的核心是:
-
【共享的资源】 :通过让多个
task_struct指向相同的 内存地址空间、文件描述符表、信号处理方式等,来实现资源的共享。这些资源是进程级别的。 -
【独享的资源】:
-
线程ID(TID)
-
独立的栈空间:这是最重要的独享资源!每个线程都有自己的栈,用于存放函数调用参数、局部变量等。这样它们执行不同的函数时才不会互相干扰。
-
寄存器状态:当线程被换下CPU时,它的寄存器状态(如程序计数器PC指向下一句要执行的代码)被单独保存,以便下次接着执行。
-
errno 变量 :每个线程有自己的
errno,避免一个线程的错误码覆盖另一个线程的。 -
信号掩码
-
调度优先级
-
这就是所谓的"资源划分":内核通过精巧的数据结构设计,让线程们"共享该共享的,隔离该隔离的"。
尤其是代码
"代码"部分,是理解线程的重中之重。
-
代码是共享的 :所有线程都生活在同一个进程地址空间里,这意味着它们看到的是同一份代码 (代码段/text段)。
main函数、printf函数、你写的worker_thread函数,所有这些指令都在同一个地方。 -
执行路线是独立的 :虽然代码是同一份,但每个线程的程序计数器(PC寄存器)是独立的。PC寄存器指向当前线程正在执行的下一条指令的地址。
-
线程A的PC可能正指向
main函数中的第100行。 -
线程B的PC可能正指向
worker_thread函数中的第50行。 -
它们都在从同一本"代码手册"里读指令,但翻到了不同的页。
-
这就完美诠释了:"在一个程序里的一个执行路线就叫做线程"。
-
"一个程序" = 同一份代码、同一个地址空间。
-
"一个执行路线" = 一个独立的PC计数器、一套独立的寄存器、一个独立的栈。
1.2 问题
问题1:为什么要这样设计?(共享资源,独享栈和上下文)
这种设计(线程共享进程的绝大部分资源,但拥有自己独立的执行上下文)是为了解决两个核心问题:性能开销 和数据共享的便捷性。它是并发编程发展中的一个重要权衡和优化。
1. 为了效率:创建、销毁、切换的代价极低
-
创建线程 vs 创建进程 :创建一个新进程(
fork())需要为它创建一个独立的、庞大的地址空间,复制父进程的页表,管理大量的资源。这就像为了开一个新部门,直接复制了一家完整的子公司,开销巨大。而创建一个新线程,内核主要只是分配一个较小的task_struct并为其分配一个新的栈空间,其他绝大部分资源都共享自进程。这就像在公司内部给一个新员工分配一张办公桌,速度快得多。 -
销毁线程 vs 销毁进程:同理,销毁线程只需回收其独享的栈等少量资源,而销毁进程需要回收整个地址空间和所有资源。
-
切换线程 vs 切换进程 :这是最重要的效率提升。CPU在不同任务间切换时,需要保存当前任务的上下文(寄存器等),并加载下一个任务的上下文。进程切换 伴随着地址空间的切换 ,这需要刷新CPU的TLB(快表) ,导致内存访问在一段时间内变慢,开销巨大。而线程切换 发生在同一个地址空间内,无需切换地址空间和刷新TLB,因此切换速度非常快。
2. 为了便捷的通信和数据共享
-
进程间通信(IPC) :进程拥有独立的地址空间,一个进程无法直接访问另一个进程的数据。必须通过操作系统提供的、相对复杂的进程间通信(IPC)机制,如管道、消息队列、共享内存等。这些机制要么需要系统调用,要么需要复杂的同步,既慢又麻烦。
-
线程间通信 :线程共享进程的全局变量和堆内存。一个线程写入全局变量,另一个线程可以直接读取,天然共享。这使得线程间交换数据变得极其简单和快速。
- 代价与风险 :这种便捷性也带来了巨大的风险:竞态条件(Race Condition) 和数据不一致 。因此,必须引入同步机制(如互斥锁、信号量) 来保护共享资源,否则极易出错。这是编写多线程程序的主要复杂之处。
总结来说,这样设计是为了:
-
极大地提升创建、销毁、切换的效率,使得程序可以轻松创建成百上千个"执行流"而不会压垮系统。
-
提供一种极其高效、自然的数据共享方式,让属于同一任务的多个执行部分可以紧密协作。
这是一种用更轻量的管理开销 和更简单的数据共享 来换取更强的并发能力的设计哲学。
问题2:其他平台呢?也是这样的吗?
不完全是。 Linux的"线程即轻量级进程"模型只是实现线程的一种方式,称为 1:1 模型(一对一模型)。不同的操作系统有不同的实现方案,主要分为三种模型:
1. 1:1 模型(一对一模型) - Linux, Windows, macOS 的默认模式
-
如何实现 :正如之前所说,每一个用户态的线程都直接对应一个内核级的调度实体(一个轻量级进程/Kernel Thread)。
-
优点:
-
真正的并行:由于内核直接管理每一个线程,当有多个CPU核心时,多个线程可以被真正地同时调度到不同核心上执行。
-
responsiveness:当一个线程阻塞(如等待I/O)时,内核可以立刻调度同一个进程内的其他线程运行,不会阻塞整个进程。
-
-
缺点:
-
开销相对较大:虽然比进程轻量,但创建大量线程(例如成千上万个)时,每次创建仍需进行系统调用,内核的管理开销(如每个线程都需要占用一些内核内存)会积累。
-
线程数量限制:受限于内核资源,能创建的线程数量有一个上限。
-
2. N:1 模型(多对一模型) - 用户态线程/协程
-
如何实现 :所有用户线程的创建、调度、同步全部在用户空间 的一个运行时库(如早期的Green Threads)中完成,N个用户线程映射到1个内核线程。内核对此一无所知,它只知道一个进程(及其唯一的内核线程)。
-
优点:
-
极致轻量:线程切换无需陷入内核(系统调用),代价极低。
-
可创建大量线程:几乎只受用户空间内存限制。
-
-
缺点:
-
无法利用多核:由于内核只看到一个执行流,无法将线程调度到多个CPU核心上并行执行。
-
一个阻塞,全家遭殃:只要有一个用户线程发起了阻塞式系统调用(如读文件),整个进程(包括它所有的用户线程)都会被内核挂起。
-
3. M:N 模型(多对多模型) - 两层级调度
-
如何实现 :这是一种混合模型,旨在结合前两者的优点。M个用户线程映射到N个内核线程(N <= M)。由一个用户态的调度器和内核的调度器协同工作。
-
目标:既能像N:1模型那样创建大量轻量级用户线程,又能像1:1模型那样利用多核并行执行,并能避免整个进程因一个阻塞调用而挂起。
-
现实 :实现极其复杂,需要在用户态和内核态做复杂的调度协调。虽然很多系统(如Solaris)曾尝试过,但最终都因为复杂性和性能问题,逐渐转向了1:1模型。
各平台现状:
-
Linux : 严格采用 1:1 模型 。通过
pthread库(如NPTL)实现,线程就是轻量级进程。 -
Windows : 采用 1:1 模型。Windows内核有明确的内核线程对象(TCB),与用户线程直接对应。
-
macOS : 同样采用 1:1 模型。
-
其他实现 :虽然主流OS内核线程都用1:1模型,但 N:1模型的思想在用户态得到了复兴 ,这就是协程(Coroutine) 或 纤程(Fiber,Windows下的概念)。像Go语言的goroutine、Python的gevent等,都是在用户态实现的轻量级"线程",由自身的运行时在少量的内核线程上进行调度,完美解决了N:1模型的缺点(能利用多核、阻塞调用由运行时接管并切换),成为了实现高并发的新宠。
结论:
从内核角度看,主流操作系统(Linux, Windows, macOS)都采用了1:1线程模型,因为它们需要真正的硬件并行能力。 而更轻量的并发方案(如N:1, M:N)则以用户态运行时库(如Go、Java Project Loom) 的形式存在,作为对内核线程的补充,用于特定的高并发场景。
总结:
前面在介绍进程时,我们就说:进程 = 内核数据结构 + 代码和数据(注意内核数据结构不止是task_struct,还包括其中的各种数据结构,比如:进程虚拟地址mm_struct等包含在task_struct内的各种数据结构)。而线程则是进程内轻量级的执行流,共享进程资源但独立调度。线程和进程在内核看来都是 task_struct ,只是共享资源的 task_struct 们被组成了一个"进程";一个"进程"只是一个没有共享资源(特别是地址空间)的"线程";而一个"线程"就是一个与其它"线程"共享了大量资源(特别是地址空间)的"进程"。
如下图:
2. 分页式存储管理
2.1 虚拟地址和页表的由来
思考一下,如果在没有虚拟内存和分页机制的情况下,每一个用户程序在物理内存上所对应的空间必须是连续的,如下图:
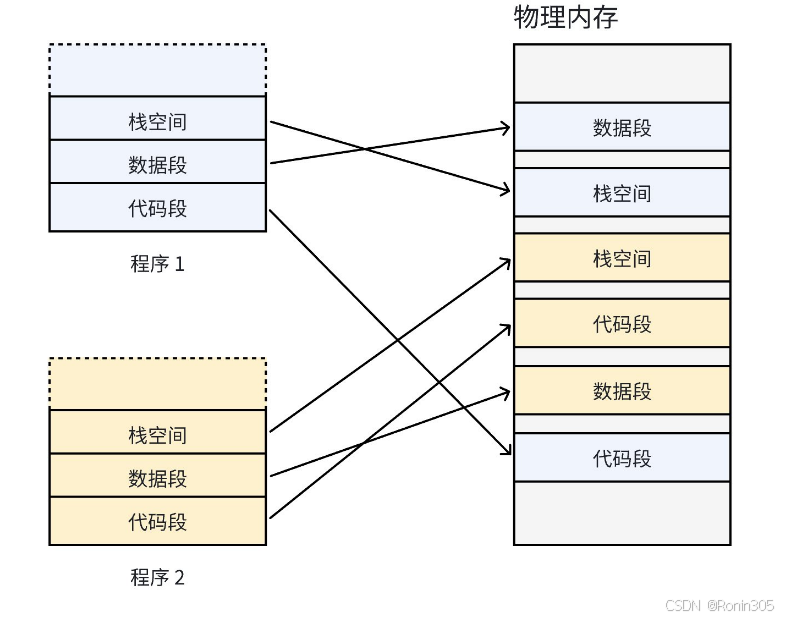
核心问题:物理内存分配的困境
-
需求 :用户程序希望使用连续的、巨大的地址空间(如 0x00000000 到 0xFFFFFFFF)。
-
现实:物理内存是有限的,且程序频繁地加载和退出。
-
直接映射的后果 :如果直接将程序的连续地址空间映射到物理内存,会导致外部碎片。即物理内存中充斥着大量不连续的、大小不一的小块空闲内存,虽然总空闲内存可能很多,但无法分配出一块足够大的连续空间来加载一个新程序,导致内存利用率低下。
-
示例场景: 假设物理内存有64MB,先后运行了三个程序:
- 程序1:占用20MB(地址0-20M)
- 程序2:占用15MB(地址20-35M)
- 程序3:占用10MB(地址35-45M) 当程序2退出后,中间会留下15MB的"空洞",虽然总空闲内存有15+19=34MB,但无法直接加载一个需要30MB的程序。
怎么办呢?我们希望操作系统提供给用户的空间必须是连续的,但是物理内存最好不要连续。此时虚拟内存和分页便出现了,如下图所示:
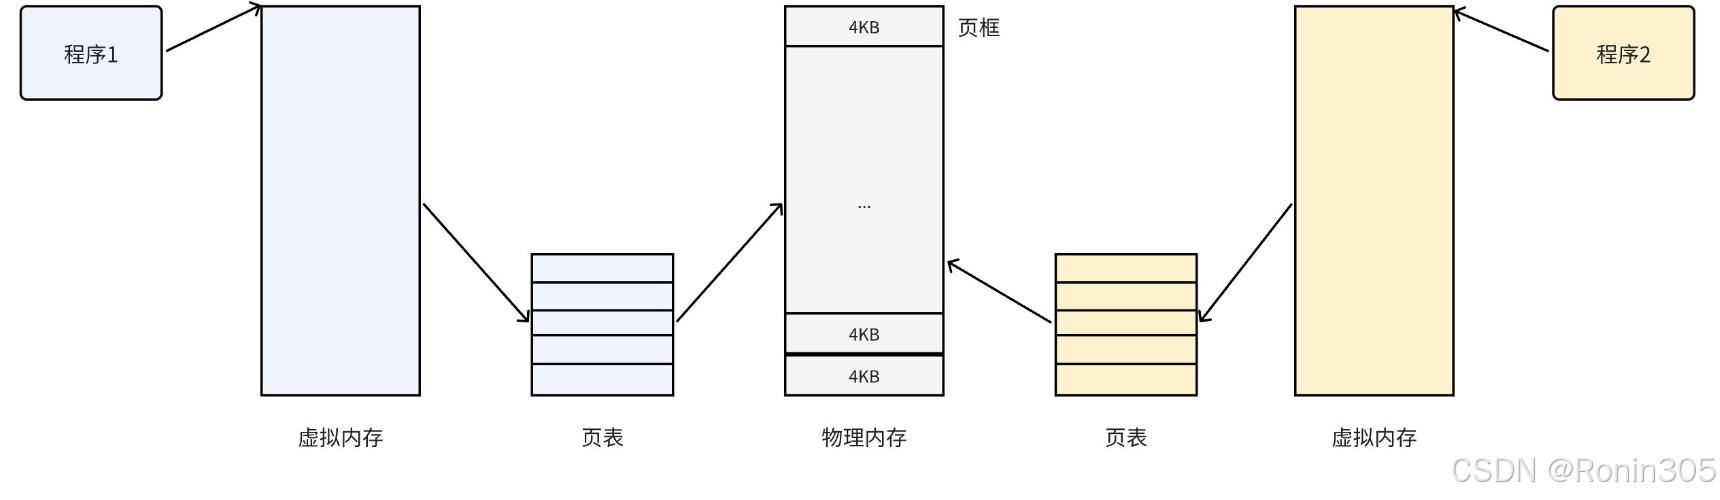
物理内存的分割
物理内存被划分为固定大小的"页框"(page frame),有时也称为物理页。每个页框包含一个物理页(page)。页的大小与页框大小相等。不同体系结构支持不同的页大小:
- 32位体系结构通常支持4KB(4096字节)的页
- 64位体系结构一般支持更大的页,如8KB(8192字节)
页与页框的区别
理解这两个概念的差异非常重要:
- 页框:是物理内存中的一个固定大小的存储区域,是实际的硬件资源
- 页:是一个数据块,可以存储在任意页框或磁盘中,是逻辑上的数据单元
通俗点说:
-
页框 :是物理内存的容器,是一个"空房子"。
-
页 :是数据的内容,是一个"住户",可以住进任何一个"空房子"(页框),也可以暂时搬到"乡下"(磁盘)去住。
虚拟地址空间
CPU并不直接访问物理内存地址,而是通过虚拟地址空间间接访问。虚拟地址空间是操作系统为每个正在执行的进程分配的逻辑地址范围:
- 在32位系统中,范围是0 ~ 4GB-1(2^32-1)
- 在64位系统中,理论上是0 ~ 16EB-1(2^64-1),但实际实现会小一些
页表的作用
操作系统通过建立页表(page table)来实现虚拟地址到物理地址的映射:
- 页表记录了每个虚拟页与物理页框的对应关系
- 当CPU访问虚拟地址时,内存管理单元(MMU)会自动查询页表将其转换为物理地址
- 这种转换对应用程序完全透明,保持了地址空间的连续性
分页技术的优势
这种机制的核心思想是:
- 将虚拟地址空间划分为若干页
- 将物理内存空间划分为若干页框
- 通过页表建立映射关系
这样带来的好处包括:
- 解决内存碎片问题:连续的虚拟内存可以映射到多个不连续的物理页框
- 提高内存利用率:可以更灵活地分配物理内存
- 支持内存保护:不同进程的地址空间完全隔离
- 实现虚拟内存:可以将不常用的页交换到磁盘
实际应用示例
考虑一个简单的场景:一个程序需要分配3MB的连续内存:
- 在物理内存中可能找不到3MB的连续空间
- 通过分页机制,可以将这3MB划分为:
- 768个4KB的页(768×4KB=3MB)
- 这些页可以分散存储在物理内存的不同位置
- 但对程序来说,这些页在虚拟地址空间中是连续的
这种机制极大地提高了内存管理的灵活性和效率,是现代操作系统的基础功能之一。
2.2 物理内存管理
设一个可用的物理内存有4GB的空间。按照一个页框的大小4KB进行划分,4GB的空间可以划分为4GB/4KB=1048576个页框(即1M个物理页)。管理如此大量的物理页是操作系统的核心任务之一,操作系统需要精确掌握每个页框的状态信息,包括:
- 哪些页框正在被进程使用
- 哪些页框处于空闲状态
- 每个页框的引用计数
- 页框的脏页状态
- 页框的缓存属性等
操作系统采用"先描述再组织"的方式管理物理内存。内核使用struct page结构体来表示系统中的每个物理页,这个结构体定义在include/linux/mm_types.h头文件中。由于需要管理大量页框,为节省内存空间,struct page中大量使用了联合体(union)来共享内存空间。
cpp
/* include/linux/mm_types.h */
struct page {
    /* 原⼦标志,有些情况下会异步更新 */
    unsigned long flags;
    union {
        struct {
            /* 换出⻚列表,例如由zone->lru_lock保护的active_list */
            struct list_head lru;
            /* 如果最低为为0,则指向inode
            * address_space,或为NULL
            * 如果⻚映射为匿名内存,最低为置位
            * ⽽且该指针指向anon_vma对象
            */
            struct address_space* mapping;
            /* 在映射内的偏移量 */
            pgoff_t index;
            /*
            * 由映射私有,不透明数据
            * 如果设置了PagePrivate,通常⽤于buffer_heads
            * 如果设置了PageSwapCache,则⽤于swp_entry_t
            * 如果设置了PG_buddy,则⽤于表⽰伙伴系统中的阶
            */
            unsigned long private;
        };
        struct { /* slab, slob and slub */
            union {
                struct list_head slab_list; /* uses lru */
                struct { /* Partial pages */
                    struct page* next;
#ifdef CONFIG_64BIT
                    int pages; /* Nr of pages left */
                    int pobjects; /* Approximate count */
#else
                    short int pages;
                    short int pobjects;
#endif
                };
            };
            struct kmem_cache* slab_cache; /* not slob */
            /* Double-word boundary */
            void* freelist; /* first free object */
            union {
                void* s_mem; /* slab: first object */
                unsigned long counters; /* SLUB */
                struct { /* SLUB */
                    unsigned inuse : 16; /* ⽤于SLUB分配器:对象的数⽬ */
                    unsigned objects : 15;
                    unsigned frozen : 1;
                };
            };
        };
        ...
    };
    union {
        /* 内存管理⼦系统中映射的⻚表项计数,⽤于表⽰⻚是否已经映射,还⽤于限制逆向映射搜索*/
        atomic_t _mapcount;
        unsigned int page_type;
        unsigned int active; /* SLAB */
        int units; /* SLOB */
    };
    ...
#if defined(WANT_PAGE_VIRTUAL)
        /* 内核虚拟地址(如果没有映射则为NULL,即⾼端内存) */
        void* virtual;
#endif /* WANT_PAGE_VIRTUAL */
    ...
}
struct page结构体包含以下重要成员:
- flags成员:
- 这是一个unsigned long类型的位图,用于记录页面的各种状态
- 每个bit位代表一种特定状态,可以同时表示32种不同状态
- 重要状态标志包括:
- PG_locked:表示页面是否被锁定
- PG_referenced:表示页面最近是否被访问
- PG_dirty:表示页面是否被修改
- PG_uptodate:表示页面数据是否有效
- PG_active:表示页面是否在活跃链表中
- 这些标志定义在<linux/page-flags.h>头文件中
- _mapcount成员:
- 这是一个原子计数器,记录页表中有多少项指向该页
- 当计数值为-1时,表示当前内核没有引用该页
- 用于页面回收和共享内存的实现
- virtual成员:
- 这是页面的虚拟地址
- 对于高端内存(highmem),这个值可能为NULL,需要时动态映射
- 主要用于快速访问页面的内核虚拟地址
- 其他重要联合体:
- lru:用于页面回收的LRU链表
- mapping:指向address_space或anon_vma
- private:页面私有数据指针
- slab相关成员:用于slab分配器管理
内存消耗计算:
- 假设struct page大小为40字节
- 4GB内存共有1M个页框
- 总内存消耗:40B * 1M = 40MB
- 仅占4GB内存的1%,管理开销合理
页大小的权衡:
-
页太小 :会导致页表过长(页表项增多),增大页表内存开销 ,并且TLB缓存能覆盖的虚拟内存范围变小,导致TLB未命中率升高,降低性能。
-
页太大 :会导致内部碎片严重。例如,一个进程只使用1字节的数据,却要独占一个4KB的页,浪费了几乎整个页。
-
折中选择 :4KB 是经过长期实践验证的在内存利用率 和管理开销/性能 之间的一个最佳平衡点。当然,现代处理器和操作系统也支持大页,如2MB或1GB,用于数据库、虚拟化等需要映射大量内存并追求极致TLB性能的特殊场景。
特殊说明:
- 高端内存管理:当物理内存超过内核虚拟地址空间直接映射范围时,需要特殊处理
- NUMA架构:在多处理器系统中,需要考虑内存的局部性
- 页面回收:当内存不足时,需要选择合适页面进行回收或交换
实现细节:
- 每个内存区域(zone)维护自己的页框管理结构
- 使用伙伴系统(buddy system)管理空闲页框
- 通过位图或链表快速查找空闲页框
- 页面缓存机制提高文件I/O性能
那操作系统又是怎么将这些物理页(页框)组织起来的呢?通过一个全局数组
-
全局数组管理 :所有
struct page存储在mem_map数组中,数组下标即物理页号(PFN),通过PFN = (物理地址 >> 12)可直接定位对应结构体 。cpp// 物理地址到 struct page 的转换 struct page *pfn_to_page(unsigned long pfn) { return &mem_map[pfn]; }
mem_map 数组:物理内存的"花名册"
想象一下,一个公司有上万名员工。人力资源部门最好的管理方式就是拥有一份按工号顺序排列的员工花名册。通过工号,HR可以立即找到任何一位员工的全部档案。
mem_map 数组就是Linux内核为所有物理页框建立的"花名册"。
1. 核心组织方式:线性数组
-
物理内存是连续的 :从硬件视角看,物理内存的地址是从
0开始一直到最大内存值的连续空间。虽然由于地址映射的原因,操作系统看到的物理地址可能不是从0开始(有一个偏移),但它仍然是一段连续的地址范围。 -
页框是等分的 :这片连续的地址空间被等分为无数个大小为
PAGE_SIZE(如4KB)的页框。 -
页框号 :每个页框都有一个唯一的编号,称为页框号 。PFN是页框的"工号"。它的计算公式非常简单:
PFN = (Physical_Address) / PAGE_SIZE例如,物理地址
0x0000c000(十进制49,152)的PFN是49152 / 4096 = 12。 -
mem_map数组 :内核在启动初期,会根据检测到的物理内存总大小,动态地分配一个足够大的struct page数组。这个数组就是mem_map。 -
一一对应 :最关键的一点是:数组的下标(索引)直接对应着页框号(PFN) 。
struct page *page = &mem_map[PFN];
这意味着什么?
这意味着,给定任何一个物理地址,内核都可以通过以下三步瞬间找到描述它的 struct page:
-
通过物理地址计算出PFN:
pfn = physical_addr >> PAGE_SHIFT(PAGE_SHIFT是12,因为 2^12 = 4096,右移12位等价于除以4096)。 -
将PFN作为索引,直接访问
mem_map数组:page = mem_map[pfn]。 -
现在,
page指针就指向了描述这个物理页框的所有元数据(状态、引用计数等)。
这种设计实现了 O(1) 时间复杂度 的查找,效率极高,是内核高效内存管理的基石。
2. 处理复杂性:并非所有内存都"生而平等"
上面的描述是一种理想化的线性模型。现实中的硬件和系统配置要复杂一些,mem_map 的组织也随之有了一些变化。
a. 内存节点(Node):NUMA架构
在多处理器系统中,有一种叫做NUMA的架构。每个CPU有自己本地连接的内存,访问本地内存非常快,访问其他CPU连接的内存(远端内存)则较慢。
-
组织方式 :内核为每个内存节点 (node)都维护一个独立的
mem_map数组。 -
如何查询 :内核代码会先确定物理地址属于哪个节点(通过
nid = pfn_to_nid(pfn)),然后再使用该节点对应的mem_map数组:page = NODE_MEM_MAP(nid)[pfn]。
b. 内存区域(Zone)
在一个内存节点内,物理内存又被划分为不同的区域。最常见的三个区域是:
-
ZONE_DMA:用于直接的DMA操作,因为某些老式设备只能对低16MB内存寻址。
-
ZONE_NORMAL:常规地址空间,通常被直接映射到内核虚拟地址的高端部分。内核的大部分分配都发生在这里。
-
ZONE_HIGHMEM:高端内存,32位系统中超过896MB的部分,内核不能直接映射,需要动态映射。
-
组织方式 :
mem_map数组仍然是一个覆盖整个节点的大数组。但是,每个struct page里有一个flags位,会标识它属于哪个区域。同时,内核记录了每个区域的起始和结束PFN。
c. 稀疏内存(Sparsemem)和内存空洞
在大型服务器或虚拟化环境中,物理内存可能存在巨大的"空洞"。例如,系统可能有1TB的内存,但物理地址 0x1000-0000 到 0x2000-0000 这个范围可能没有安装内存芯片。为这1TB的地址空间分配一个完整的、连续的 mem_map 数组(会非常大且大部分为空)是极其浪费的。
-
组织方式 :内核提供了
CONFIG_SPARSEMEM选项。它不再使用一个大的线性mem_map数组,而是将物理内存地址空间划分为若干个mem_section。每个mem_section管理一小段PFN范围。只有当某个mem_section对应的物理内存确实存在时,才会为其分配真正的struct page数组。 -
如何查询 :计算PFN后,先找到这个PFN属于哪个
mem_section,然后在这个mem_section的页数组中进行索引。这增加了一次间接寻址,但节省了大量的内存。
总结与图示
即使有这些复杂情况,核心思想不变:PFN是访问物理页元数据的唯一钥匙。
简化后的访问流程:
Physical Address -> PFN -> (NODE_ID) -> MEM_MAP`PFN` -> struct page
一个简单的比喻:
-
物理地址 :像是地球上某个地点的经纬度坐标。
-
PFN :像是将这个经纬度转换成了一个全球分区编号(例如,A区第12号地块)。
-
mem_map:像是全球地契管理系统。 -
struct page:像是某个地块的详细地契 ,记录了所有者、用途、状态等信息。只要你告诉我经纬度(物理地址),我就能通过计算得到分区和地块号(PFN),然后直接去管理系统的对应位置(
mem_map[PFN])找到它的地契(struct page)。
这种通过PFN直接索引 mem_map 数组的组织方式,是Linux内核能够高效、精准地管理数百万个物理页框的根本原因。它将一个复杂的管理问题,转化为了一个简单的数组查找问题。
2.3 页表
页表中的每一个表项,指向一个物理页的开始地址。在 32 位系统中,虚拟内存的最大空间是 4GB , 这是每一个用户程序都拥有自己的虚拟内存空间。既然需要让 4GB 的虚拟内存全部可用,那么页表中就需要能够表示这所有的 4GB 空间,那么就一共需要 4GB/4KB = 1048576 个表项。如下图所示:
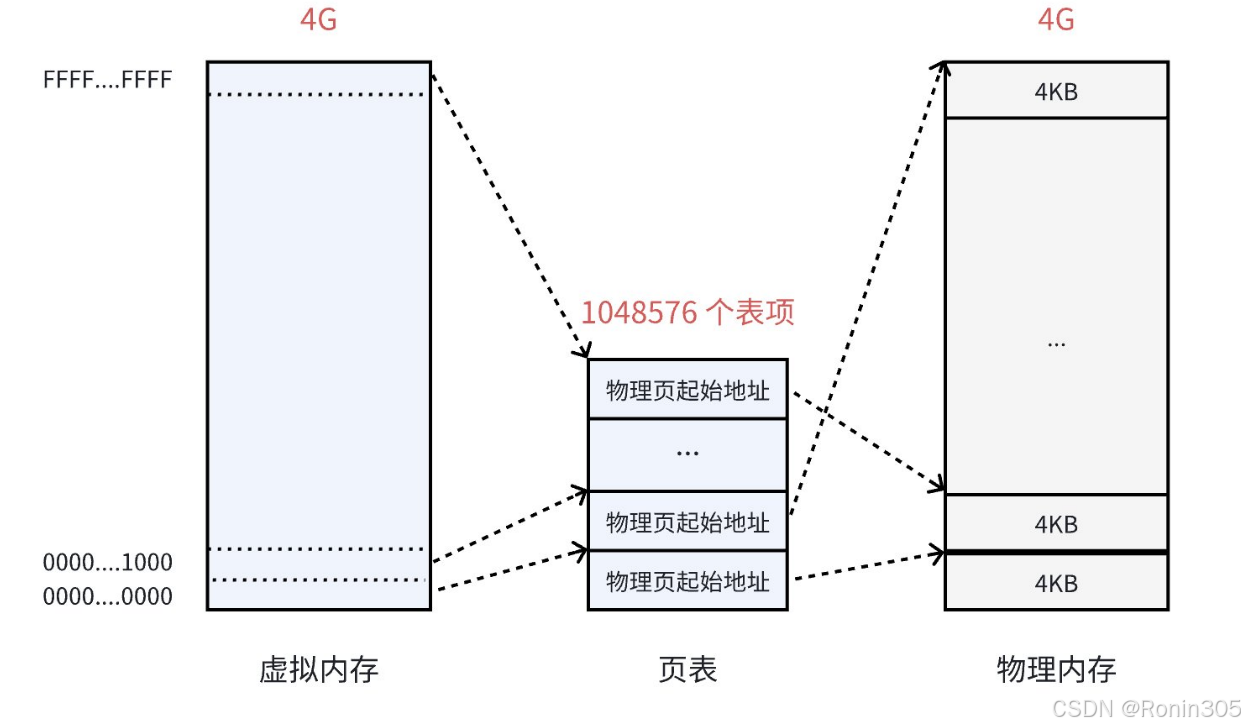
虚拟内存看上去被虚线"分割"成一个个单元,其实并不是真的分割,虚拟内存仍然是连续的。这个 虚线的单元仅仅表示它与页表中每一个表项的映射关系,并最终映射到相同大小的一个物理内存页上。
页表中的物理地址,与物理内存之间,是随机的映射关系,哪里可用就指向哪里(物理页)。虽然最终使用的物理内存是离散的,但是与虚拟内存对应的线性地址是连续的。处理器在访问数据、获取指令时,使用的都是线性地址,只要它是连续的就可以了,最终都能够通过页表找到实际的物理地址。
为了解决物理内存的碎片问题,我们引入了页表这个"映射表",但这个映射表自身却可能面临需要大量连续内存的问题。
1. 单级页表的问题回顾
-
32位系统,4GB虚拟地址空间,4KB页大小 → 需要 2^20 (1M) 个页表项。
-
每个页表项(PTE)占4字节 → 整个页表需占用 4MB 的连续物理内存。
-
这4MB需要 1024个连续的物理页框。
这带来了两个致命问题:
-
连续内存分配问题 :为每个进程分配4MB的连续物理内存来存放页表,这本身就可能引发外部碎片,与我们使用分页的初衷相悖。
-
内存效率问题 :根据局部性原理,一个进程在绝大多数时间只会访问其地址空间中的一小部分(代码段、堆栈的一小部分)。为整个4GB地址空间维护完整的页表是极大的浪费。99%的页表项在进程生命周期内可能从未被使用过。
解决需要大容量页表的最好方法是:把页表看成普通的文件,对它进行离散分配,即对页表再分页,由此形成多级页表的思想。
2. 解决方案:多级页表
多级页表是解决上述问题的经典方案,它采用了计算机科学中"分而治之 "和"按需分配"的思想。
a. 核心思想:对页表本身进行分页
将单一的大页表拆分成多个小页表(第二级页表,或更下级页表),然后再用一个顶级页表(第一级页表)来管理这些二级页表。
b. 工作流程(以经典的二级页表为例)
虚拟地址被划分为多个部分(以32位系统为例):
-
页目录索引 (10 bits) :用于在页目录表 (Page Directory,第一级页表)中定位一个页目录项(PDE)。
-
页表索引 (10 bits) :PDE中包含了二级页表的物理基地址。用这个索引在找到的二级页表 (Page Table)中定位一个页表项(PTE)。
-
页内偏移 (12 bits):PTE中包含了物理页框的基地址。用这个偏移量在物理页框内定位最终的字节。
-
页目录(PGD) :包含 1,024 个表项,每个指向一个 页表(PTE) 的物理地址。
-
页表(PTE) :包含 1,024 个表项,每个指向一个物理页框 。
-
每个表包含1,024个表项
这样一来,1024(每个表中的表项个数) * 1024(表的个数),仍然可以覆盖 4GB 的物理内存空间。 这里的每一个表,就是真正的页表,所以一共有 1024 个页表。⼀个页表自身占用 4KB ,那么1024 个页表⼀共就占用了 4MB 的物理内存空间,和之前没差别啊?
从总数上看是这样,但是一个应用程序是不可能完全使用全部的 4GB 空间的,也许只要几十个页表就可以了。例如:一个用户程序的代码段、数据段、栈段,一共就需要 10 MB 的空间,那么使用 3 个页表就足够了。
- 页目录(PGD) :固定占用 1 个物理页(4KB)。
- 页表(PTE) :仅在实际使用的虚拟区域分配。
- 10MB 程序示例 :
- 需覆盖的虚拟空间:10MB → 向上对齐为 12MB(3 个连续的 4MB 块)。
- 每个页表覆盖 4MB → 仅需 3 个页表(12KB)。
- 总页表占用 :PGD(4KB) + 3×PTE(12KB) = 16KB 。
- 对比单级页表 :从 4MB → 16KB,降低 256 倍!
- 10MB 程序示例 :
物理内存离散化
- 多级页表自身可分散存储:
- 页目录连续(但仅需 1 页)。
- 各页表可位于非连续物理页框,彻底避免大块连续需求 。
2.4 页目录结构
到目前为止,每一个4KB大小的页框都被一个页表中的一个表项(PTE,Page Table Entry)来指向了。在32位系统下,假设采用标准的4KB分页机制,那么每个页表包含1024个表项(每个表项占4字节),可以管理4MB(1024×4KB)的地址空间。这1024个页表也需要被集中管理起来。
管理页表的表称之为页目录表(Page Directory),这样就形成了二级页表结构。如下图所示:
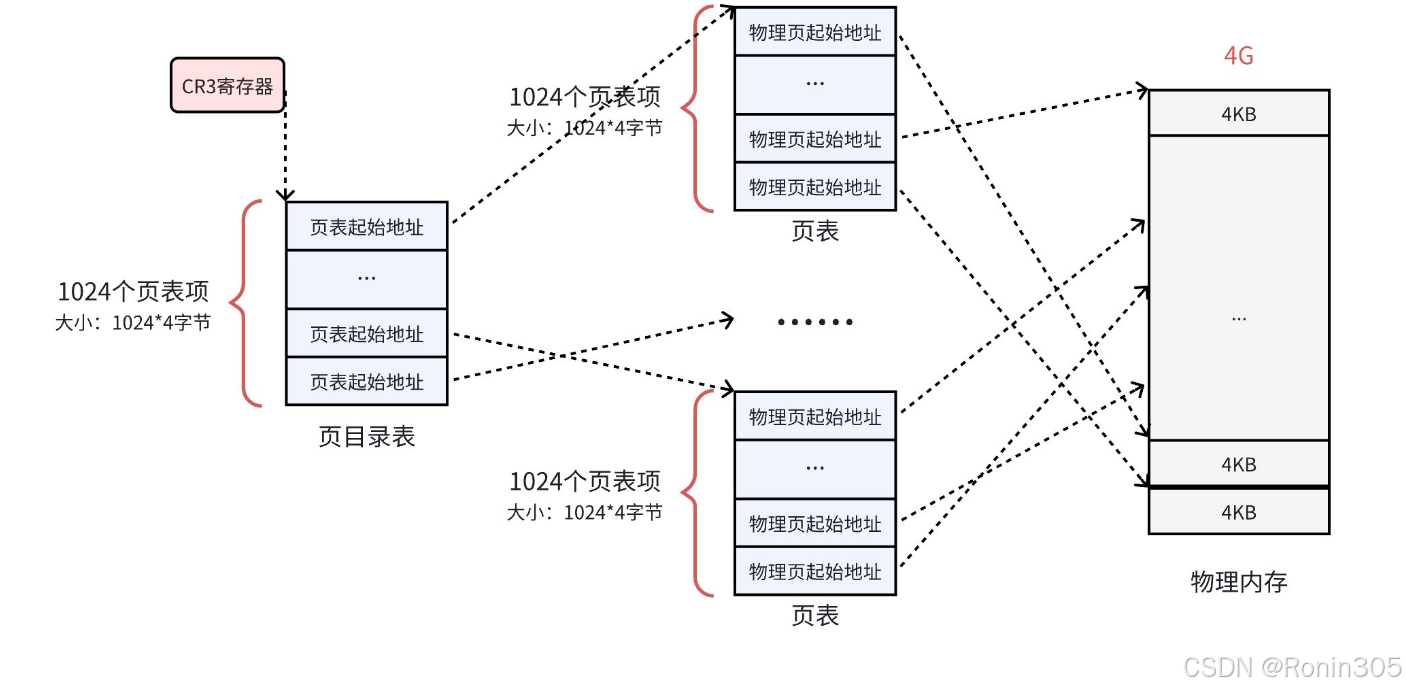
整个管理机制如下所示:
-
内存管理结构层次:
- 顶级:页目录表(Page Directory)
- 中间层:1024个页表(Page Tables)
- 底层:实际物理页框(Page Frames)
-
关键指针关系:
- 所有页表的物理地址都被页目录表项(PDE,Page Directory Entry)指向
- 页目录表的物理地址被CR3寄存器(Control Register 3)指向,这个寄存器中保存了当前正在执行任务的页目录表的物理地址
- 当CPU进行地址转换时,会首先从CR3寄存器获取页目录表地址
-
内存分配要求:
- 操作系统在加载用户程序时,需要为程序内容分配物理内存页框
- 同时还需要为管理这些页框的页表分配物理内存(每个页表占4KB)
- 还需要为页目录表本身分配物理内存(占4KB)
- 对于一个新进程,至少需要分配:1个页目录表 + 1个页表 + 程序所需的物理页框
注意:
CR3寄存器 - 起点 :CPU中有一个非常重要的控制寄存器------CR3 (也称为页目录基址寄存器,PDBR)。它存储了当前正在运行的进程的页目录表的物理内存地址。这是整个翻译过程的绝对起点。每当操作系统切换到另一个进程时,它必须将新进程的页目录物理地址加载到CR3寄存器中,这就是进程间内存隔离的关键。
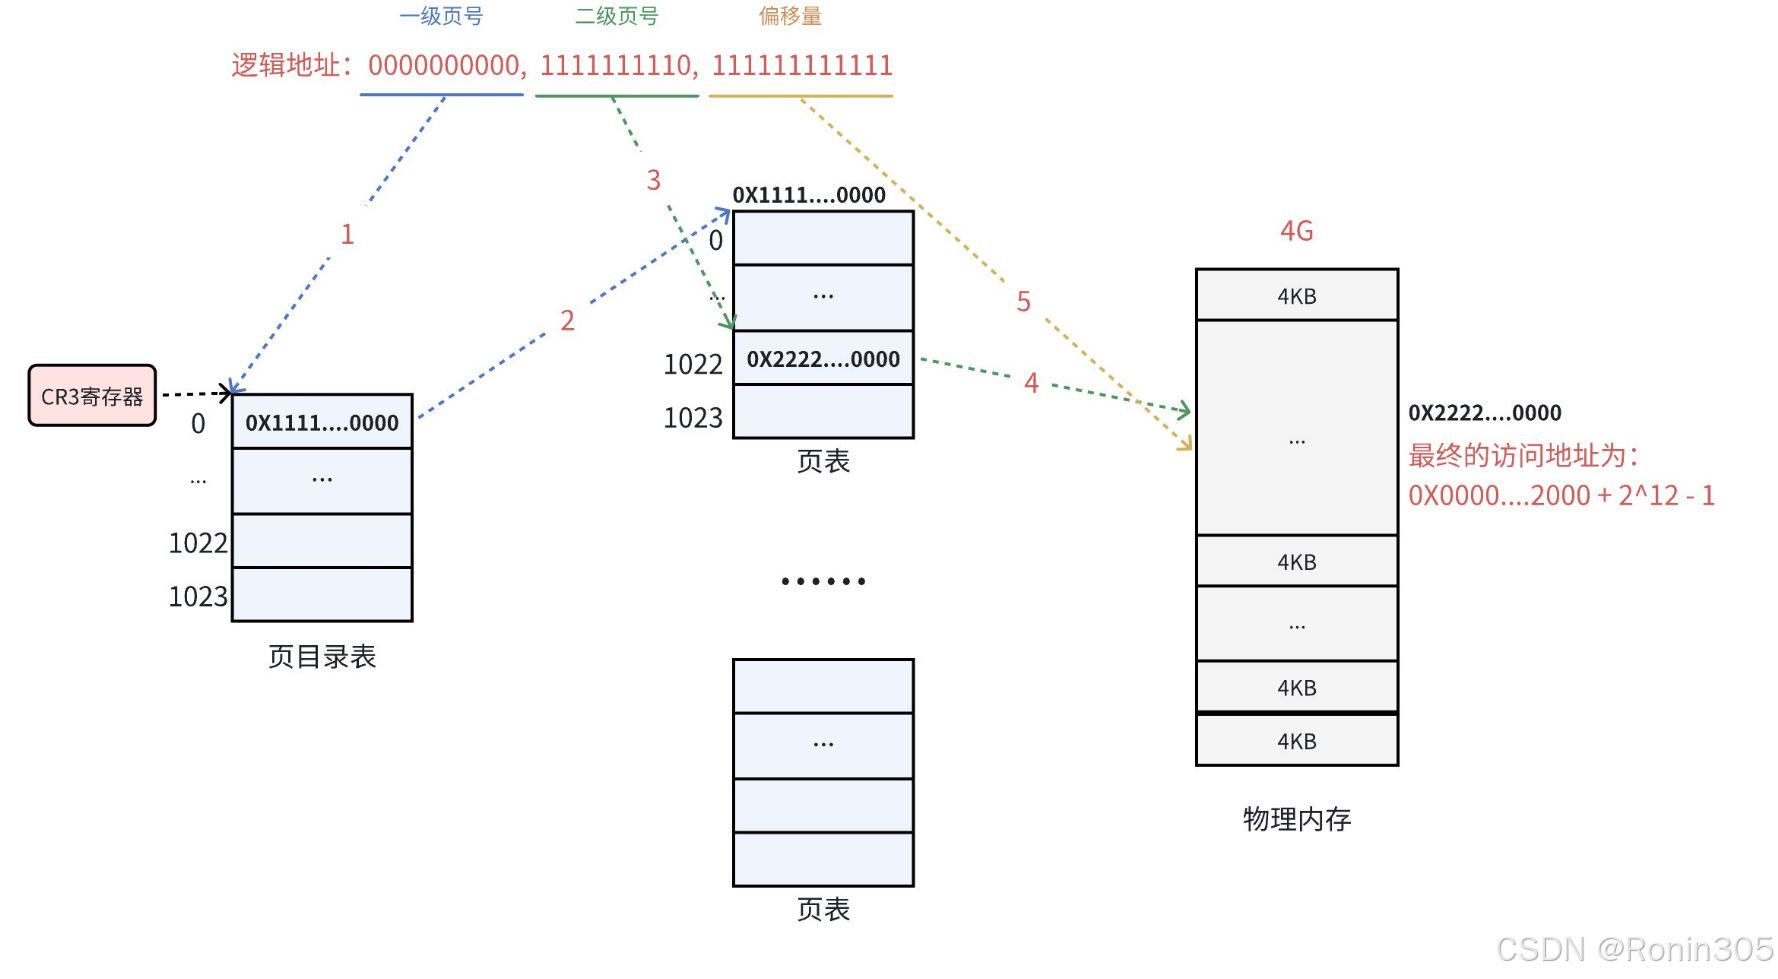
2.5 两级页表的地址转换
深入理解地址转换流程
下面以一个逻辑地址为例。将逻辑地址( 0000000000,0000000001,11111111111 )转换为物理地址的过程:
-
拆分虚拟地址:
-
32位地址,4KB页大小。这意味着:
-
页内偏移(Offset) :低 12位。因为 2^12 = 4096 = 4KB,这12位足以寻址一个页内的任何一个字节。
-
页表索引(PTI) :中间 10位。用于在二级页表中定位页表项(PTE)。
-
页目录索引(PDI) :高 10位。用于在页目录表中定位页目录项(PDE)。
-
-
0000000000(PDI),0000000001(PTI),111111111111(Offset) 完美诠释了这种划分。
-
-
查询页目录表(第一级查询):
-
MMU从CR3寄存器 中获取当前进程的页目录表的物理内存起始地址。
-
将PDI (0) 乘以每个PDE的大小(4字节),得到偏移量:
0 * 4 = 0。 -
访问物理地址
CR3 + 0,读取其中的页目录项(PDE) 。这个PDE包含了该虚拟地址范围对应的二级页表的物理基地址。
-
-
查询页表(第二级查询):
-
MMU拿到二级页表的物理基地址。
-
将PTI (1) 乘以每个PTE的大小(4字节),得到偏移量:
1 * 4 = 4。 -
访问物理地址
(二级页表基地址) + 4,读取其中的页表项(PTE) 。这个PTE包含了最终物理页框的基地址(高20位)。
-
-
合成物理地址:
-
PTE中的物理页框基地址(高20位)与虚拟地址中的页内偏移(低12位)组合,得到完整的32位物理地址。
-
关键点:物理页框是4KB对齐的,其地址的低12位必然是0。因此,PTE只需要存储高20位,低12位可以空出来用于存储标志位(如存在位、读写权限位、脏位等)。
-
多级页表的性能代价与TLB的引入
我们可以敏锐地发现多级页表的阿喀琉斯之踵:性能损失。
-
N+1次内存访问 :每一次内存转换都需要进行N次(页表级数)内存访问来查询页表,再加上1次最终的数据访问。在二级页表下,这需要 3次内存访问(取PDE -> 取PTE -> 取数据)才能拿到一个字节的数据!这会导致性能急剧下降。
-
"双刃剑" :多级页表用时间 换取了空间效率和灵活性。
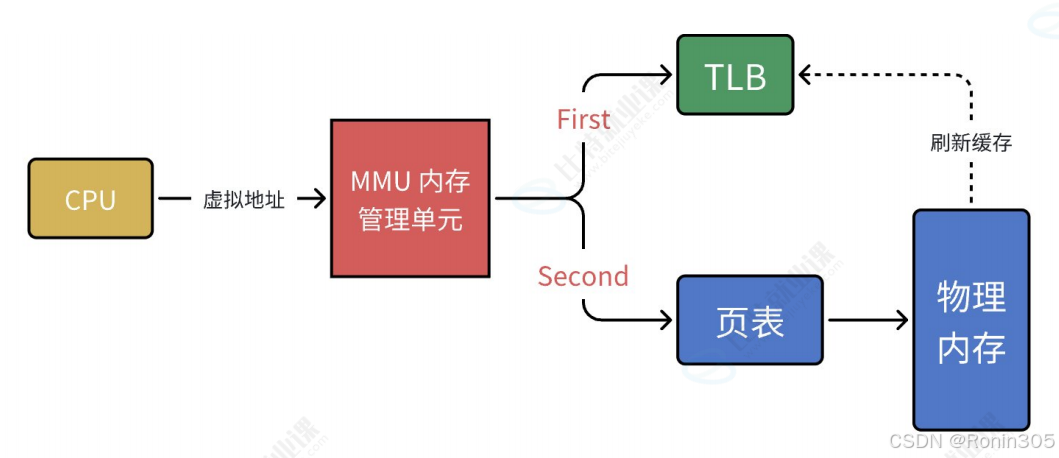
为了解决这个性能瓶颈,计算机架构师们祭出了经典的"法宝":缓存 。这就是转译后备缓冲器(TLB)。
TLB:地址转换的加速器
TLB是集成在MMU内部的一个小型、专用的高速缓存(SRAM),其内容是虚拟页号 到物理页框号的映射关系。
工作流程------犹如图书馆的快捷索书号 :
想象一下,你去一个巨大的图书馆(物理内存)查书。完整的流程是:先查总目录(页目录)找到区域号,再查区域目录(页表)找到书架号,最后根据书架号和偏移找到书。这非常慢。
TLB就像是你自己随身携带的一个小本子 ,记录了你最近经常借阅的书名(虚拟地址) 和对应的书架号(物理地址)。
-
TLB查询(Lookup) :当CPU给出一个虚拟地址后,MMU首先提取其虚拟页号(VPN,即高20位),并去TLB中查询。
-
TLB命中(Hit) :如果在TLB中找到了对应的映射(
VPN -> PFN),MMU立刻将PFN与偏移量组合成物理地址。整个过程仅需一个时钟周期,速度极快。这就是"快捷索书号",无需查阅任何目录。 -
TLB未命中(Miss) :如果TLB中没有记录,MMU则不得不走"慢路径"------进行完整的页表遍历(Walk),即上述的两级查询过程。
-
TLB更新 :在慢路径成功找到映射关系后,MMU在将物理地址发送给总线的同时,会将这条
VPN -> PFN的映射关系写回TLB中,替换掉一个旧条目(根据某种替换算法,如LRU)。这样,下次再访问同一个虚拟页时,就能命中了。
为什么TLB有效?------局部性原理
TLB之所以能发挥巨大作用,其理论基础依然是局部性原理:
-
时间局部性:一个内存位置被访问后,它很可能在不久的将来再次被访问(例如循环中的指令)。
-
空间局部性:一个内存位置被访问后,其附近的内存位置也很可能被访问(例如遍历数组)。
这意味着,进程在短时间内访问的页会集中在少数几个页上。因此,即使TLB的容量很小(通常只有几十到几百个条目),其命中率也能非常高(如98%以上),从而将平均地址转换时间降至极低。
总结:从问题到解决方案的完美闭环
-
原始问题 :直接使用物理内存导致外部碎片。
-
初级方案 :引入单级页表实现虚拟内存,解决碎片,但自身需要大块连续内存,效率低下。
-
进阶方案 :采用多级页表 ,通过"按需分配"页表项,极大节省内存,但引入了性能开销(多次内存访问)。
-
终极优化 :引入TLB缓存,利用局部性原理,将绝大多数地址转换的耗时从"N+1次内存访问"减少到"1次缓存访问",完美解决了多级页表的性能瓶颈。
这个演进过程淋漓尽致地体现了计算机系统设计中的核心权衡:在时间与空间、性能与资源之间寻找最佳平衡,并通过增加一个高效的"中间层"(Cache)来破解难题。
2.6 缺页异常
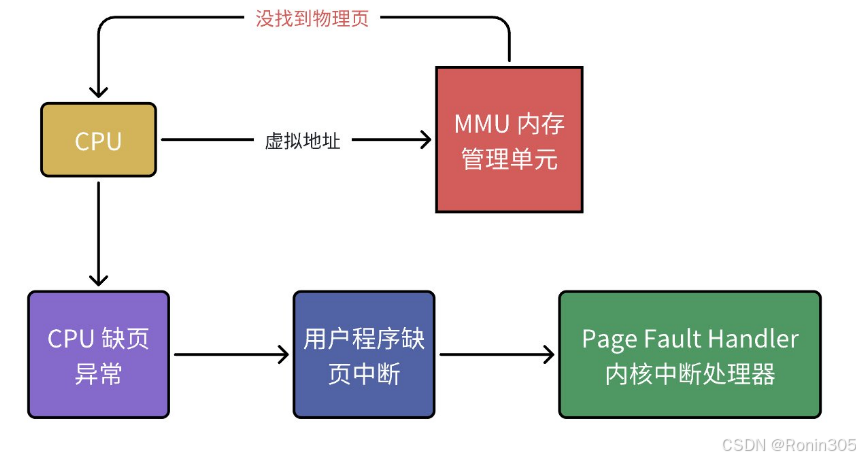
设想,CPU 给 MMU 的虚拟地址,在 TLB 和页表都没有找到对应的物理页,该怎么办呢?其实这就是缺页异常 Page Fault ,它是一个由硬件中断触发的可以由软件逻辑纠正的错误。
缺页异常的发生与处理流程
我们将其细化为一个完整的处理链条:
-
触发:CPU执行一条内存访问指令(读/写),MMU尝试翻译虚拟地址。
-
TLB与页表查询失败 :TLB未命中,继而查询页表。MMU发现对应的页表项(PTE) 中的存在位(Present Bit)为0 或权限位不匹配(例如尝试写一个只读页)。
-
硬件中断 :MMU立即触发一个缺页异常 (#PF)。这是一个陷阱(Trap),CPU会暂停当前用户进程的执行。
-
上下文切换 :CPU从用户态切换到内核态,保存当前进程的上下文(寄存器等),然后根据中断描述符表(IDT)跳转到操作系统预设的缺页异常处理程序 (
Page Fault Handler)。 -
软件处理:操作系统的Handler开始工作。这是最复杂也最精彩的部分。Handler会:
-
诊断原因:读取CR2寄存器(该寄存器存放了导致缺页的那个虚拟地址),并检查PTE中的标志位,来确定缺页的具体类型。
-
分配资源:根据不同类型,采取不同的纠正措施(详见下文)。
-
修复页表:措施执行完后,Handler会修改PTE,将其"存在位"置1,并填入正确的物理页框号,更新权限等。
-
重试指令 :Handler返回后,CPU恢复之前保存的上下文,并重新执行那条引发异常的内存访问指令。这一次,MMU就能成功翻译地址并完成访问了。
-
深入三种缺页类型
a. 次要缺页(Minor Page Fault / Soft Fault)
-
成因:物理页框其实已经在内存中,但当前进程的页表尚未建立映射。
-
典型场景:
-
写时复制(Copy-on-Write, COW) :这是最经典的例子。当
fork()创建子进程时,内核并不会立即复制父进程的整个地址空间,而是将父子进程的页表项都设置为只读 ,并标记为COW。当任何一方尝试写入时,便会触发缺页。Handler检测到COW标志后,才会真正分配一个新的物理页框,复制数据,并为写入进程建立新的可写映射。这避免了不必要的拷贝,极大提升了fork()的效率。 -
内存共享 :多个进程通过
shmget()等系统调用共享同一段内存。当第一个进程将其调入内存后,后续进程访问时只需在自己的页表中建立映射即可,触发的是Soft Fault。
-
-
处理 :无需磁盘I/O。Handler只需找到那个已存在的物理页框,然后更新当前进程的页表项,建立映射关系即可。速度非常快。
b. 主要缺页(Major Page Fault / Hard Fault)
-
成因 :所需的页确实不在物理内存中 ,而是驻留在交换空间(Swap) 或磁盘上的文件中。
-
典型场景:
-
交换 :物理内存已满,之前某个不活跃的页被"换出"到了硬盘上的交换分区(如Linux的
swapfile或swap partition)。 -
加载程序代码/数据 :执行一个程序(如
/bin/ls)或mmap()映射一个文件。第一次访问其代码或数据段时,这些内容还在磁盘上。
-
-
处理 :这是一个开销巨大的操作。Handler需要:
-
找到一个空闲的物理页框(可能要先换出另一个页)。
-
发起磁盘I/O请求,将所需的数据从磁盘读入这个页框。
-
更新页表项,建立映射。
-
由于磁盘I/O速度极慢,发生Hard Fault的进程会被阻塞(睡眠),直到数据读取完成。
-
c. 无效缺页(Invalid Page Fault)
-
成因 :进程访问了一个非法的地址 。这不是一个可以纠正的错误,而是一个真正的程序bug。
-
典型场景:
-
访问NULL指针 :如
int *p = NULL; *p = 10;。地址0通常被设置为不可访问。 -
野指针:指针指向了一个已被释放的内存区域。
-
栈溢出 或堆溢出:访问了未分配的栈或堆空间。
-
访问只读内存进行写操作:如尝试修改代码段。
-
-
处理 :Handler无法修复这个错误。它会向肇事进程发送一个信号(Signal) ,在Linux/Unix上通常是
SIGSEGV(Segmentation Fault,段错误)。如果进程没有自己捕获并处理这个信号,操作系统默认会终止该进程,并可能生成一个核心转储(core dump)文件用于调试。
关键问题解析
• 如何理解 new 和 malloc?
new(C++)和 malloc(C)在大多数现代操作系统中,并没有立即分配物理内存 。它们只是在进程的虚拟地址空间 中"预订"了一段地址范围(在堆上),并更新了内核中关于进程内存区域的数据结构(如VMA链表)。真正的物理内存分配,要延迟到第一次访问这块内存、触发缺页异常 时才会发生。这是一种名为"延迟分配(Lazy Allocation)"的优化策略,避免了分配但永不使用的内存浪费。
• 如何理解写时拷贝(Copy-on-Write)?
如上文所述,COW是Soft Page Fault的完美应用。它通过"拖延"拷贝操作,极大地提升了进程创建(fork())的效率,并减少了内存消耗。只有在绝对必要时(写入时)才进行实际的拷贝。
• 申请内存,究竟是在干什么?
-
用户层 :
malloc/new管理的是一个进程内部的堆内存池 。它们从操作系统中申请大块内存(通过brk或mmap系统调用),然后自己切成小块分配给应用程序。这个过程主要是在管理虚拟地址空间。 -
内核层 :当
brk/mmap扩展了进程的地址空间后,内核只是记录了该进程拥有了一段新的、合法的地址范围(VMA)。真正的物理内存页框,要等到缺页异常发生时才会分配。
• 如何区分缺页与越界?内核如何检查页号合法性?
内核在缺页异常处理程序中,第一步就是进行合法性检查 。它通过查询进程的虚拟内存区域(VMA)链表来实现:
-
VMA:内核为每个进程维护一个数据结构链表,每个节点描述了一段连续的虚拟地址空间(如代码段、数据段、堆、栈、共享库等)及其属性(读、写、执行、是否共享等)。
-
检查过程 :当缺页发生在地址
addr时,Handler遍历该进程的VMA链表,检查addr是否落在某个VMA所描述的合法区间内。-
如果落在某个VMA内 :这是一个合法的访问,缺页是因为物理页尚未分配(Hard Fault)或映射未建立(Soft Fault)。Handler会继续分配页面或建立映射。
-
如果不在任何VMA内 :这是一个非法的访问 (越界),即Invalid Page Fault。Handler会直接给进程发送
SIGSEGV信号终止它。
-
• 越界了一定会报错吗?
不一定。 这取决于越界的那块地址是否碰巧落在另一个合法的VMA区间内。
-
如果越界访问跳到了一个未分配的、空洞的地址 ,会立刻触发
SIGSEGV。 -
如果越界访问跳到了另一个已分配的区域 (例如,堆溢出覆盖了堆后的另一个数据结构),那么这次写入在硬件层面是"合法"的,不会立即报错。但这会导致 silent data corruption (静默数据破坏),是更难调试的严重bug。工具如Valgrind就是通过模拟页表并记录所有合法分配来检测这类错误。
线程资源划分的真相:虚拟地址空间即资源容器
资源的划分,其根源是地址空间的划分。操作系统并不直接管理"变量a归线程1,变量b归线程2",而是通过管理虚拟地址空间这个巨大的"资源地图",间接地、自然而然地完成了所有资源的划分与隔离。
1. 进程:资源的"自治共和国"
首先,我们要明确进程的角色。一个进程就是一个独立的"自治共和国",它拥有:
-
一部宪法 :定义了其领土范围和行为准则。这就是它的虚拟地址空间。在32位系统中,这部宪法规定其领土范围是0到4GB-1。
-
一片完整的领土:这片领土被规划成了不同的"功能区":
-
代码区(Text):存放法律条文(执行的指令)。
-
数据区(Data/BSS):存放国家物资(已初始化/未初始化的全局变量)。
-
堆区(Heap) :可动态扩张的耕地(
malloc/new分配的内存)。 -
栈区(Stack):每个公民的私人工作台(局部变量、函数调用信息)。
-
共享库:与其他共和国共用的公共设施。
-
-
对外权利:拥有独立的"外交权"(文件描述符、信号处理方式等)。
操作系统是"联合国",它承认每个共和国的宪法,并保障其领土主权不受侵犯。进程A的地址空间与进程B的地址空间完全隔离,这是通过各自的页表实现的。进程A的虚拟地址0x400000通过它的页表映射到物理页框X,而进程B的同一个虚拟地址0x400000通过它自己的页表映射到物理页框Y。它们互不干扰。
2. 线程:共和国内的"公民"
现在,我们在这个共和国内引入线程。线程就是这个共和国内的"公民"。
-
共享国家资源 :所有公民共享共和国的全部领土和资源。即,所有线程共享进程的:
-
整个虚拟地址空间(代码、数据、堆)。
-
文件描述符、信号处理等"外交权利"。
-
-
拥有私人空间 :但每个公民必须有自己的私人工作台 来开展工作,否则就会互相干扰。这个私人工作台就是线程独有的栈。
这就是"线程资源划分的真相":
操作系统不需要为线程单独划分代码区、数据区或堆。当它创建线程时,它只需要做一件事:在进程的虚拟地址空间内,为这个新线程分配一块新的内存区域作为其私有栈。
-
划分方式:操作系统在进程的地址空间布局中,找一块空闲区域,划出来给线程T1做栈;再找另一块空闲区域,划出来给线程T2做栈。
-
天然划分 :一旦栈空间在虚拟地址上被划分开,那么这些栈上所有的资源(局部变量、函数调用链)就自然而然地被划分开了。线程T1永远无法直接访问线程T2的栈指针所指向的内存区域,因为它们的虚拟地址本就不同。线程T1操作的是
0x7ffd...a000到0x7ffd...b000这段地址,而T2操作的是0x7ffe...c000到0x7ffe...d000。对虚拟地址的划分,导致建立在地址之上的所有资源访问权限被天然划分。
3. 内核视角:如何保障"公民"不越界?
虽然线程共享地址空间,但内核依然提供基础保护,防止一个线程恶意破坏另一个线程的私有栈。这是通过页级保护实现的。
-
每个虚拟内存页都有读、写、执行的权限位。
-
线程的栈空间对应的页表项,其权限被设置为可读、可写。
-
其他线程的栈空间,虽然虚拟地址存在,但当前线程的页表项中没有映射关系 ,或者权限不足。如果一个线程试图访问另一个线程的栈地址,MMU在翻译地址时会发现这是一个非法访问 (无法翻译或权限错误),从而触发一个缺页异常 或段错误(Segmentation Fault),由操作系统终止这次访问。
总结:
-
操作系统不直接管理逻辑资源(如这个变量、那个文件句柄)。
-
操作系统管理的是虚拟地址空间这片"土地"。它通过页表这块"地契",精确控制每一寸"土地"(虚拟地址)的归属(进程)、用途(权限)和实际位置(物理映射)。
-
所有应用程序层面的资源 (全局变量、堆对象、局部变量、代码指令),在操作系统看来,无非是存储在某块虚拟地址上的数据。
-
因此,只要划分好了虚拟地址空间,所有存储在这些地址上的资源也就被划分好了。
对于进程,操作系统划分了两个完全独立的、平行的4GB地址空间 。
对于线程,操作系统在同一个4GB地址空间内 ,划分了不同的栈区。
这就是进程间资源隔离和线程间资源共享的终极真相。它极大地简化了操作系统的设计:内核只需专注于管理虚拟地址空间和物理内存的映射这一件事,就能自然而然地实现所有内存资源的分配、隔离和保护。
3. 线程的优缺点
3.1 线程的优点
我们可以将其归纳为三大类:性能优势 、资源开销优势 和功能优势。
1. 创建与切换的性能优势
-
创建代价小 :创建线程(
pthread_create)远比创建进程(fork)快。- 根本原因 :如之前所述,创建进程需要为其分配独立的、庞大的虚拟地址空间,复制父进程的页表,管理大量的独享资源。而创建线程主要是在现有进程地址空间内分配一个新的栈和线程上下文结构(如
task_struct),绝大部分资源(代码、数据、堆、文件描述符)都是共享的,无需复制。
- 根本原因 :如之前所述,创建进程需要为其分配独立的、庞大的虚拟地址空间,复制父进程的页表,管理大量的独享资源。而创建线程主要是在现有进程地址空间内分配一个新的栈和线程上下文结构(如
-
切换代价小:线程上下文切换(Context Switch)比进程上下文切换效率高得多。这是线程最核心的优势之一。
-
根本原因:
-
最关键:无需切换地址空间 。进程切换需要切换页表 (即加载新进程的CR3寄存器),这会导致TLB(快表)被全部或大部分刷新 。后续的内存访问会因TLB未命中而变得缓慢,直到TLB重新被填热。线程切换发生在同一地址空间内,TLB保持不变,缓存效率极高。
-
缓存失效更少:CPU的高速缓存(Cache)数据是基于物理地址的。虽然线程切换也会导致缓存污染(因为新线程访问的数据不同),但由于虚拟地址空间不变,缓存失效的程度通常比进程切换要轻。
-
需要保存和恢复的上下文数据更少:线程的私有数据主要是栈指针、寄存器等,而进程还需要切换关于地址空间、文件描述符表等的信息。
-
-
2. 资源占用优势
-
占用的内核资源少:一个进程中的多个线程共享同一个进程控制块(PCB)和大部分资源。操作系统需要维护的内核对象数量更少,管理开销更小。
-
内存利用率高 :线程间通信通过共享的全局变量和堆内存即可实现,天然共享,无需像进程间通信(IPC)那样需要内核在中间拷贝数据(如管道、消息队列),或者建立复杂的共享内存映射。
3. 功能与并行优势
-
充分利用多核处理器 :这是现代多线程编程的首要目的。一个单线程进程在任何时候只能在一个CPU核心上运行。而一个多线程程序可以将计算任务分配到多个线程,由操作系统调度到多个CPU核心上真正并行(Parallelism) 执行,极大缩短计算时间。这对于计算密集型任务(如视频编码、科学计算)至关重要。
-
改善响应能力和吞吐量:对于I/O密集型任务(如网络服务器、GUI应用),这是线程的杀手级应用。
-
示例:一个单线程的Web服务器,如果在处理一个用户请求时进行读写磁盘的慢速I/O操作,整个进程都会被阻塞,无法响应其他用户请求。
-
多线程方案 :主线程负责接收连接,然后为每个连接创建一个工作线程。当一个工作线程因I/O操作(如读文件)被阻塞时,其他工作线程仍然可以继续在CPU上运行,处理其他用户的请求。这样就重叠了I/O等待时间和计算时间,极大地提高了服务器的并发吞吐量和响应能力。
-
3.2 线程的缺点
1. 性能损失(并非银弹)
-
场景:"计算密集型线程多于处理器数量"的情况非常典型。如果可运行的线程数远多于CPU核心数,操作系统调度器就不得不频繁地在这些线程之间进行切换。
-
开销:每次切换都有代价(虽然比进程小),包括直接开销(保存/恢复寄存器、调度算法本身)和间接开销(缓存、TLB局部性被破坏)。如果线程大部分时间都在计算,而不是在I/O阻塞,那么这种切换开销就会成为净损失,反而可能降低整体性能。线程并非越多越好。
2. 健壮性降低与缺乏保护
-
缺乏隔离 :这是进程与线程最根本的区别。进程间的错误是隔离的,一个进程崩溃(如段错误)通常不会影响其他进程。而所有线程共享相同的地址空间。
-
致命后果 :一个线程中的野指针写入、栈溢出、或调用了
exit()等操作,会直接导致整个进程崩溃,所有线程都会"陪葬"。 -
缺乏访问控制:操作系统进行访问控制(权限检查)的基本单位是进程。如果一个线程获得了操作某个资源的权限(如打开了一个文件),那么进程内的所有线程都自动拥有了这个权限。
-
3. 编程难度极高
-
同步问题(核心难题) :由于线程共享数据,竞态条件(Race Condition) 和数据竞争(Data Race) 成为噩梦。
-
示例 :两个线程同时执行
counter++。这条语句在机器指令层面可能是"读-改-写"三条指令。如果执行顺序交错,就可能发生更新丢失。 -
解决方案 :必须使用同步原语 (如互斥锁、信号量、条件变量)来保护所有共享资源。但这又引入了死锁 、活锁 、优先级反转 、性能瓶颈等更复杂的问题。
-
-
可调试性差 :多线程程序的bug往往是非确定性的,因为线程的执行顺序由操作系统调度器决定,每次运行的结果可能都不一样。这类bug难以复现和定位。
-
测试复杂度爆炸:需要测试各种可能的线程交错执行顺序,这在实际中几乎不可能完全覆盖。
4. Linux进程VS线程 -- 哪些资源共享,哪些独占
其实在前文中我们就有提到,下面我们再来对这些总结一下
4.1 进程和线程
在Linux内核中,线程被称为"轻量级进程"(LWP)。理解这一点是理解一切的关键:线程是共享了大量资源的进程。
核心关系:从内核视角看
-
进程是资源分配的基本单位 :操作系统把一大块资源(内存、文件、信号等)"打包"交给一个叫"进程"的实体。这个包就是虚拟地址空间 及其包含的一切。进程就是一个资源的容器。
-
线程是调度的基本单位 :CPU看不到"进程",它只看到一个个可以被调度执行的"线程"。每个线程有自己的程序计数器(PC)、寄存器状态和栈。线程是容器内实际的执行流。
一个单线程进程 就是一个只包含一个执行流的资源容器。
一个多线程进程就是一个包含了多个执行流的资源容器,这些执行流共享容器内的资源。
线程的私有数据(独占资源)
每个线程都必须有自己独立的状态,否则就无法实现独立的执行。这些私有数据保证了线程是"执行流"。
-
线程ID(TID):内核为每个线程分配的唯一标识符,不同于进程ID(PID)。
-
寄存器组 :这是线程上下文的核心。当线程被切换时,它的寄存器状态(如程序计数器PC、栈指针SP)必须被单独保存和恢复,这样它下次才能接着执行。
-
栈(Stack):这是最重要的私有资源。每个线程有自己独立的调用栈,用于存储函数参数、局部变量、返回地址等。这是实现线程独立执行的根本保障。如果共享栈,函数调用将完全混乱。
-
错误码(errno) :标准C库中的全局变量
errno,在多线程环境下会被实现为线程局部存储(TLS)。这样,一个线程的系统调用错误不会覆盖另一个线程的错误码。 -
信号屏蔽字(Signal Mask):每个线程可以独立设置阻塞哪些信号。例如,一个负责处理的线程可能阻塞所有信号,而一个监视线程则等待特定信号。
-
调度优先级:线程可以有自己的调度策略和优先级。
线程的共享数据(进程资源)
所有线程共享其所属进程的整个"资源包",这正是它们能轻松协作的基础。
-
地址空间:
-
代码段(Text Segment):所有线程执行相同的指令代码。
-
数据段(Data Segment):全局变量和静态变量。这是线程间通信最简单的方式(但也最危险,需要同步)。
-
堆(Heap) :通过
malloc/new动态分配的内存。一个线程分配的内存,另一个线程可以直接使用。
-
-
进程级系统资源:
-
文件描述符表:一个线程打开的文件(例如一个网络套接字),其他线程可以直接读写。这使得线程可以轻松地分工处理同一个网络连接。
-
信号处理方式 :信号的处理函数(
SIG_IGN,SIG_DFL或自定义函数)是进程级别的。例如,signal(SIGINT, handler)设置的 handler 对所有线程都生效。 -
当前工作目录 :
chdir()改变的是所有线程的工作目录。 -
用户ID和组ID:进程的身份凭证,所有线程共享。
-
进程与线程关系图(深化理解)
cpp
      +-------------------------------------------------------+
      |                  Process (资源容器)                    |
      |  PID = 1234                                           |
      |-------------------------------------------------------|
      |  ┌─────────────────────────────────────────────────┐  |
      |  |             Virtual Address Space               |  |
      |  |                                                 |  |
      |  |  Code Segment  (共享) - printf, main, ...        |  |
      |  |  Data Segment  (共享) - global_var, static_var   |  |
      |  |  Heap          (共享) - malloc'd memory          |  |
      |  |                                                 |  |
      |  |  ┌─────────────┐  ┌─────────────┐  ┌─────────┐  |  |
      |  |  | Thread 1    |  | Thread 2    |  | ...     |  |  |
      |  |  | Stack       |  | Stack       |  |         |  |  |
      |  |  | (私有)       |  | (私有)      |  |         |  |  |
      |  |  |-------------|  |-------------|  |         |  |  |
      |  |  | TID = 4567  |  | TID = 4568  |  |         |  |  |
      |  |  | Registers   |  | Registers   |  |         |  |  |
      |  |  | (私有)       |  | (私有)      |  |         |  |  |
      |  |  └─────────────┘  └─────────────┘  └─────────┘  |  |
      |  |                                                 |  |
      |  └─────────────────────────────────────────────────┘  |
      |                                                       |
      |  文件描述符表 (共享) - fd0, fd1, fd2 (socket, file)      |
      |  信号处理方式 (共享) - SIGINT -> handler()               |
      |  用户ID/组ID (共享) - uid=1000, gid=1000                |
+-------------------------------------------------------+这张图直观地展示了:线程是进程地址空间内的一个执行实体,它既共享容器的广阔资源,又保有自己独立的"工作台"(栈和上下文)。
4.2 关于进程线程的问题
如何看待单进程?
一个单进程,就是一个只包含一个线程执行流的资源容器。
它是多线程进程的一个特例。所有关于多线程的规则都适用于它:
-
它独占一个栈、一组寄存器、一个TID(此时TID通常等于PID)。
-
它独享整个进程的资源包(地址空间、文件描述符等)。
从学习的角度看,我们最初学习的"进程"概念,实际上就是这种"单线程进程"。它是一切的基础。引入了多线程之后,我们需要把原来"进程"的概念进行拆分:
-
原来认为进程"既有资源又是执行流",现在要清晰地认识到:"进程是资源包,线程是执行流"。
-
单线程进程是"资源包"里只有一个"执行流"。
-
多线程进程是"资源包"里有多个"执行流"。
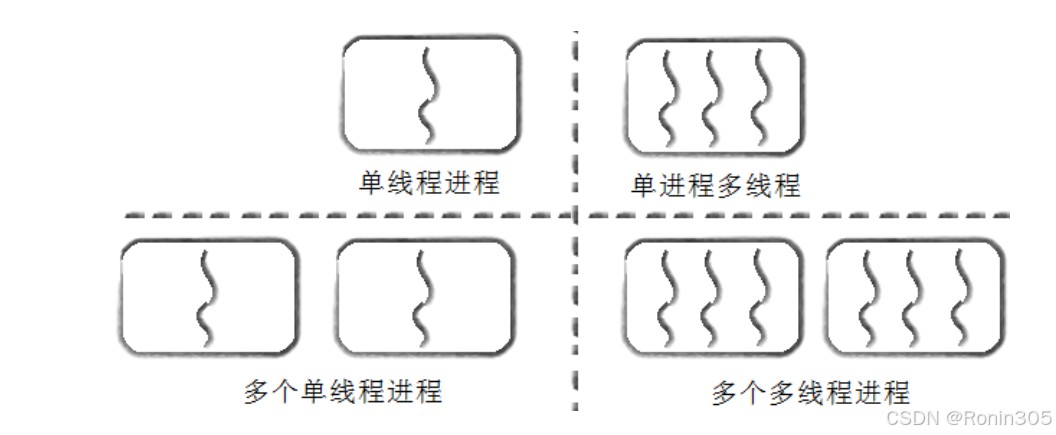
它让我们能更清晰地分析问题:当遇到数据冲突时,我们知道要去检查多个执行流(线程) 对共享资源(进程的数据段、堆) 的访问是否加了同步保护。