近期,以 OpenAI o 系列模型、Claude 3.5 Sonnet 和 DeepSeek-R1 等各类大模型为代表的 AI 技术快速发展,其知识与推理能力得到了广泛认可。然而,许多用户在实际使用中也注意到一个普遍现象:模型有时未能严格遵循输入指令的具体格式要求、字数限制或内容约束,导致输出结果虽内容尚可,却不完全符合输入指令。
针对大模型知识推理能力与指令遵循能力存在表现差异的现象,为推进指令遵循能力的系统化研究与精准评估,美团 M17 团队推出全新评测基准 Meeseeks。
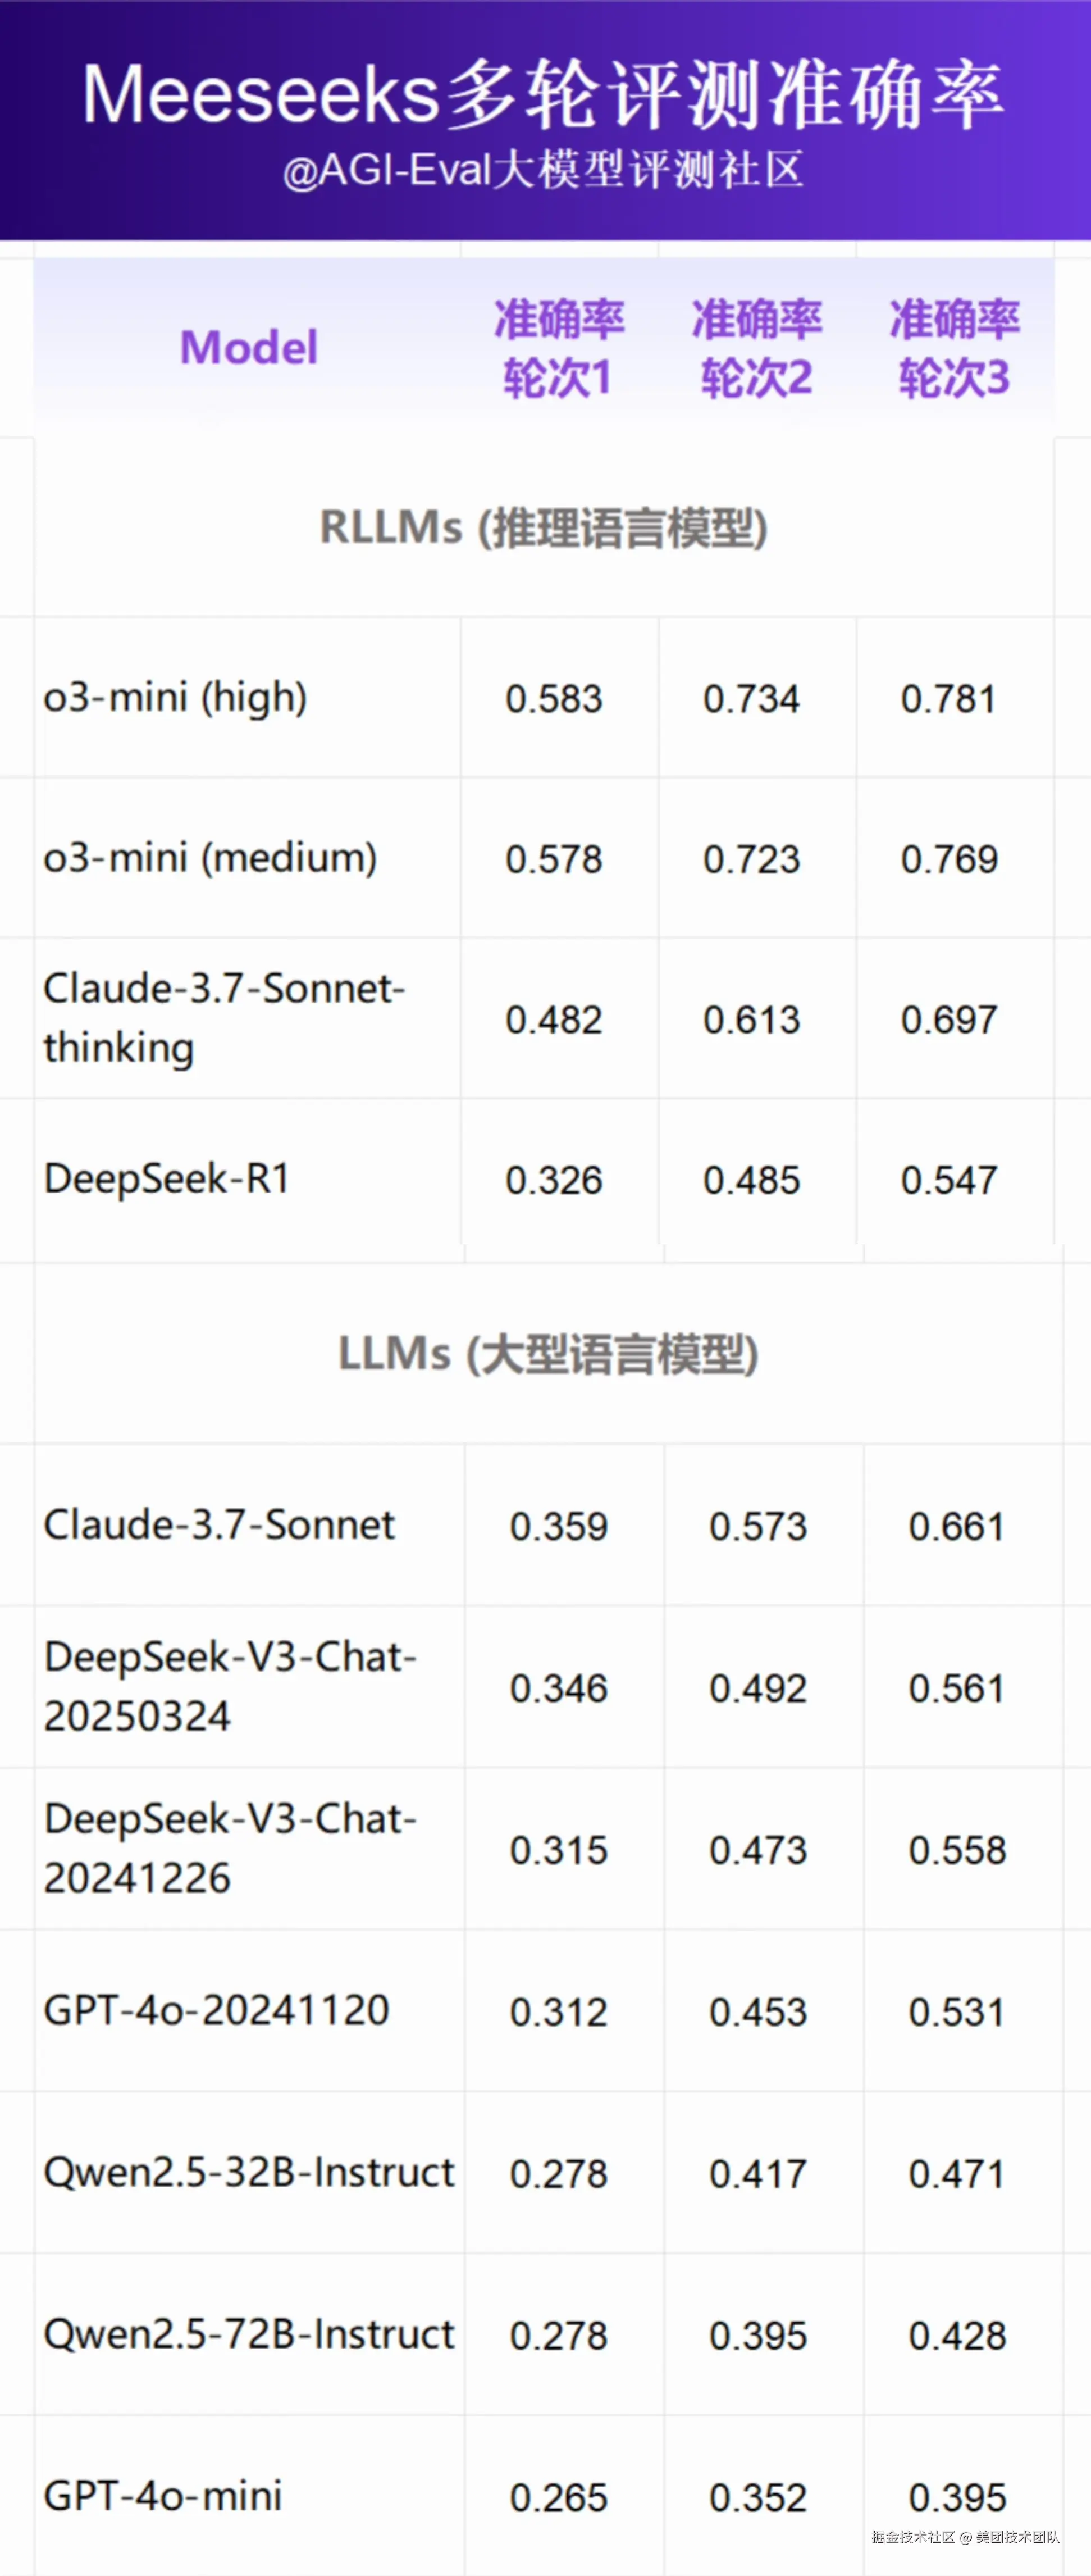
基于 Meeseeks 基准的评测结果显示(以轮次 3 为准),推理模型 o3-mini (high)凭借绝对优势强势登顶,与另一版本 o3-mini(medium)包揽冠亚军;Claude 3.7 Sonnet 的"思考版"则稳居第三,共同构成本次评测的第一梯队,而 DeepSeek-R1 在所有模型中排名仅第七,GPT-4o 排名第八。此外 DeepSeek-V3 在非推理大模型中处于领先位置,而 Qwen2.5 则展现出参数规模与指令遵循能力并非绝对相关的有趣现象。(备注:评测结果来源于 Meeseeks 中文数据)
Meeseeks 支持 中文/英文,已在魔搭社区、GitHub、Huggingface 上线。
- 魔搭社区 :www.modelscope.cn/datasets/AD...
- GitHub : github.com/ADoublLEN/M...
- Huggingface :huggingface.co/datasets/me...
下面,让我们一同深入了解 Meeseeks 评测体系及其具体发现。
1. Meeseeks:重新定义大模型"听话"能力评测
Meeseeks 是一个完全基于真实业务数据构建的,专注于评测大模型指令遵循(Instruction-Following)能力的基准测试。它引入了一种创新的评测视角:只关注模型是否严格按照用户指令(Prompt)的要求生成回答,而不评估回答内容本身的知识正确性。为了全面、深入地衡量模型的指令遵循能力,研究人员设计了一套覆盖不同粒度和层面的精细化评测框架。
1.1 精细入微的三级评测框架
你可能遇到过这种情况:让模型 "用 50 字介绍北京,别提故宫",结果它写了 80 字,还顺口夸了句 "故宫雄伟"。这就是典型的 "指令遵循翻车"------不看对错,只看是否按要求来。
Meeseeks 的评测框架从宏观到微观,把这种 "要求" 拆成了三层,像剥洋葱一样细,确保评估的深度与广度。
- 一级能力:任务核心意图与结构的把握。这是最基础的层面,主要评估模型是否正确理解了用户的核心任务意图(Intent Recognition)、回答的整体结构是否满足指令(Output Structure Validation),以及回答中的每一个独立单元是否都符合指令细节(Granular Content Validation)。例如,在"以 JSON 格式生成 10 个以'天'开头的花名"指令中,一级能力会分别检查模型是否理解了"生成花名"的意图、是否输出了 10 个条目并采用了 JSON 格式、以及每个花名是否都以"天"字开头。
- 二级能力:具体约束类型的实现。 在理解任务的基础上,此层级关注模型对各类具体约束的执行情况,主要分为内容约束与格式约束。内容约束包括主题(如改编歌词需提及特定内容)、文体(如生成剧本)、语言(如繁体)、字数(如精确值、范围)等;格式约束则涵盖模版合规(如 JSON、Markdown)、单元数量(如生成指定数量的评论)等。
- 三级能力:细粒度规则的遵循。 这是最精细的评测层面,关注那些极易被模型忽略的细节规则。这包括通用的细则,如押韵、关键词规避、禁止重复、符号使用、特定写作手法等;也包括中文特有的规则,如平仄、成语接龙等,全面考验模型的细致程度。
2. Meeseeks 评测结果
本次 Meeseeks 基准评测清晰地揭示了不同模型在指令遵循与自我纠错能力上的显著差异。评测结果显示,RLLMs(推理语言模型)在所有轮次中均展现出压倒性优势,而一些知名大模型的表现则引发了深入思考。
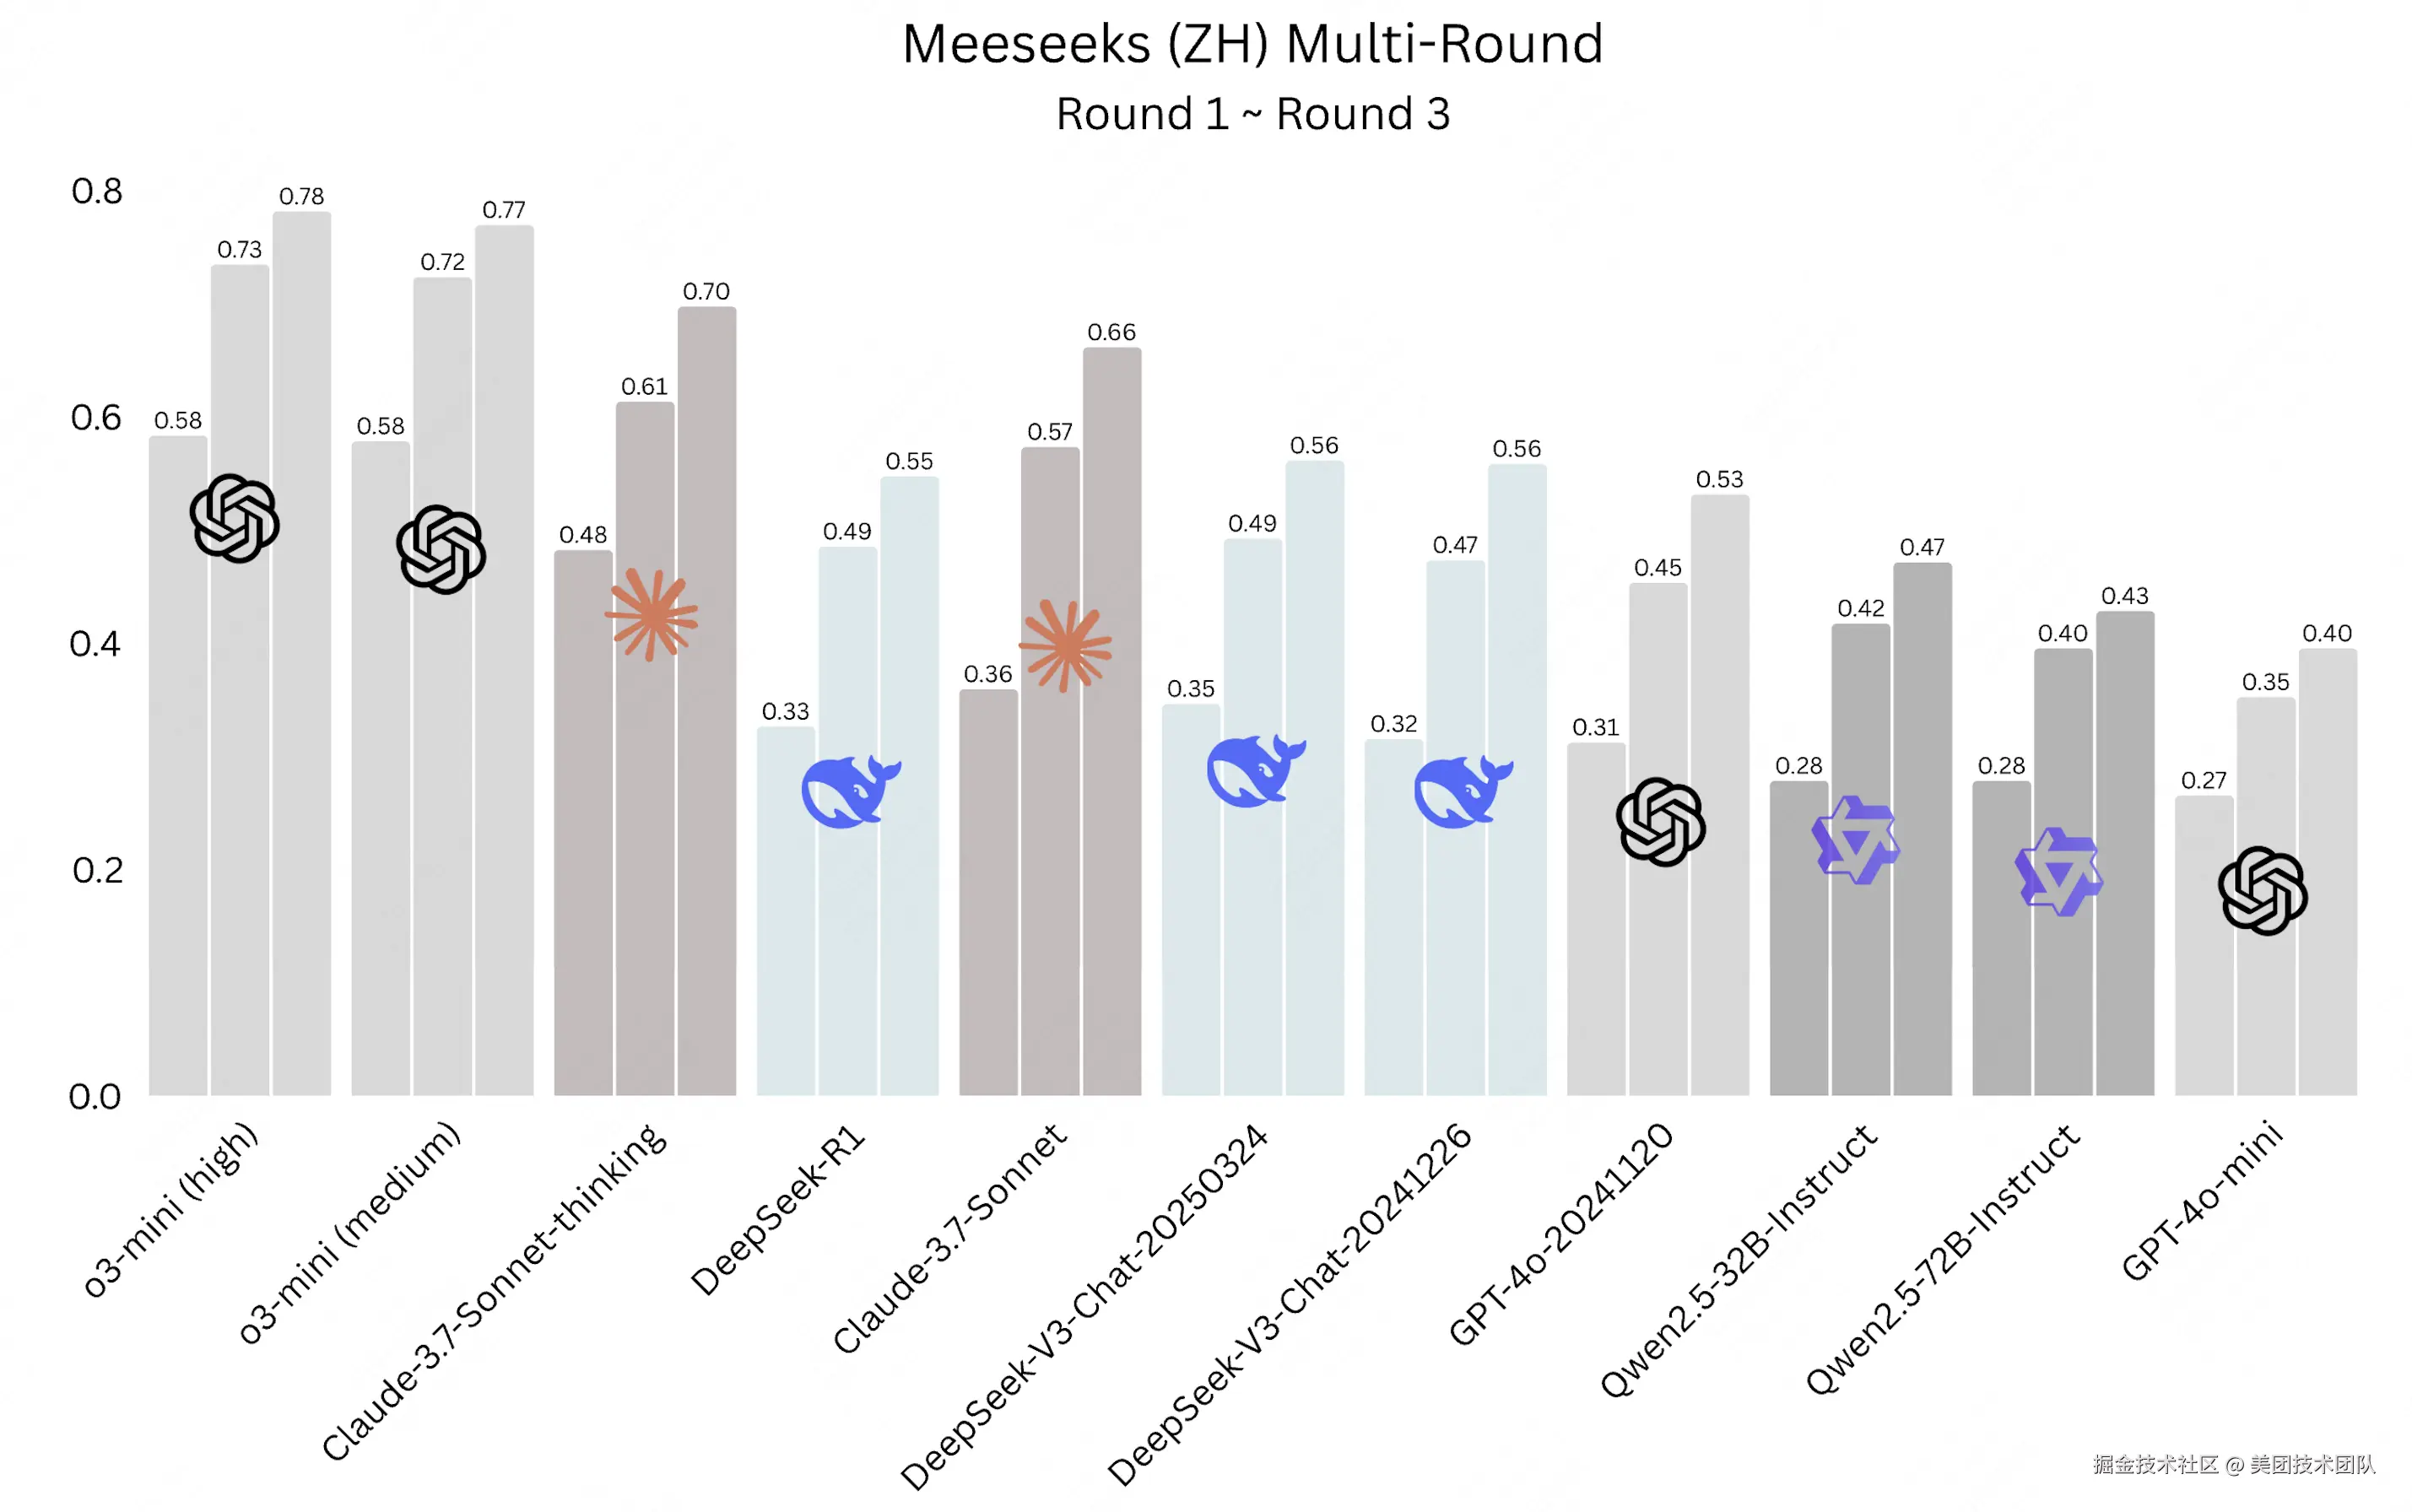
在经过三轮评测后,各模型的最终排名与表现分析如下:
- OpenAI o-series 绝对优势:o3-mini(high)与 o3-mini(medium)在本次评测中位列第一与第二名。作为推理语言模型(RLLMs),它们在指令遵循任务上表现突出。
- GPT-4o 跌出第一梯队:与 o-series 模型的强势表现相比, GPT 系列的模型表现意外不佳:GPT-4o 最终排名为第八(准确率 0.531)。分析显示,其排名受初始准确率(0.312)较低的影响,且在多轮纠错环节中的准确率提升幅度(总计提升 0.219),小于部分其他参评模型。
- Claude 系列表现强劲:Claude 系列模型在此次评测中表现出显著的自我纠错能力。其中,具备推理能力的 Claude-3.7-Sonnet-thinking 排名第三。其标准版 Claude-3.7-Sonnet 则在所有参评的通用大模型(LLMs)中位列第一,总排名为第四。
- DeepSeek 系列位居评测中游:DeepSeek 系列模型在中游排名中呈现出性能趋同与反转的现象。评测发现,DeepSeek-V3 的两个版本在多轮评测后性能趋于一致。同时,DeepSeek-R1 在初始轮次领先的情况下,其最终排名被 DeepSeek-V3-Chat-20241226 超越。
- Qwen2.5 系列观察:Qwen2.5 系列的两个模型排名相对靠后。其中一个值得关注的现象是,参数量较小的 32B 版本在三轮评测后的最终表现,优于参数量更大的 72B 版本。
3. Meeseeks 的独特优势
3.1 横向对比:更广、更细、更客观、更高难度
相较于 IF-Eval、Complexbench 等知名的开源指令遵循评测集,Meeseeks 在多个维度上实现了突破,展现出其独特的评测价值。
Meeseeks 通过四个关键特性,构建了其在横向对比中的核心竞争力。
首先是 覆盖面更广,其数据源于丰富的真实业务场景,确保了评测的全面性与实用价值。
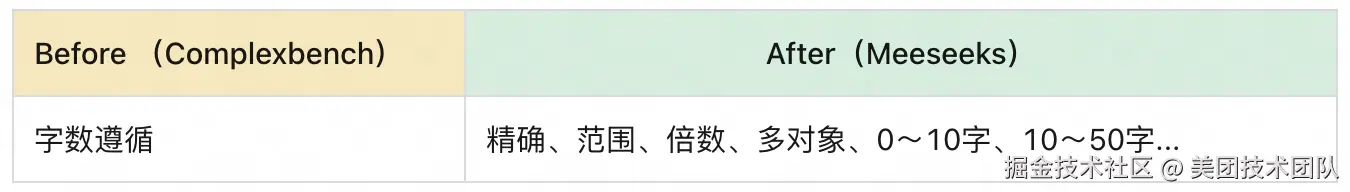
其次是 评测粒度更细,它将单一约束拆解得更为精细,如将"字数遵循"细分为精确值、范围、倍数等多种情况,实现了对模型能力的精准画像。
再者是 杜绝主观评测,摒弃了如"以妈妈的口吻"这类模糊指令,所有评测项均为客观可判定标准,保证了结果的一致性。
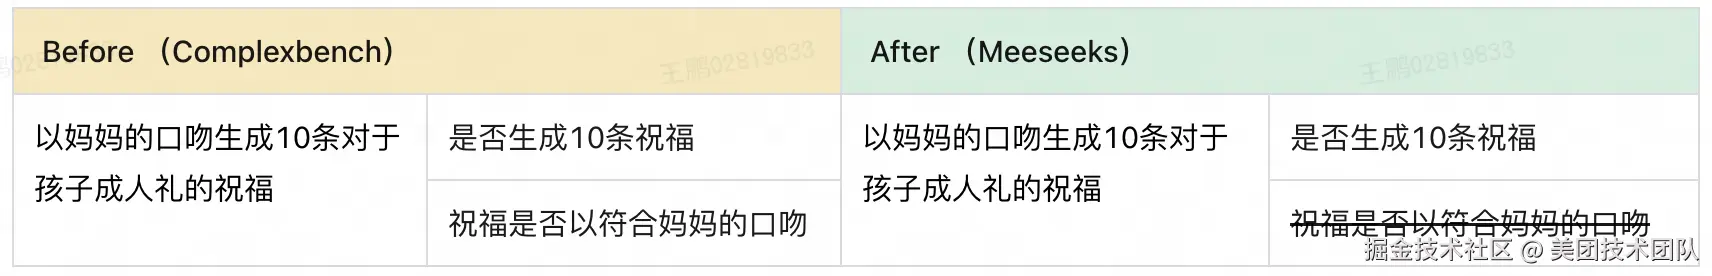
最后是 数据难度更高,其测试用例设计更具挑战性,能有效拉开不同模型间的差距。
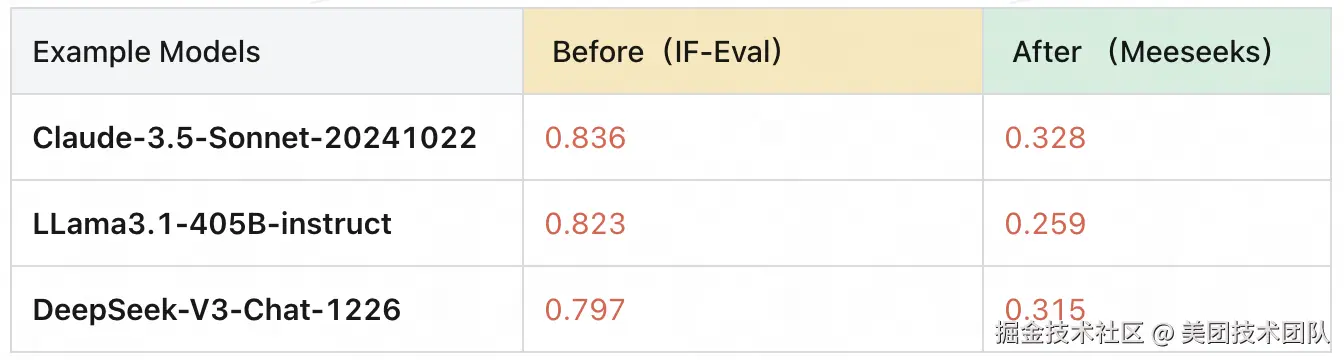
3.2 纵向创新:革命性的"多轮纠错"模式
Meeseeks 最具突破性的特点:
- 其一评测 更灵活:受模型回答风格/格式影响小,无需限定模型回答特定格式,对不同模型的兼容性更强;
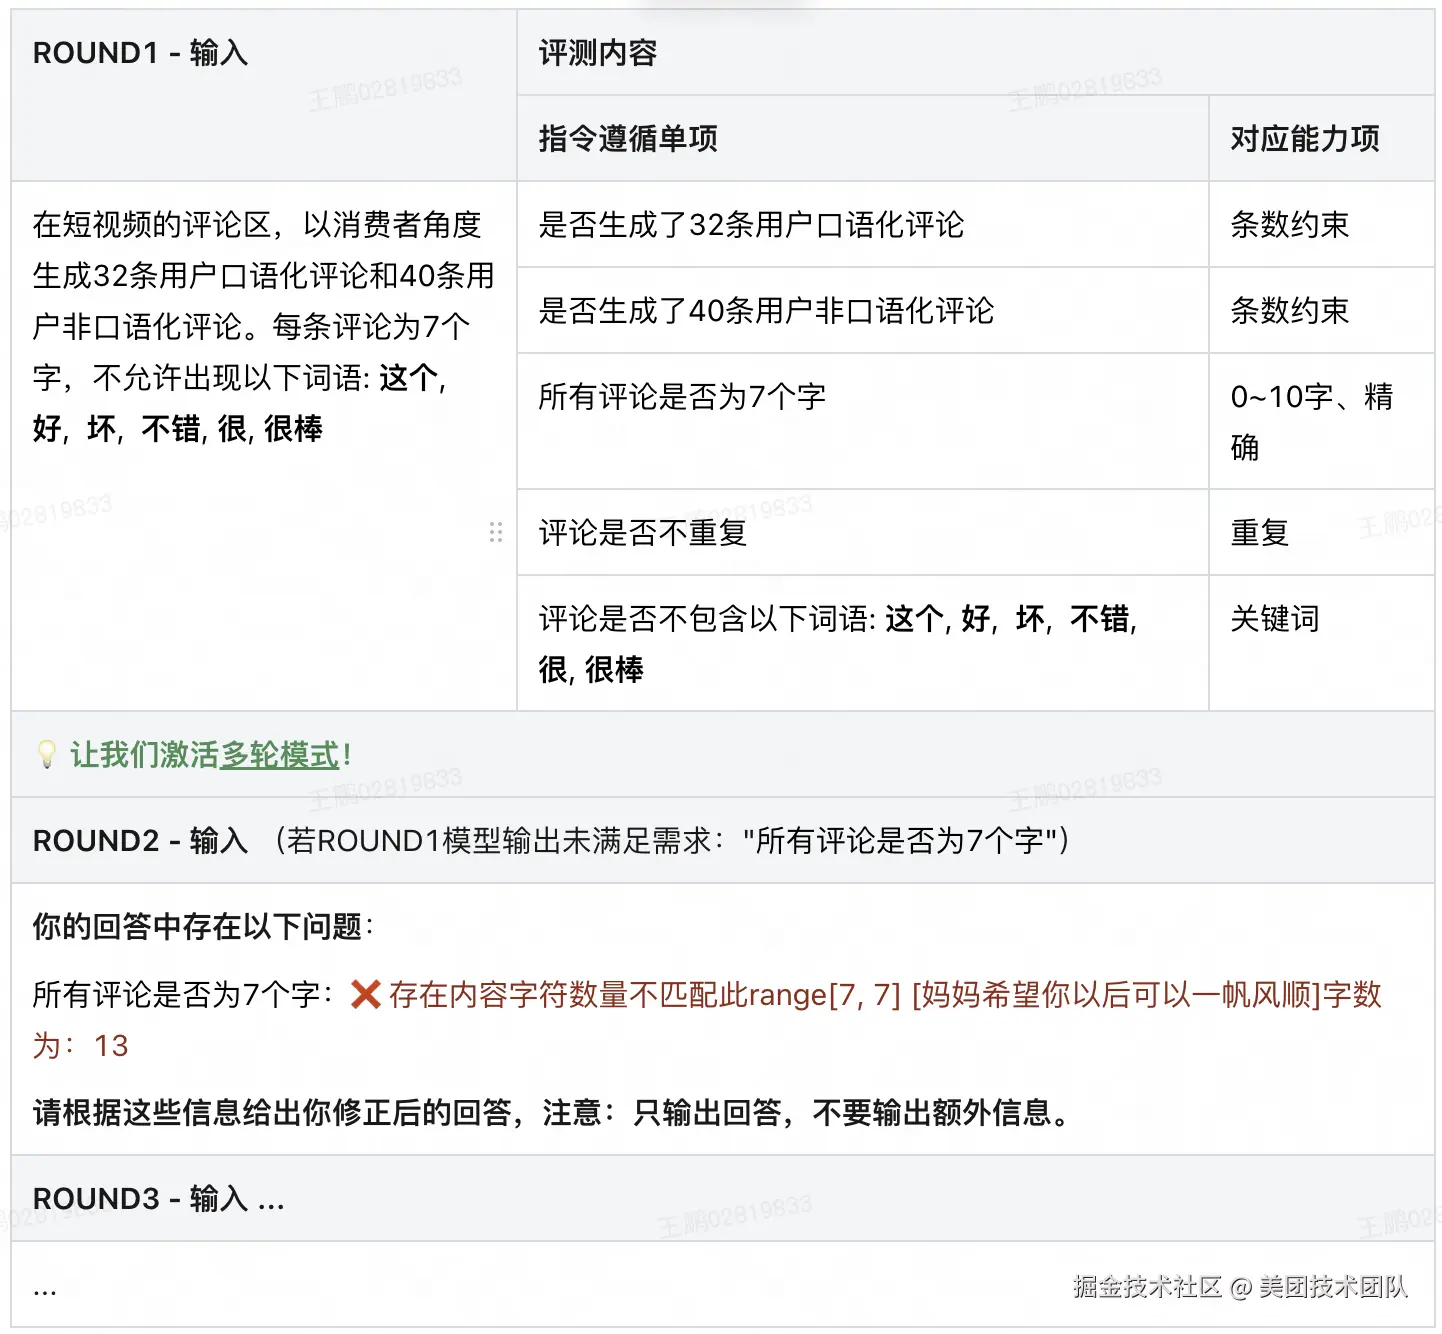
- 其二 全新的"多轮模式"。在该模式下,如果模型的第一轮回答未能完全满足所有指令,评测框架会自动生成明确的反馈,指出具体哪个指令项未被满足,并要求模型根据该反馈修正答案。这种模式首次将模型的"自我纠错"能力纳入指令遵循的评测范畴。
为了验证该模式的有效性,研究团队选择了一批具有代表性的推理语言模型(RLLMs)和大型语言模型(LLMs)进行了评测。如前文图 1 所示,结果清晰地展示了各模型在不同纠错轮次下的表现。
4. 核心评测洞察
通过对多轮评测数据的深入分析,研究团队得出以下几点关键发现:
- 强大的自我纠错潜力:所有模型在接收到反馈后,其指令遵循准确率均有显著提升。例如 Claude-3.7-Sonnet 在第二轮的准确率从 0.359 跃升至 0.573,我们得出结论:不管是 RLLMs 还是 LLMs 在指令遵循场景,都存在强大的自我纠正的能力。
- 首轮表现与最终表现的相关性: 模型的第一轮表现(Round 1)与其最终表现(Round 3)并非完全相关。部分模型存在第一轮劣势,但是第三轮优势的情况,这说明了模型自我纠错至正确答案的能力和能一次遵循所有用户指令的能力并非完全相关。
- 与部分指令遵循 Benchmark 相悖的是:RLLMs 的指令遵循能力相比 LLMs 更加优异,特别是 o3-mini 这样的 RLLMs 不仅初始表现优异,其后续提升同样显著,最终以绝对优势领跑。我们发现,在大量文案生成任务中,我们发现了一些模型会反复确认当前输出的内容是否与之前重复;在存在字数要求的场景下,RLLMs 甚至会出现 1 你 2 好这样的辅助 index 方法来确认字数,这些给 RLLMs 在指令遵循任务上带来了非常大的优势。
- 多轮场景下长思维效益缩减?具备更强推理能力的模型(如 Claude-3.7-Sonnet-thinking)与其对应的标准版本(Claude-3.7-Sonnet)在指令遵循能力上的差距,会随着纠错轮次的增加而逐渐缩小,这表明反馈机制可以在一定程度上代替了 RLLMs 的长思维链带来的效益,有效地让模型逐渐达到自身指令遵循能力的上限。
5. 总结与展望
综上所述,面对当前大模型普遍存在的"不听话"痛点,Meeseeks 基准通过其精细化的三级评测框架、对客观性的严格坚守以及革命性的"多轮纠错"模式,把评测结果不仅揭示了顶尖模型在复杂指令面前的真实短板,也验证了模型强大的自我修正潜力,将指令遵循评测带到了全新的维度。这为模型开发者指明了优化方向:除了提升基础能力,更要强化模型理解并执行修正指令的能力。
目前,对于共计 11 种语言的 Meeseeks 多语言版本已经在开发末期,多语言 Meeseeks 不仅在保证准确率的基础上适配了不同语言,并基于不同语言的特色内容构建了全新的指令遵循内容,会在不远的将来和大家见面!
未来我们将持续专注于高质量评估研究,推动大模型在指令遵循能力上的提升与发展。欢迎关注美团 M17 团队,了解更多关于评测集的内容!
| 关注「美团技术团队」微信公众号,在公众号菜单栏对话框回复【2024年货】、【2023年货】、【2022年货】、【2021年货】、【2020年货】、【2019年货】、【2018年货】、【2017年货】等关键词,可查看美团技术团队历年技术文章合集。
| 本文系美团技术团队出品,著作权归属美团。欢迎出于分享和交流等非商业目的转载或使用本文内容,敬请注明"内容转载自美团技术团队"。本文未经许可,不得进行商业性转载或者使用。任何商用行为,请发送邮件至 tech@meituan.com 申请授权。