关于表组
表组(Table Group)是一个逻辑概念,表示一组表的集合。默认情况下,不同表之间的数据是随机分布的,没有关系。通过定义表组,可以控制一组表在物理存储上的邻近关系。
在 V3.x 版本中,表组为定义了分区的表组,其加入的表要求与表组的分区方式完全一致,限制了表加入表组,有较强的约束性;从 V4.2.0 版本开始,表组没有了分区概念,只需要定义 SHARDING 属性,就可以很灵活的将不同分区方式的表加入,如果想要限制别的表加入表组,可以修改表组的属性,表组管理更灵活。
对于 SHARDING 属性的表组,根据 SHARDING 属性值的不同,主要可以分为以下两大类:
-
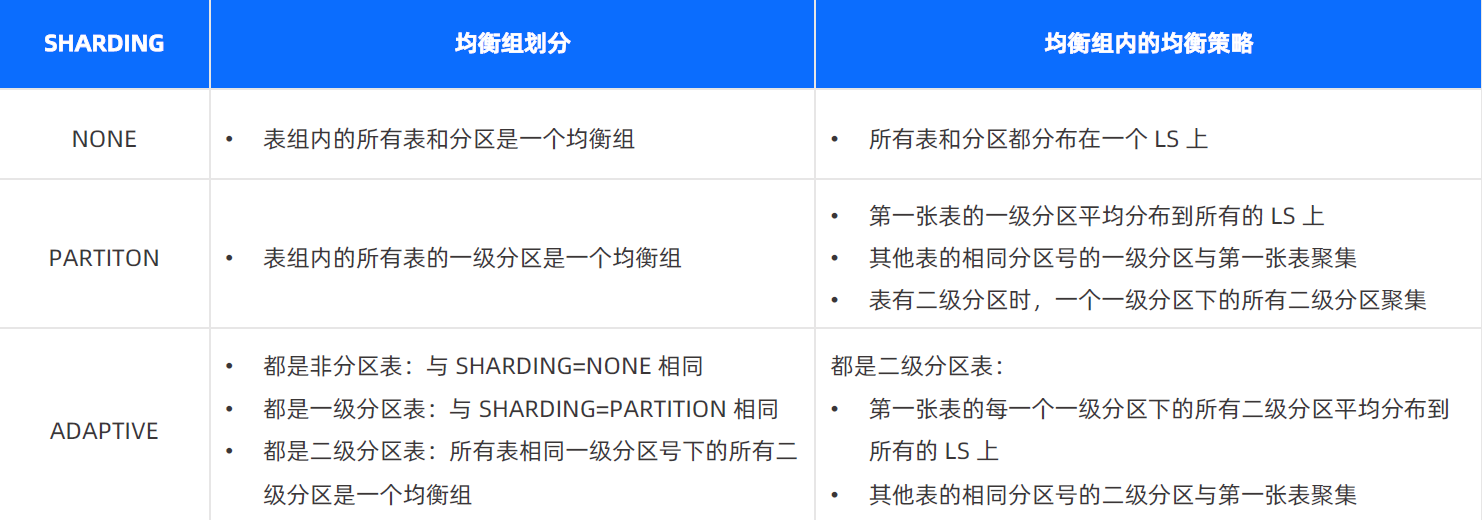
SHARDING = NONE的表组:此类表组内的所有表的所有分区均聚集在同一台机器上,并且不限制表组内表的分区类型。 -
SHARDING不为NONE的表组:此类表组内每一张表的数据会打散分布在多台机器上。为了保证所有表的数据分布相同,还要求表组内所有表的分区定义一致,包括分区类型、分区个数、分区值等。系统会调度具有相同分区属性的分区聚集(对齐)在同一台机器上,从而实现 Partition Wise Join。SHARDING不为NONE的表组,又分为以下两种:-
SHARDING = PARTITION的表组:表组内每一张表的数据按一级分区打散,如果是二级分区表,则一级分区下的所有二级分区聚集在一起。分区要求:所有表的一级分区的分区定义相同;如果是二级分区表,也只校验一级分区的分区定义。因此,一级分区表和二级分区表可以同时存在,只要这些表的一级分区的分区定义相同即可。
分区对齐规则:具有相同一级分区值的分区聚集在一起,包括:一级分区表的一级分区和二级分区表对应一级分区下的所有二级分区。
-
SHARDING = ADAPTIVE的表组:表组内每一张表的数据根据自适应方式打散。即,如果表组内的表是一级分区表,则按一级分区打散;如果表组内的表是二级分区表,则按每个一级分区下的二级分区打散。此类表组内表的分区要求及分区对齐规则如下:
-
分区要求:表组内的表全部是一级分区表或者全部是二级分区表。如果是一级分区表,则要求一级分区的分区定义相同;如果是二级分区表,则要求一级分区和二级分区的分区定义都相同。
-
分区对齐规则:如果表组内的表全部是一级分区表,则一级分区值相同的分区聚集在一起;如果表组内的表全部是二级分区表,则一级分区值和二级分区值均相同的分区聚集在一起。
-
-
基于表组的分区均衡
OceanBase 数据库依据表组的 SHARDING 属性,相应地划分表组内表和分区的均衡组,并基于均衡组进行组内均衡和组间均衡,达到不同表、分区的聚合与均衡的目的。
基于表组(Table Group)的 SHARDING 属性进行组内均衡的策略: