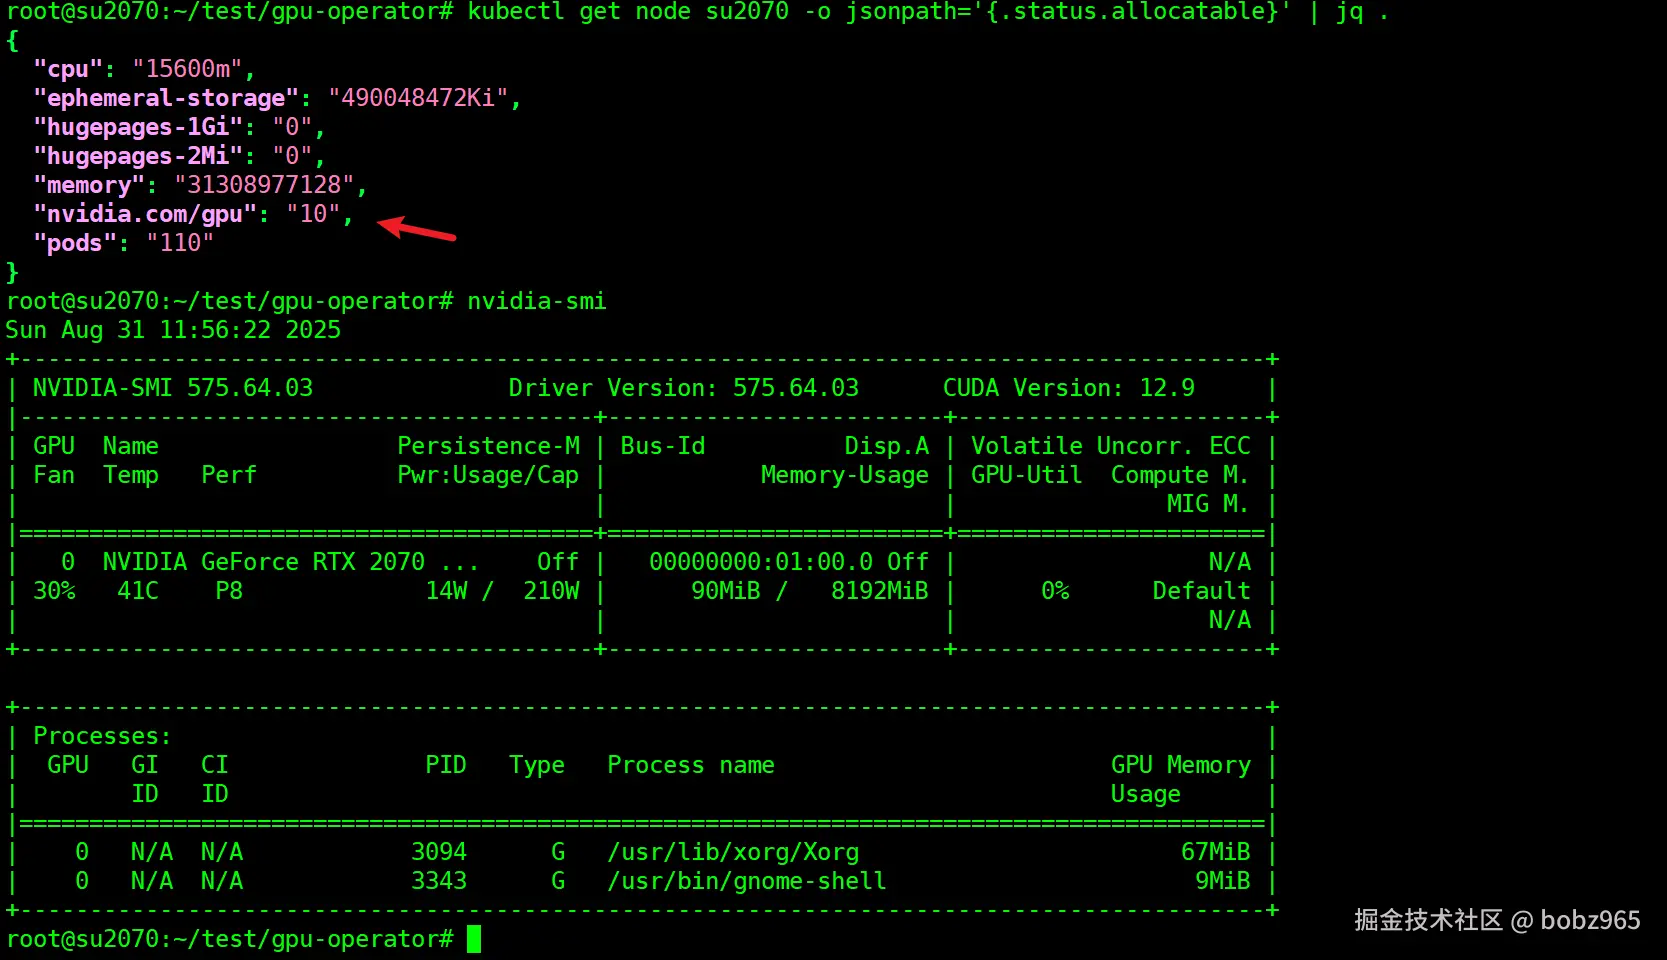
gpu 容量误分配

在 Kubernetes 集群中,"nvidia.com/gpu": "10" 表示节点 su2070 向集群报告的可分配 GPU 资源数量为 10 个。

不过,结合你提供的 nvidia-smi 输出可以发现,该节点实际只配备了 1 块 NVIDIA GeForce RTX 2070 显卡。这种数值不匹配通常是由以下原因导致的:

  1. GPU 资源配置问题:可能是通过 Kubernetes 设备插件(如 NVIDIA GPU Operator)配置时,误将 GPU 资源数量设置为 10。这通常与 GPU 分片、MIG(多实例 GPU)配置有关,但你的显卡(RTX 2070)并不支持 MIG 功能。
  1. 配置错误:可能是在安装 NVIDIA 设备插件时,通过配置参数(如 NVIDIA_VISIBLE_DEVICES 或自定义资源配置)错误地设置了可分配 GPU 数量。
  1. 插件版本或配置问题:NVIDIA GPU Operator 或相关设备插件可能存在配置错误,导致错误报告 GPU 数量。

要解决这个问题,建议检查:

  • NVIDIA GPU Operator 的配置
  • 节点上的设备插件配置
  • 确认显卡是否支持分片或 MIG(RTX 2070 不支持)

正确配置后,nvidia.com/gpu 的值应与实际物理 GPU 数量一致(即应为 1)。

相关推荐
程序猿DD4 小时前
OctaFuse Gateway 2.15.0:MCP 聚合、向量 Embeddings 与官方目录同步
后端·agent
余槐i6 小时前
PostgreSQL 函数索引报错 must be immutable:3种绕法与代价
数据库·后端·sql·postgresql·性能优化
需要8267 小时前
Spring Bean 生命周期:从实例化到销毁的完整钩子
java·后端·spring
凤山老林8 小时前
Spring Boot 接入国密 SM2/SM3/SM4 的一些实践记录
spring boot·后端·python
伯恩bourne9 小时前
Spring Boot Bean 注册的两种方式:@Component 家族 vs @Configuration + @Bean
java·spring boot·后端
张彦峰ZYF9 小时前
停顿短不等于延迟低:G1、ZGC 与低延迟服务的目标分野、代价账本与选型标定
后端·回收暂停、应用停止总时长·到达安全点、分配停滞·屏障吃吞吐、并发线程吃核心·并发窗口吃堆余量·分区式靠挑回收集兑现目标·染色指针式不支持压缩引用
pride.li10 小时前
第03章 Python 教程-基础语法:注释与变量
服务器·前端·后端·python·算法·计算机视觉
upala10 小时前
【仓颉语言入门 · 第二篇 第 6 课】
后端
罗丹丹Luna10 小时前
移动端显示“已提交”以后:SAP 与低代码集成该怎样暴露真实状态
后端·架构
码事漫谈10 小时前
因为太想讨好你,所以AI会骗你
后端