text:全文检索类型,经过分词处理,支持模糊匹配
keyword:精确匹配类型,适用于聚合、排序和过滤
text
1. 核心属性
analyzer属性:
指定用于索引和搜索的分词器
默认使用标准分析器(Standard Analyzer)
示例:"analyzer": "ik_max_word"(中文分词器)
search_analyzer属性:
指定用于搜索的分词器
当搜索时需要使用不同分词器时设置
示例:"search_analyzer": "ik_smart"
fields属性:
创建子字段实现多用途索引
典型用法:"fields": {"raw": {"type": "keyword"}}
2. 高级属性
index_options属性:
控制倒排索引的存储方式
可选值:docs(默认)、freqs、positions、offsets
影响查询性能和存储空间
similarity属性:
设置相似度算法
影响评分计算方式
可选值:BM25(默认)、classic等
copy_to属性:
将多个字段值合并到单个字段
常用于构建组合搜索字段
示例:"copy_to": "full_text"
3. 性能优化属性
eager_global_ordinals属性:
优化聚合性能
预加载全局序数(ordinals)数据
默认false
boost属性:
设置字段权重
影响搜索结果排序
示例:"boost": 2.0
ignore_above属性:
设置字段最大索引长度(UTF-8字符数)
超过该长度的值不会被索引(默认256)
示例:"ignore_above": 1024
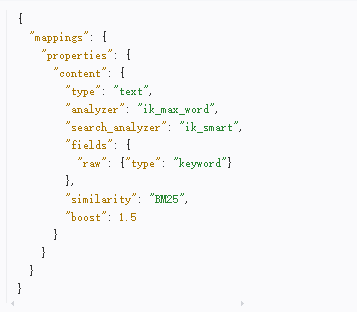
4. 典型配置示例
keyword
1. 核心属性
index属性:
控制字段是否被索引(true/false)
index: true时支持搜索、排序和聚合操作
index: false时仅存储原始值
ignore_above属性:
设置字段最大索引长度(UTF-8字符数)
超过该长度的值不会被索引(默认256)
示例:"ignore_above": 1024
2. 高级属性
normalizer属性:
指定自定义规范化器
用于统一处理大小写、重音符号等
copy_to属性:
将字段值复制到其他字段
常用于构建组合搜索字段
doc_values属性:
控制是否存储列式存储数据
默认true,支持高效排序和聚合
3. 特殊属性
eager_global_ordinals属性:
优化聚合性能
预加载全局序数(ordinals)数据
similarity属性:
设置相似度算法
影响评分计算方式
4. 多字段属性
fields属性:
创建子字段实现多用途索引
示例:"fields": {"raw": {"type": "keyword"}}
meta属性:
存储元数据信息
用于特殊业务逻辑处理
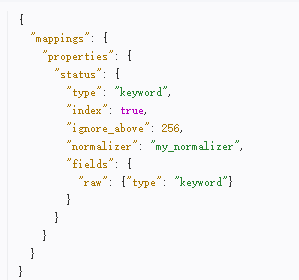
5.典型配置示例