最近在学习计算机网络,想着跟python结合做一些事情。
这段代码是一个自动化脚本,它主要有三个功能:
-
分析日志: 它从你指定的日志文件中读取内容,并筛选出所有包含特定关键字的行。
-
网络交互: 它将筛选出的数据打包成 JSON 格式,并通过 HTTP 请求发送到一个指定的 API 地址。
-
文件管理: 它在完成分析后,会自动将原始的日志文件备份到一个新创建的文件夹中。
这个脚本将所有这些功能整合在一起,实现了从数据处理到网络通信再到文件管理的一系列自动化操作。
1.代码
python
import os
import sys
import json
import shutil
import subprocess
import requests
import re

def analyze_and_upload(log_file_path, keyword):
    """
    分析日志文件并上传匹配结果到API。
    参数:
    log_file_path: 日志文件路径 (str)
    keyword: 要搜索的关键字 (str)
    """

    # 1. 检查文件路径是否存在
    if not os.path.exists(log_file_path):
        print(f"错误: 文件 '{log_file_path}' 不存在。")
        sys.exit(1)

    matched_logs = []
    try:
        # 2. 读取文件并使用正则表达式过滤
        with open(log_file_path, 'r', encoding='utf-8') as f:
            for line in f:
                if re.search(keyword, line, re.IGNORECASE):
                    matched_logs.append(line.strip())

        total_matches = len(matched_logs)
        print(f"在文件中找到了 {total_matches} 行包含关键字 '{keyword}' 的日志。")

        if total_matches == 0:
            print("没有匹配的日志,无需上传。")
            return

    except Exception as e:
        print(f"读取文件时发生错误: {e}")
        sys.exit(1)

    # 3. 准备数据并上传
    upload_data = {
        'keyword': keyword,
        'total_matches': total_matches,
        'matched_logs': matched_logs
    }

    upload_url = 'https://webhook.site/xxx'
    headers = {'Content-Type': 'application/json'}

    try:
        # 使用requests库进行POST请求
        response = requests.post(upload_url, data=json.dumps(upload_data), headers=headers, timeout=10)

        # 检查响应状态码
        if response.status_code == 200:
            print("数据上传成功。")
            #print("API响应:", response.json())
        else:
            print(f"数据上传失败,状态码: {response.status_code}")
            print("响应内容:", response.text)

    except requests.exceptions.RequestException as e:
        print(f"请求API时发生错误: {e}")
        # 如果你正在调试,可以在这里打印更详细的错误
        # print(f"请求API时发生错误: {e.__class__.__name__} - {e}")

    # 4. 备份文件
    try:
        backup_dir = 'log_backups'
        if not os.path.exists(backup_dir):
            os.makedirs(backup_dir)

        backup_file_path = os.path.join(backup_dir, os.path.basename(log_file_path) + '.bak')
        shutil.copy(log_file_path, backup_file_path)
        print(f"日志文件已成功备份到 '{backup_file_path}'。")

    except Exception as e:
        print(f"备份文件时发生错误: {e}")


if __name__ == '__main__':
    # 获取命令行参数
    # 例如:python log_analyzer.py my_log.txt ERROR
    if len(sys.argv) != 3:
        print("用法: python log_analyzer.py <日志文件路径> <关键字>")
        sys.exit(1)

    log_file = sys.argv[1]
    search_keyword = sys.argv[2]

    # 调用主函数
    analyze_and_upload(log_file, search_keyword)
2.注
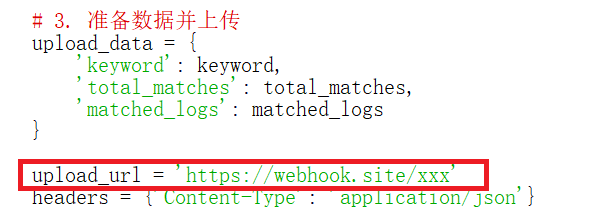
上传的url可以选用个人网站或者访问webhook.site,它会生成一个url供测试使用
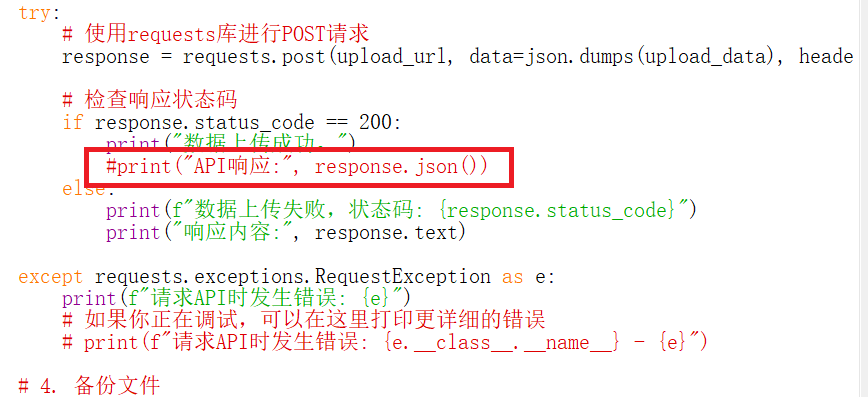
注释掉response.json()的原因是,访问自己的 Webhook URL 时,它会返回一个 HTML 页面,其中包含了所有发送到该 URL 的请求的列表。这个 HTML 页面不是 JSON 格式,所以response.json()无法解析它。