爬取步骤:
1.先找到网页源代码
2.从网页源代码中拿到m3u8
3.下载m3u8
4.读取m3u8文件,下载视频
5.合并视频
首先我们来爬取一个星辰影院的电影:
下面我以这个为例:
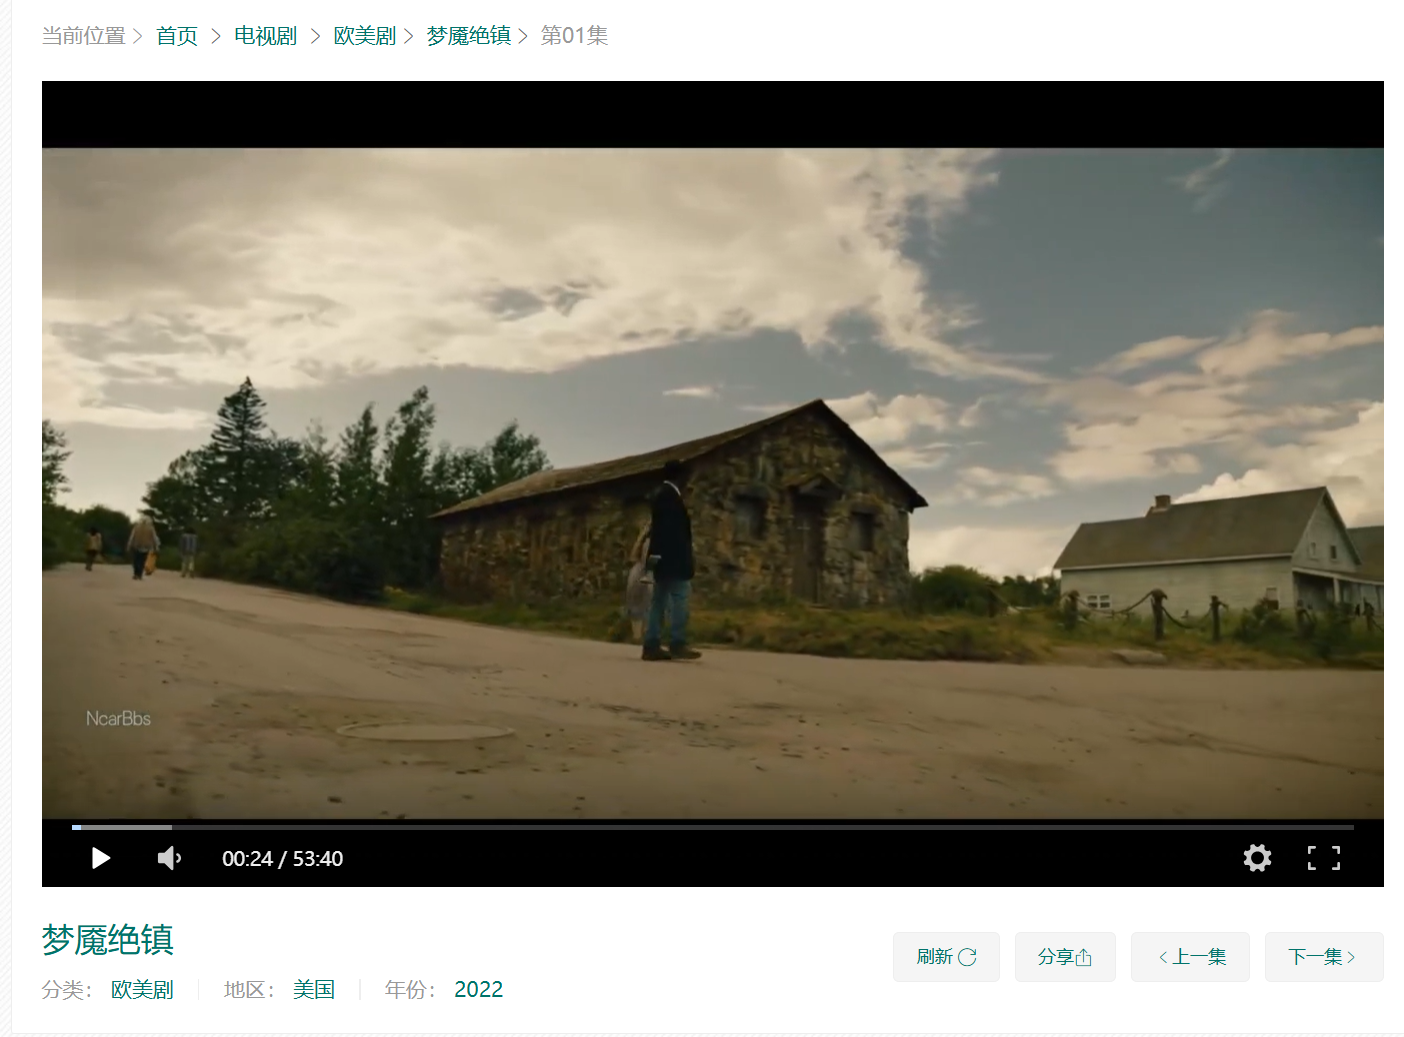
我们需要在源代码中找到m3u8这个url:
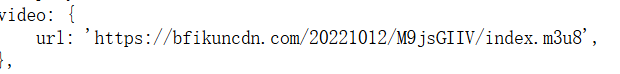
紧接着我们利用下面的方法来进行视频的爬取:
输入网站的url:
python
url="https://www.xcyy44.com/play/16166_1.html"打印一下看一下是否有我们要的数据:
python
resp=requests.get(url)
print(resp.text)
在搜索框中搜索一下发现正是我们要的url:
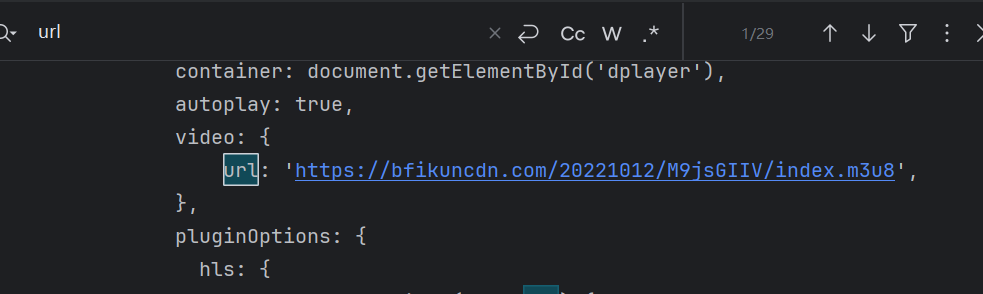
再利用正则表达式提取一下m3u8的地址:
python
obj=re.compile(r"url: '(?P<url>.*?)',",re.S) 得到m3u8的地址并打印:
python
m3u8_url=obj.search(resp.text).group("url")
print(m3u8_url) 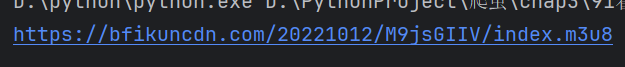
接下来把m3u8文件下载下来:
用resp2来接受一下m3u8的地址,并把resp2写入到test文件中:
python
resp2=requests.get(m3u8_url)

with open("test.m3u8","wb") as f:
    f.write(resp2.content)

resp2.close()
print('下载完毕')
然后将得到的这些m3u8进行解析:
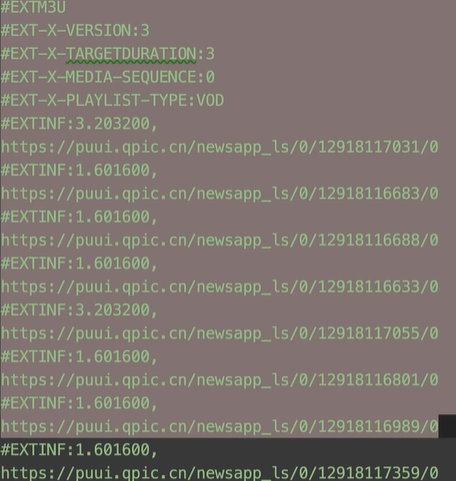
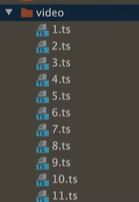
先将test文件打开读取里面的内容,在利用循环便利一下里面的内容,在利用strip()去除空白,判断是否有#,如果有就继续遍历,找到没有的写入到video中完成一个打印一个:
python
n=1
with open('test.m3u8','r',encoding='utf-8') as f:
    for line in f:
        line = line.strip()
        if line.startswith('#'):
            continue
        resp3=requests.get(line)
        f=open(f'video/{n}.ts','wb')
        f.write(resp3.content)
        f.close()
        resp3.close()
        n+=1
        print('完成一个')
最后在把视频片段合并在一起就ok了
完整代码:
python
import requests
import re

obj=re.compile(r"url: '(?P<url>.*?)',",re.S)  #用来提取m3u8的地址

url="https://www.xcyy44.com/play/16166_1.html"

resp=requests.get(url)
m3u8_url=obj.search(resp.text).group("url")  #拿到m3u8的地址
# print(resp.text)
# print(m3u8_url)
resp.close()

#下载m3u8文件
resp2=requests.get(m3u8_url)

with open("test.m3u8","wb") as f:
    f.write(resp2.content)

resp2.close()
print('下载完毕')
#
# #解析m3u8文件
n=1
with open('test.m3u8','r',encoding='utf-8') as f:
    for line in f:
        line = line.strip()   #去掉空白
        if line.startswith('#'):   #如果以#开头则会继续循环
            continue

        #下载视频片段
        resp3=requests.get(line)
        f=open(f'video/{n}.ts','wb')
        f.write(resp3.content)
        f.close()
        resp3.close()
        n+=1
        print('完成一个')