【本文首发于公众号:JavaArchJourney】
分布式锁是一种用于在分布式系统环境下,控制多个节点对共享资源访问的机制。它确保在任何时刻,只有一个客户端能够获取锁并对共享资源进行操作,避免并发操作带来的数据一致性问题。
并发控制场景:
-
单机同进程内的不同线程并发访问某项资源,可以使用各种互斥锁、读写锁;
-
一台主机上的多个进程需要并发访问某项资源,可以使用进程间同步的原语,例如信号量、管道、共享内存等。
-
多台主机需要同时访问某项资源,就需要使用一种在全局可见并具有互斥性的锁,这种锁就是分布式锁,可以在分布式场景中对资源加锁,避免竞争资源引起的逻辑错误。
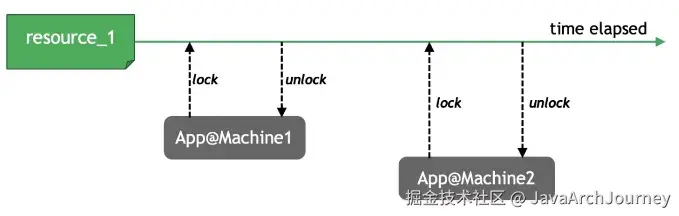
分布式锁的基础特性
分布式锁的一些特性:
-
互斥性 :任意时刻,只能有一个客户端获取到锁。
-
无死锁 :即使持有锁的客户端崩溃或网络故障,锁也应能被其他客户端获取,不应出现死锁情况。
-
容错性 :只要大多数的分布式系统节点是存活的,客户端就应该能够获取和释放锁。
-
高效的获取与释放锁 :获取和释放锁的操作需要尽可能高效。
-
可重入性 (根据业务需求):同一个客户端在持有锁的情况下,能够再次获取该锁而不被阻塞,通常用于支持一个线程或进程多次获取同一把锁以避免死锁的发生。通常可以通过客户端自我检查实现。
-
阻塞性(根据业务需求):当一个客户端尝试获取已被其他客户端持有的锁时,该客户端被挂起或不断重试,直到成功获取到锁或满足一定条件后才放弃尝试。通常可以通过客户端自旋等待实现。
分布式锁使用需求:
-
加锁、解锁(finally中)
-
避免死锁:超时自动释放
-
可重入(根据业务需求)
-
可续期(根据业务需求)
-
最好是阻塞锁(根据业务需求),一般是应用实现阻塞(限时自旋等)
分布式锁的实现方案
基于数据库
基于数据库实现分布式锁,通常由 2 种实现方式:
-
基于数据库唯一性约束
-
基于数据库排他锁
基于数据库唯一性约束
实现方式:
- 创建锁表 :首先需要在数据库中创建一个专门用于管理锁状态的表。这个表至少需要包含两个字段:一个是锁的标识符(
lock_key),另一个是锁的持有者信息(如客户端ID或时间戳等)。其中,lock_key需要设置为唯一索引,以确保在同一时刻只能有一个锁存在。
sql
CREATE TABLE distributed_locks (
    lock_key VARCHAR(255) PRIMARY KEY, -- 锁的标识符,作为主键保证唯一性
    client_id VARCHAR(255),            -- 客户端ID或其他相关信息
    lock_time TIMESTAMP DEFAULT CURRENT_TIMESTAMP, -- 获取锁的时间
); - 尝试获取锁 :当客户端想要获取锁时,可以尝试向
distributed_locks表中插入一条记录。这条记录包含了锁的标识符(即lock_key)和一些关于客户端的信息(例如client_id)。如果插入成功,则表示该客户端成功获得了锁;如果插入失败(通常是由于违反了唯一性约束),则表示锁已被其他客户端持有。
sql
INSERT INTO distributed_locks (lock_key, client_id)
VALUES ('my_unique_lock', 'client_01'); -
检查是否获得锁 :根据上一步的结果判断是否成功获取到了锁。如果插入操作返回成功,则说明当前客户端获得了锁;否则,需要决定是重试还是放弃。
-
释放锁:一旦工作完成,客户端需要删除对应的记录来释放锁。
sql
DELETE FROM distributed_locks WHERE lock_key = 'my_unique_lock' AND client_id = 'client_01'; 注意这里同时使用了lock_key和client_id来进行删除操作,这是为了防止锁被错误地释放(在高并发情况下可能出现的情况)。
方案问题:
- 死锁问题 :这种简单的实现没有自动过期机制,因此如果客户端崩溃而未能正确释放锁,则会导致死锁。
- 解决方案:可以通过在表中添加额外的时间戳字段,并定期清理长时间未释放的锁来缓解这个问题。
- 单点故障 :数据库本身成为系统的单点故障源。
- 解决方案:可以通过主从/主备复制+故障自动转移保障数据库高可用。
- 锁是非阻塞的 :因为数据的 insert 操作一旦失败就会直接报错,没有获得锁的线程并不会进入排队队列阻塞等待。
- 解决方案:可以考虑客户端设置一个 while 循环,直到 insert 成功再返回获取锁成功。
- 性能问题 :频繁的插入和删除操作会对数据库造成压力,尤其是在高并发场景下。
- 解决方案:可以考虑使用独立库部署、分布式数据库等增强性能,但是成本较高。
基于数据库排他锁
客户端通过执行带有SELECT ... FOR UPDATE行级排它锁的 SQL 查询来获取锁,这种查询会在选定的行上放置一个排他锁,阻止其他事务对该行进行更新或获取同样的锁,直到当前事务提交或回滚为止。这种方式依赖于数据库事务的 ACID 特性来保证锁的安全性和一致性。
实现方式:
-
获取锁 :客户端执行类似
SELECT * FROM locks WHER lock_name = 'my_lock' FOR UPDATE的查询。如果有对应的记录存在,则该查询会等待直到可以获取锁或者超时;如果没有对应的记录,则插入一条新记录以表示已获得锁。 -
释放锁:释放锁的操作通常是通过提交或回滚事务来间接完成的。当事务被提交或回滚(比如客户端宕机)后,排他锁会被释放,允许其他等待获取同一把锁的客户端继续执行。
方案问题:
-
性能问题:加排它锁过程会一直阻塞数据库,占用数据库连接池。
-
不同的数据库管理系统对锁的支持程度不同,可能会影响到锁的实现细节和性能表现。
基于 Redis 缓存
基于 Redis 实现分布式锁是一种高效且广泛采用的方法,尤其适用于高并发场景。
标准实现方式
实现方案:
- 获取锁 :使用
SET key value NX PX milliseconds命令。
-
NX保证只有当键不存在时才设置键。 -
PX指定键的过期时间(以毫秒为单位),从而避免死锁的发生。 -
示例:
SET my_lock_key unique_value NX PX 30000,这里的unique_value通常用于标识该锁属于哪个客户端。这个命令执行成功,则说明客户端获得了锁,并且锁将在30秒后自动释放。
- 释放锁 :
- Redis 删除 key 一般使用
DEL命令,但可能存在下列问题:
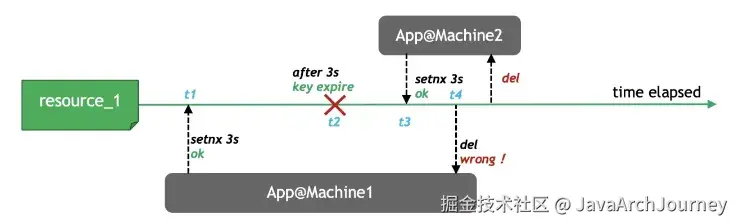 + t1 时刻,App1 设置了分布式锁
resource_1,过期时间为 3 秒。
-
App1 由于程序慢等原因等待超过了 3 秒,而
resource_1已经在 t2 时刻被释放。 -
t3 时刻,App2 获得这个分布式锁。
-
App1 从等待中恢复,在 t4 时刻运行
DEL resource_1将 App2 持有的分布式锁释放了。
- 从上述过程可以看出,一个客户端设置的锁,必须由自己解开。因此客户端需要先使用
GET命令确认锁是不是自己设置的,然后再使用DEL解锁。可以通过 Lua 脚本的原子性地完成这两个操作,以确保不会误删其他客户端持有的锁,实现自锁自解。
* 示例Lua脚本:
lua
if redis.call("GET", KEYS[1]) == ARGV[1] then
    return redis.call("DEL", KEYS[1])
else
    return 0
end - 锁的续租:
- 当客户端发现在锁的租期内无法完成操作时,就需要延长锁的持有时间,进行续租(renew)。同解锁一样,客户端应当只能续租自己持有的锁。在Redis中可使用如下Lua脚本来实现续租:
lua
if redis.call("GET", KEYS[1]) == ARGV[1] then
    return redis.call("EXPIRE", KEYS[1], ARGV[2])
else
    return 0
end
使用注意:
-
锁的有效期(TTL) :为了防止死锁,每个锁都有一个预设的有效期。这个有效期应该足够长以允许客户端完成其工作,但也不能太长以至于在客户端崩溃的情况下长时间阻止其他客户端获取锁。
-
错误处理:必须妥善处理各种异常情况,如网络分区、Redis 实例故障等,确保系统的健壮性和数据一致性。
基于 Redlock 算法
使用标准实现方式存在的问题:
-
单点故障问题 :传统的基于单一 Redis 实例的分布式锁方案存在单点故障的风险。因此通常需要集群部署和主从复制保障高可用。
-
网络分区和异步复制:在分布式环境中,网络分区是一个常见且不可避免的问题。同时,Redis通常使用异步复制来同步主从节点的数据,在某些极端情况下(例如主节点崩溃并进行故障转移时),可能会丢失数据。这对于需要强一致性的锁来说是个潜在的问题。根据 CAP 理论,在分布式系统中无法同时满足一致性(Consistency)、可用性(Availability)和分区容忍性(Partition tolerance),因此在设计分布式锁时,必须在可靠性与可用性之间做出权衡。
Redlock 算法是由 Redis 的作者 Antirez 提出的一种分布式锁算法,旨在解决在分布式系统中实现高可用和可靠的分布式锁这一挑战:
-
避免单点故障 :通过使用多个独立的 Redis 实例来存储锁的状态,即使其中一部分实例发生故障也不会影响整个系统的可用性。
-
提高锁的安全性 :考虑到异步复制可能带来的数据丢失风险,Redlock 算法不依赖于持久化机制,而是通过对多个 Redis 实例的操作来增加锁的安全性。
-
适应不同的网络条件:算法设计考虑到了网络延迟、分区等实际情况,提供了合理的时间窗口来确保即使在网络不稳定的情况下也能正确地获取或释放锁。
Redlock算法的基本思想是通过在多个独立的 Redis 实例上获取锁来避免单点故障,并确保在大多数实例成功获取锁的情况下才认为锁获取成功,从而提高系统的容错能力和锁的安全性。
算法实现步骤如下:
-
获取当前时间戳 :在尝试获取锁之前,客户端首先获取本地的当前时间戳(以毫秒为单位),作为开始时间。
-
向多个Redis实例请求锁 :客户端应该向 N 个独立运行且完全不相关的 Redis 实例同时发起锁请求,每个请求都使用
SET key value NX PX milliseconds命令来设置锁,并指定其自动过期时间(例如 30000 毫秒)。 -
计算成功获取锁所需的时间 :对于每个成功的响应(即锁被正确设置的情况),记录下获取锁所花费的时间。如果从第一个请求开始到最后一个响应为止的时间超过了锁的有效期(部分Redis实例上的锁已经过期而其他实例上的锁仍然有效,破坏了锁的一致性和正确性),则认为此次尝试失败,需要释放已获得的锁并重试。
-
检查是否成功获取锁 :如果客户端能够在大多数(超过半数)的 Redis 实例上成功设置了锁,并且总耗时小于锁的有效期,则认为成功获取了锁。这种多数派原则是为了提高系统的容错能力,即使部分 Redis 实例发生故障也不会影响整体功能。
-
处理业务逻辑 :一旦确认成功获取锁,客户端可以安全地执行需要保护的并发临界区代码。
-
释放锁:完成操作后,客户端需要遍历所有 Redis 实例并删除对应的锁( Lua 脚本实现自锁自解)。
实践示例:
Redisson 库实现了 Redlock 算法,我们可以直接使用:
pom.xml 添加依赖:
xml
<dependency>
  <groupId>org.redisson</groupId>
  <artifactId>redisson</artifactId>
  <version>3.17.6</version> <!-- 根据需要选择最新版本 -->
</dependency>
应用代码中使用:
java
import org.redisson.Redisson;
import org.redisson.api.RLock;
import org.redisson.api.RedissonClient;
import org.redisson.config.Config;

import java.util.Collections;

public class RedlockExample {

    public static void main(String[] args) throws InterruptedException {
        // 配置多个Redis节点地址
        Config config1 = new Config();
        config1.useSingleServer().setAddress("redis://127.0.0.1:6379");
        Config config2 = new Config();
        config2.useSingleServer().setAddress("redis://127.0.0.2:6380");
        Config config3 = new Config();
        config3.useSingleServer().setAddress("redis://127.0.0.3:6381");

        // 创建Redisson客户端实例
        RedissonClient redissonClient1 = Redisson.create(config1);
        RedissonClient redissonClient2 = Redisson.create(config2);
        RedissonClient redissonClient3 = Redisson.create(config3);

        // 使用Redisson的Redlock功能:
        // 同时在多个节点同时加锁,红锁在大部分节点上加锁成功就算成功
        RLock lock = redissonClient1.getRedLock(
            redissonClient1.getLock("myLock"),
            redissonClient2.getLock("myLock"),
            redissonClient3.getLock("myLock")
        );

        boolean isLocked = false;
        try {
            // 尝试获取锁:为加锁等待100秒时间,并设置锁的有效期为10秒
            isLocked = lock.tryLock(100, 10, TimeUnit.SECONDS);
            if (isLocked) {
                // 执行业务逻辑
                System.out.println("Lock acquired, executing business logic...");
            } else {
                System.out.println("Failed to acquire lock.");
            }
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
            System.err.println("Thread was interrupted while trying to acquire lock.");
        } finally {
            if (isLocked) {
                // 释放锁
                lock.unlock();
                System.out.println("Lock released.");
            }
            // 关闭Redisson客户端
            redissonClient1.shutdown();
            redissonClient2.shutdown();
            redissonClient3.shutdown();
        }
    }
}
总结:
基于 Redlock 算法实现分布式锁,提高了锁的可用性和可靠性,但同时也增加了实现的复杂度,因此主要适用于那些对锁正确性有较高要求的应用场景。
基于 Zookeeper
Apache Zookeeper 是一个分布式协调服务系统,支持强一致性和高可靠性(CAP 中的 CP)。
基于 ZooKeeper 实现分布式锁的核心思想是利用其 临时顺序节点 特性:
-
创建锁节点路径: 通常锁的路径是类似
/locks/my_lock的 znode 路径。每个客户端在该路径下创建自己的顺序临时节点,例如:/locks/my_lock/lock-0000000001、/locks/my_lock/lock-0000000002。 -
获取锁: 检查自己创建的节点是否是当前路径下的最小节点,如果是,则表示获取锁成功;如果不是,则监听比自己小一个序号的节点,等待其释放锁。这里通过顺序节点保证获取锁的顺序公平。
-
释放锁: 当前获得锁的客户端主动关闭锁或发生宕机,都会导致临时节点被删除,从而释放锁。然后下一个等待的客户端会收到 Watcher 通知,重新检查是否是最小节点并尝试获取锁。
实践示例:
可以基于 Apache Curator 框架实践,Curator 是 Apache 提供的一个 ZooKeeper 客户端封装库,简化了 ZooKeeper 的操作,推荐使用。Curator 提供的 InterProcessMutex 支持可重入。
pom.xml 引入依赖:
xml
<dependency>
    <groupId>org.apache.curator</groupId>
    <artifactId>curator-recipes</artifactId>
    <version>5.7.0</version>
</dependency>
实现分布式锁的代码示例:
java
import org.apache.curator.framework.CuratorFramework;
import org.apache.curator.framework.CuratorFrameworkFactory;
import org.apache.curator.framework.recipes.locks.InterProcessMutex;
import org.apache.curator.retry.ExponentialBackoffRetry;

public class ZKLockExample {

    public static void main(String[] args) throws Exception {
        // 创建 ZooKeeper 客户端连接
        CuratorFramework client = CuratorFrameworkFactory.newClient(
                "localhost:2181",
                new ExponentialBackoffRetry(1000, 3)
        );
        client.start();

        // 创建一个分布式锁,锁的路径为 /locks/my_lock
        final String lockPath = "/locks/my_lock";
        InterProcessMutex lock = new InterProcessMutex(client, lockPath);

        try {
            if (lock.acquire(10, TimeUnit.SECONDS)) {
                System.out.println("成功获取锁!");
                // 执行业务逻辑
                Thread.sleep(5000);
            } else {
                System.out.println("获取锁失败!");
            }
        } finally {
            lock.release(); // 释放锁
            System.out.println("锁已释放");
        }

        client.close();
    }
}
总结:
由于 Zookeeper 的设计初衷不是为了高吞吐量的锁操作,因此它的性能不如基于 Redis 的实现。主要适合于对锁的可靠性和一致性要求高、但并发量不高的场景。