大规模调用淘宝商品详情API是一个典型的分布式系统设计问题,其核心在于如何在一个充满限制(如平台流控)的环境中,安全、高效、稳定地获取数据。
下面这个表格梳理了构建这样一个分布式请求调度系统时,你需要关注的核心维度、关键挑战及对应的解决思路。
探讨如何在合规前提下实现高效、稳定、可扩展的 API 调用体系。
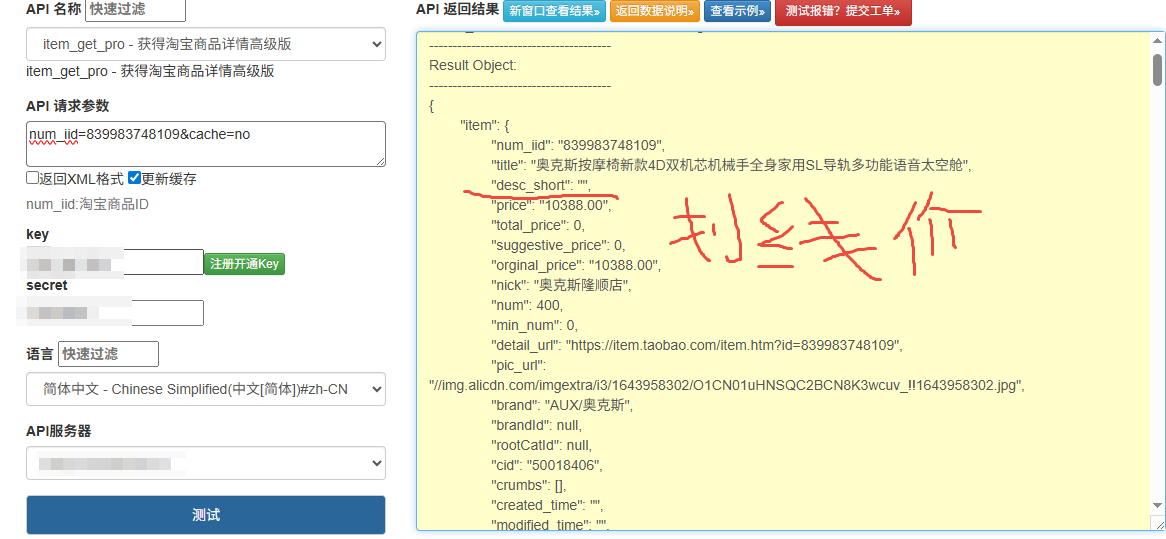
taobao.item_get_pro
公共参数
| 名称 | 类型 | 必须 | 描述 |
|---|---|---|---|
| key | String | 是 | 调用key(必须以GET方式拼接在URL中) |
| secret | String | 是 | 调用密钥 |
| api_name | String | 是 | API接口名称(包括在请求地址中)item_search,item_get,item_search_shop等 |
| cache | String | 否 | yes,no默认yes,将调用缓存的数据,速度比较快 |
| result_type | String | 否 | json,jsonu,xml,serialize,var_export返回数据格式,默认为json,jsonu输出的内容中文可以直接阅读 |
| lang | String | 否 | cn,en,ru翻译语言,默认cn简体中文 |
| version | String | 否 | API版本 |
请求参数
请求参数:num_iid=520813250866
参数说明:num_iid:淘宝商品ID
| 维度 | 核心挑战 | 实践方案与关键技术 |
|---|---|---|
| 🔑 资源调度 | 平台对AppKey和IP有严格的QPS与日调用量限制。 | • 资源池化:使用多个AppKey构成资源池,并配合IP代理池,避免单一资源触发限流。 • 全局限流:基于Redis等中间件实现令牌桶或漏桶算法,在系统入口进行全局速率控制。 |
| ⚙️ 任务管理 | 海量商品ID需要高效、不重复、不丢失地被处理。 | • 任务分片:将百万级商品ID拆分为小块(如每块1000-5000个ID),便于并行处理。 • 幂等性保障:通过Redis等记录已处理的商品ID,确保同一商品不会在短期内被重复抓取。 |
| 🚀 执行效率 | 单节点处理能力是瓶颈;网络IO和API超时影响整体速度。 | • 异步化与连接池:使用异步非阻塞IO(如NIO)并结合HTTP连接池,大幅提升单节点吞吐量。 • 本地缓存:对热点商品数据在Worker节点进行短期缓存,减少对API的重复调用。 |
| 🛡️ 容错与自愈 | 节点故障、网络抖动、API临时不可用等情况难以避免。 | • 故障转移:通过ZooKeeper或Consul进行心跳检测,故障节点的任务会自动重新调度。 • 重试机制:对网络超时等错误设计指数退避策略进行重试;对限流错误则立即上报,由调度层统一协调。 |
| 📊 监控预警 | 系统状态不透明,出现问题后无法快速发现和定位。 | • 多维指标:监控QPS、响应时间、成功率、节点负载等关键指标。 • 可视化与告警:使用Prometheus + Grafana搭建看板,并设置关键指标(如失败率>5%)的告警机制。 |
分布式系统中,任务重复执行可能导致 API 调用次数浪费(尤其对收费 API)。需通过双重机制确保幂等:
- 前置校验:Worker 节点获取任务后,先查询 Redis 的 "正在处理" 集合,若商品 ID 已存在则拒绝执行。
- 后置标记:调用成功后,立即将商品 ID 写入 "已处理" 集合(过期时间 24 小时),避免短期内重复调用。
💡 让系统更智能:进阶优化策略
在满足了上述基本要求后,以下几个进阶策略可以帮助你的系统运行得更加智能和稳健:
- 1. 动态限流适配 :淘宝平台的限流策略并非一成不变。更高级的做法是让系统能自适应调节 。可以通过实时解析API返回头中的
X-RateLimit-Remaining等字段,或在监控到限流错误率上升时,自动调低全局请求速率,实现动态限流。 - 2. 节点弹性伸缩:利用Kubernetes等容器编排技术,根据任务队列的积压情况自动增删Worker节点。例如,当积压任务超过阈值时自动扩容,在节点空闲一段时间后自动缩容,以优化资源利用成本。
- 3. 智能缓存策略 :实施多级缓存 策略。在分布式缓存(如Redis)之前,可以让Worker节点维护一层本地缓存,对极热点的商品数据进行短期缓存,可以进一步降低响应时间和中心缓存压力。
- 4. 优雅降级:在平台API出现不稳定或自身系统压力过大时,可以暂时降级为只获取最核心的商品字段(如标题、价格),舍弃次要信息,以保证核心链路的高成功率。
🚨 至关重要的合规底线
在追求技术极致的同时,绝对不能忽视合规风险。任何大规模调用都必须建立在遵守平台规则的前提下。
- 严守规则:务必通过官方开放的API进行数据获取,禁止使用任何形式的违规爬虫。
- 尊重数据:获取的数据用途必须严格遵守《淘宝开放平台服务协议》,不得用于恶意竞争或非法分发。
- 克制请求:避免对同一商品ID进行高频访问(例如,建议间隔不低于10分钟),以防被平台误判为攻击行为。
希望这份融合了核心架构与进阶实践指南能为你提供有力的支持。如果在具体的技术选型或实现细节上遇到更深入的问题,欢迎随时继续交流。