引言
本系列主要是对与 Cuda 入门官方课程的整理与小结。
在开始这门课程之前,已经有大概认知,通过 Cuda, 可以利用 GPU 来加速特定计算任务 。
本节课的主要目的 是了解 Cuda 程序的一些基础概念,以及如何编写第一个入门的 Cuda 程序
课程主页: https://www.olcf.ornl.gov/cuda-training-series/
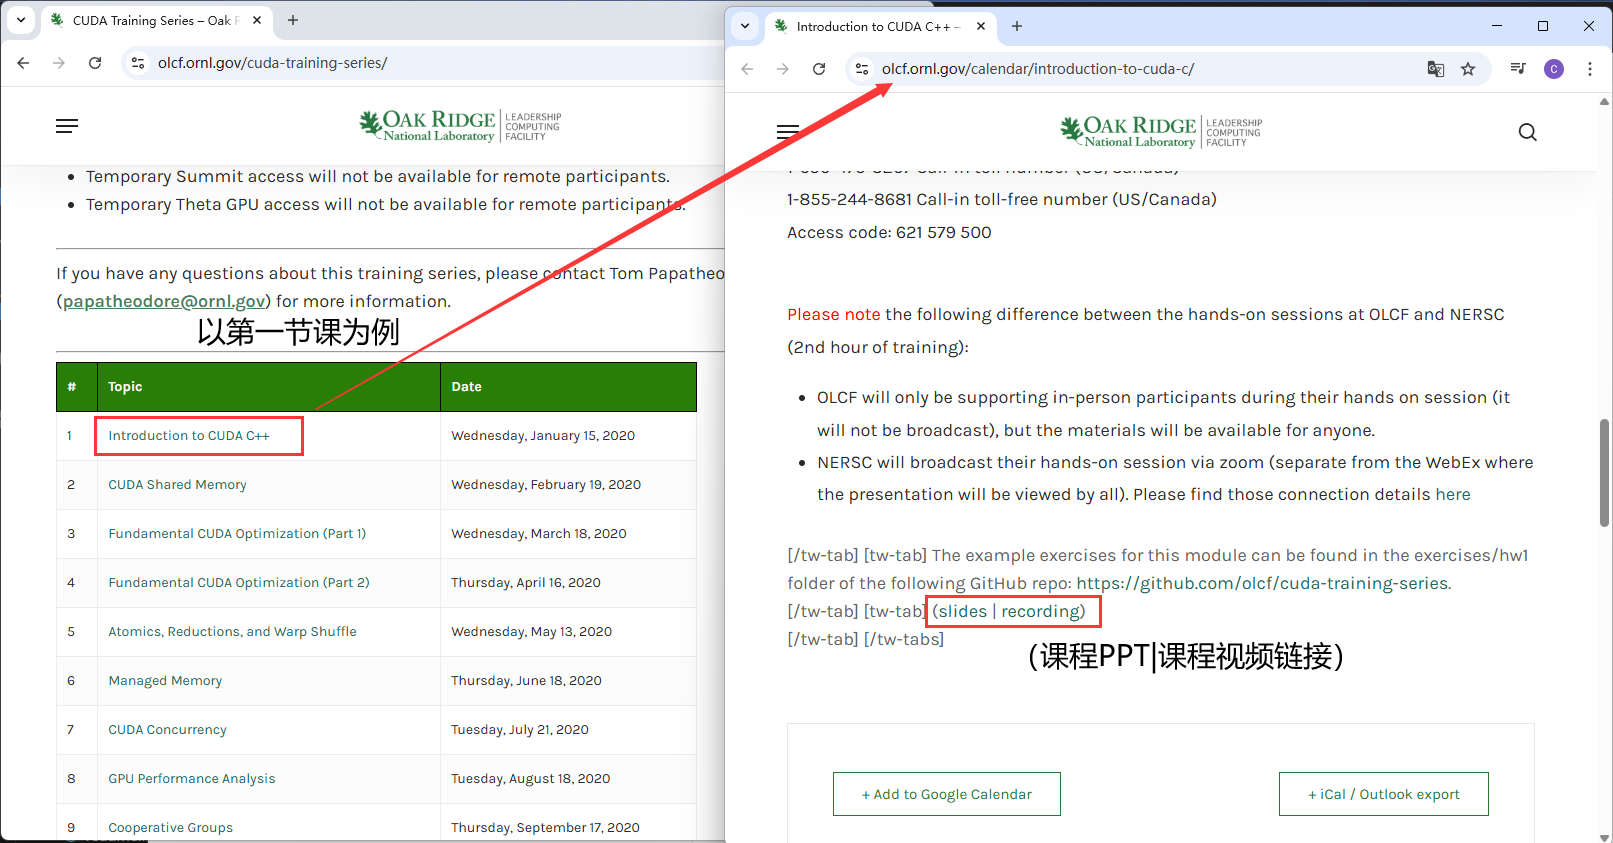
课程练习代码下载地址: https://github.com/olcf/cuda-training-series
Cuda API 文档: https://docs.nvidia.com/cuda/cuda-runtime-api/
1. CUDA 中的一些基础概念
1.1 Host and Device
Host: The CPU and its memory (host memory)
Device: The GPU and its memory (device memory)
(Cuda 提供的 API 会有与这两个概念相关联的一些接口)
1.2 GPU Kernels: DEVICE
(也就是常说的核函数)
(1)函数实现 在 GPU 上执行
(2)在 CPU 这边的代码发起调用
(3)函数以 关键字 "global" 进行修饰
如
__global__ void vecAdd(const float *A, const float *B, float *C, int vecDim)
{

    int idx = threadIdx.x + blockIdx.x * blockDim.x;
    if (idx < vecDim)
    {
        C[idx] = A[idx] + B[idx];
    }
}
4.CPU 这边会以如下格式发起调用
kernelFunc<<<1,1>>>(param1, param2,...);1.3 Grid, Block, Threads
基于 GPU 的架构设计, CUDA 这边设计出了 Thread, Block, Grid 概念(预告:后面还会有一个 Wrap 的概念)
1个 Grid 中可以有 M 个 Block, 1个 Block 中可以有 N个 Thread, 对应核函数的调用就是
kernelFunc<<<M,N>>>(param1, param2,...);通过 Cuda 的内置变量
blockIdx.x
threadIdx.x
可以在核函数中获取到某一个 block 中 某个 thread 的 id;
通过
blockDim.x可以知道 block 在 x 方向上的尺寸
继而在 blockDim.y block.Dim.z 皆为 1 的情况下,通过公式
int index = threadIdx.x + blockDim.x * blockIdx.x;可以在核函数中,计算出所有执行当前核函数的线程的id。
block 与 thread 的组成关系大致如下。

1.4 内存管理
cudaMalloc
功能:在设备(GPU)上分配内存。
(__host____device__)cudaError_t cudaMalloc ( void** devPtr, size_t size )参数:
devPtr:指向设备指针的指针,分配后指向设备内存。
size:要分配的字节数。
返回值:
cudaSuccess 表示成功,其他为错误码。
示例:
float* d_A = nullptr;
cudaMalloc((void**)&d_A, 100 * sizeof(float));
cudaFree
功能:释放设备(GPU)上分配的内存。
(__host____device__)cudaError_t cudaFree(void *devPtr);参数:
devPtr:要释放的设备内存指针。(注意, 这里和上面 Malloc 是不一样的)
返回值:
cudaSuccess 表示成功,其他为错误码。
示例:
cudaFree(d_A);cudaMemcpy
功能:在主机(CPU)和设备(GPU)之间或设备内部拷贝内存。
(__host__) cudaError_t cudaMemcpy ( void* dst, const void* src, size_t count, cudaMemcpyKind kind )参数:
dst:目标内存地址(主机或设备)。
src:源内存地址(主机或设备)。
count:拷贝的字节数。
kind::拷贝类型,常用有:
cudaMemcpyHostToDevice(主机到设备)cudaMemcpyDeviceToHost(设备到主机)cudaMemcpyDeviceToDevice(设备到设备)cudaMemcpyHostToHost(主机到主机)
2. 以 CUDA 实现 向量加法 为例进行介绍
基于上面的基础概念的介绍, 我们可以 初步拼凑出 Cuda实现向量加法程序
#include <stdio.h>
#include <stdlib.h>

#include "cuda_runtime.h"
#include "device_launch_parameters.h"

// error checking macro
#define cudaCheckErrors(msg)                                   \
    do                                                         \
    {                                                          \
        cudaError_t __err = cudaGetLastError();                \
        if (__err != cudaSuccess)                              \
        {                                                      \
            fprintf(stderr, "Fatal error: %s (%s at %s:%d)\n", \
                    msg, cudaGetErrorString(__err),            \
                    __FILE__, __LINE__);                       \
            fprintf(stderr, "*** FAILED - ABORTING\n");        \
            exit(1);                                           \
        }                                                      \
    } while (0)

const int DSIZE = 4096;
const int block_size = 256; // CUDA maximum is 1024
// -------- 向量加法的 kernel: C = A + B -------- //
__global__ void vecAdd(const float *A, const float *B, float *C, int ds)
{
    int idx = threadIdx.x + blockIdx.x * blockDim.x;
    if (idx < ds)
    {
        C[idx] = A[idx] + B[idx];
    }
}

int main()
{
    // 1.初始化 参与计算 与 获得结果 的向量
    float *h_A, *h_B, *h_C, *d_A, *d_B, *d_C;
    h_A = new float[DSIZE]; // allocate space for vectors in host memory
    h_B = new float[DSIZE];
    h_C = new float[DSIZE];
    for (int i = 0; i < DSIZE; i++)
    { // initialize vectors in host memory
        h_A[i] = rand() / (float)RAND_MAX;
        h_B[i] = rand() / (float)RAND_MAX;
        h_C[i] = 0;
    }
     // 2.为参与计算 与 获得结果 的向量 在 GPU Memory 上分配空间
    cudaMalloc((void**)&d_A, DSIZE * sizeof(float)); // allocate device space for vector A
    cudaMalloc((void**)&d_B, DSIZE * sizeof(float)); // allocate device space for vector B
    cudaMalloc((void**)&d_C, DSIZE * sizeof(float)); // allocate device space for vector C
    cudaCheckErrors("cudaMalloc failure");   // error checking

    // 3.将数据拷贝到 GPU 上
    cudaMemcpy(d_A, h_A, DSIZE * sizeof(float), cudaMemcpyHostToDevice);
    cudaMemcpy(d_B, h_B, DSIZE * sizeof(float), cudaMemcpyHostToDevice);
    cudaCheckErrors("cudaMemcpy H2D failure");

    // 4.调用核函数进行计算
    vecAdd<<<(DSIZE + block_size - 1) / block_size, block_size>>>(d_A, d_B, d_C, DSIZE);
    cudaCheckErrors("kernel launch failure");

    // 5.将计算结果从 GPU Memory 拷贝会 CPU 侧
    cudaMemcpy(h_C, d_C, DSIZE * sizeof(float), cudaMemcpyDeviceToHost);
    cudaCheckErrors("kernel execution failure or cudaMemcpy H2D failure");

    // 6.打印计算结果
    printf("A[0] = %f\n", h_A[0]);
    printf("B[0] = %f\n", h_B[0]);
    printf("C[0] = %f\n", h_C[0]);

    // 7. 释放 GPU Memory
    cudaFree(d_A);
    cudaFree(d_B);
    cudaFree(d_C);

    // 8. 释放 CPU 的 Memory
    delete[] h_A;
    delete[] h_B;
    delete[] h_C;
    return 0;
}
3.本节作业实现
本节的作业让我们尝试修改几行核函数的代码实现 矩阵乘法。 实现该完整程序之前还需了解一些前置概念
3.1 前置概念
前面介绍过的 核函数常用的调用形式如下,
kernelFunc<<<M,N>>>(param1, param2,...);<<<,>>> 中输入的是两个整型的变量
实际上, 这两个变量也可以传入cuda 定义的 类型 dim3, 如
dim3 block(4, 4); // dim3 variable holds 3 dimensions
dim3 grid(4, 4);
kernelFunc<<<grid,block>>>(param1, param2,...);
以达到将block 与 thread 以平面方式组织的效果。 此时在核函数中可通过如下方式来获取线程的id 的行号与列号。
int idx = threadIdx.x + blockIdx.x * blockDim.x;
int idy = threadIdx.y + blockIdx.y * blockDim.y;
3.2 练习实现 矩阵乘法
至此基于前置只是以及矩阵乘法, 可以得到下面计算矩阵乘法的例子
/**
 * 4096 x 4096 矩阵乘法的例子
 */
#include <stdio.h>
#include <stdlib.h>

#include "cuda_runtime.h"
#include "device_launch_parameters.h"

// these are just for timing measurments
#include <time.h>

// error checking macro
#define cudaCheckErrors(msg)                             \
  do                                                     \
  {                                                      \
    cudaError_t __err = cudaGetLastError();              \
    if (__err != cudaSuccess)                            \
    {                                                    \
      fprintf(stderr, "Fatal error: %s (%s at %s:%d)\n", \
              msg, cudaGetErrorString(__err),            \
              __FILE__, __LINE__);                       \
      fprintf(stderr, "*** FAILED - ABORTING\n");        \
      exit(1);                                           \
    }                                                    \
  } while (0)

const int DSIZE = 4096;
const int block_size = 16; // CUDA maximum is 1024 *total* threads in block
const float A_val = 1.0f;
const float B_val = 2.0f;

// matrix multiply (naive) kernel: C = A * B
__global__ void mmul(const float *A, const float *B, float *C, int ds)
{

  int idx = threadIdx.x + blockDim.x * blockIdx.x; // create thread x index
  int idy = threadIdx.y + blockDim.y * blockIdx.y; // create thread y index

  if ((idx < ds) && (idy < ds))
  {
    float temp = 0;
    for (int i = 0; i < ds; i++)
    {
        temp += A[idy * ds + i] * B[i * ds + idx]; // dot product of row and column
    }
    C[idy * ds + idx] = temp;
  }
}

int main()
{

  float *h_A, *h_B, *h_C, *d_A, *d_B, *d_C;

  // these are just for timing
  clock_t t0, t1, t2;
  double t1sum = 0.0;
  double t2sum = 0.0;

  // start timing
  t0 = clock();

  h_A = new float[DSIZE * DSIZE];
  h_B = new float[DSIZE * DSIZE];
  h_C = new float[DSIZE * DSIZE];
  for (int i = 0; i < DSIZE * DSIZE; i++)
  {
    h_A[i] = A_val;
    h_B[i] = B_val;
    h_C[i] = 0;
  }

  // Initialization timing
  t1 = clock();
  t1sum = ((double)(t1 - t0)) / CLOCKS_PER_SEC;
  printf("Init took %f seconds.  Begin compute\n", t1sum);

  // Allocate device memory and copy input data over to GPU
  cudaMalloc(&d_A, DSIZE * DSIZE * sizeof(float));
  cudaMalloc(&d_B, DSIZE * DSIZE * sizeof(float));
  cudaMalloc(&d_C, DSIZE * DSIZE * sizeof(float));
  cudaCheckErrors("cudaMalloc failure");

  cudaMemcpy(d_A, h_A, DSIZE * DSIZE * sizeof(float), cudaMemcpyHostToDevice);
  cudaMemcpy(d_B, h_B, DSIZE * DSIZE * sizeof(float), cudaMemcpyHostToDevice);
  cudaCheckErrors("cudaMemcpy H2D failure");
  // Cuda processing sequence step 1 is complete

  // Launch kernel
  dim3 block(block_size, block_size); // dim3 variable holds 3 dimensions
  dim3 grid((DSIZE + block.x - 1) / block.x, (DSIZE + block.y - 1) / block.y);
  mmul<<<grid, block>>>(d_A, d_B, d_C, DSIZE);
  cudaCheckErrors("kernel launch failure");

  // Cuda processing sequence step 2 is complete

  // Copy results back to host
  cudaMemcpy(h_C, d_C, DSIZE * DSIZE * sizeof(float), cudaMemcpyDeviceToHost);

  // GPU timing
  t2 = clock();
  t2sum = ((double)(t2 - t1)) / CLOCKS_PER_SEC;
  printf("Done. Compute took %f seconds\n", t2sum);

  // Cuda processing sequence step 3 is complete

  // Verify results
  cudaCheckErrors("kernel execution failure or cudaMemcpy H2D failure");
  for (int i = 0; i < DSIZE * DSIZE; i++)
    if (h_C[i] != A_val * B_val * DSIZE)
    {
      printf("mismatch at index %d, was: %f, should be: %f\n", i, h_C[i], A_val * B_val * DSIZE);
      return -1;
    }
  printf("Success!\n");

  // free device memory
  cudaFree(d_A);
  cudaFree(d_B);
  cudaFree(d_C);

  // free host memory
  delete[] h_A;
  delete[] h_B;
  delete[] h_C;
  return 0;
}