python爬取pdf文件并保存至本地

问题描述 :python爬取pdf文件并保存至本地,目标网址下有一系列pdf 文件,其中"1.pdf "为想要保存的pdf文件,并且想要保存的pdf是多个pdf,pdf的文件名随着网址中的"1.pdf "变化而变化,规律是依次增加,比如"1.pdf "、"2.pdf "、"3.pdf "...,现在想要通过循环改变网址来保存这些pdf。

python 复制代码
# -*- coding: utf-8 -*-
"""
@author: cattt3
"""

import requests
from bs4 import BeautifulSoup

# 目标网址
url = "http://xxx.cn/Course/TeachingCourse/PsychStats/"

# 循环从1开始,直到找不到PDF文件
i = 1
while True:
    # 构建完整的PDF文件名
    pdf_filename = f"{i}.pdf"

    # 构建完整的PDF URL
    pdf_url = url + pdf_filename

    # 发送HTTP请求
    response = requests.get(pdf_url)

    # 如果请求成功,保存PDF文件
    if response.status_code == 200:
        with open(pdf_filename, "wb") as f:
            f.write(response.content)
        print(f"已保存 {pdf_filename}")
    else:
        # 如果请求失败,停止循环
        break

    # 增加文件名计数器
    i += 1

保存成功:
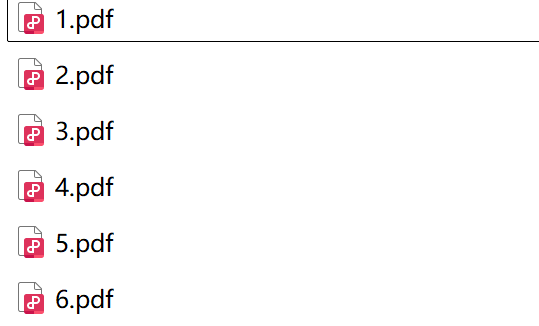
相关推荐
happylifetree3 小时前
Python70:核心语法-函数进阶-案例2
python
王中阳Go4 小时前
两个入口答案不一致先别调模型:6 行入口口径对账表(附脚本)
人工智能·后端·python·大语言模型·1024程序员节
BK贝壳4 小时前
bool-hybrid-array 落盘我只认 .bha:用 Create_BHA / Ask_BHA 做布尔数组序列化
数据结构·python·numpy·1024程序员节
Sakura_j_h_5 小时前
Python 在定时任务里输出 emoji,UnicodeEncodeError 从哪来
开发语言·字符编码·windows·python·定时任务
supabc1236 小时前
欧盟电子发票(XRechnung/Peppol/ZUGFeRD)踩坑记:用 Python 不装 Java 跑官方校验规则
xml·python·开源·电子发票·1024程序员节
ZhengEnCi6 小时前
AI Agent工具调用防护层怎么写-一份能直接跑的Python四层拦截实现
python·llm·agent
ZhengEnCi7 小时前
AI Agent工具误调用怎么解决-从参数校验到高危二次确认的四层工程防线
python·llm·agent
镜子AI8 小时前
镜子AI工程教程:用Python实现关键词布局检查器与语义改写查重(附完整代码)
人工智能·python·microsoft
小oo呆9 小时前
【学习心得】Python协程
python
信誓旦旦的程序猿9 小时前
【Python量化实战宝典 #22】涨跌停、连板情绪手册:情绪指标构建(Python 可跑)
python·1024程序员节·股票数据api·股票数据api接口·股票api数据接口·股票量化数据api·股票量化数据接口