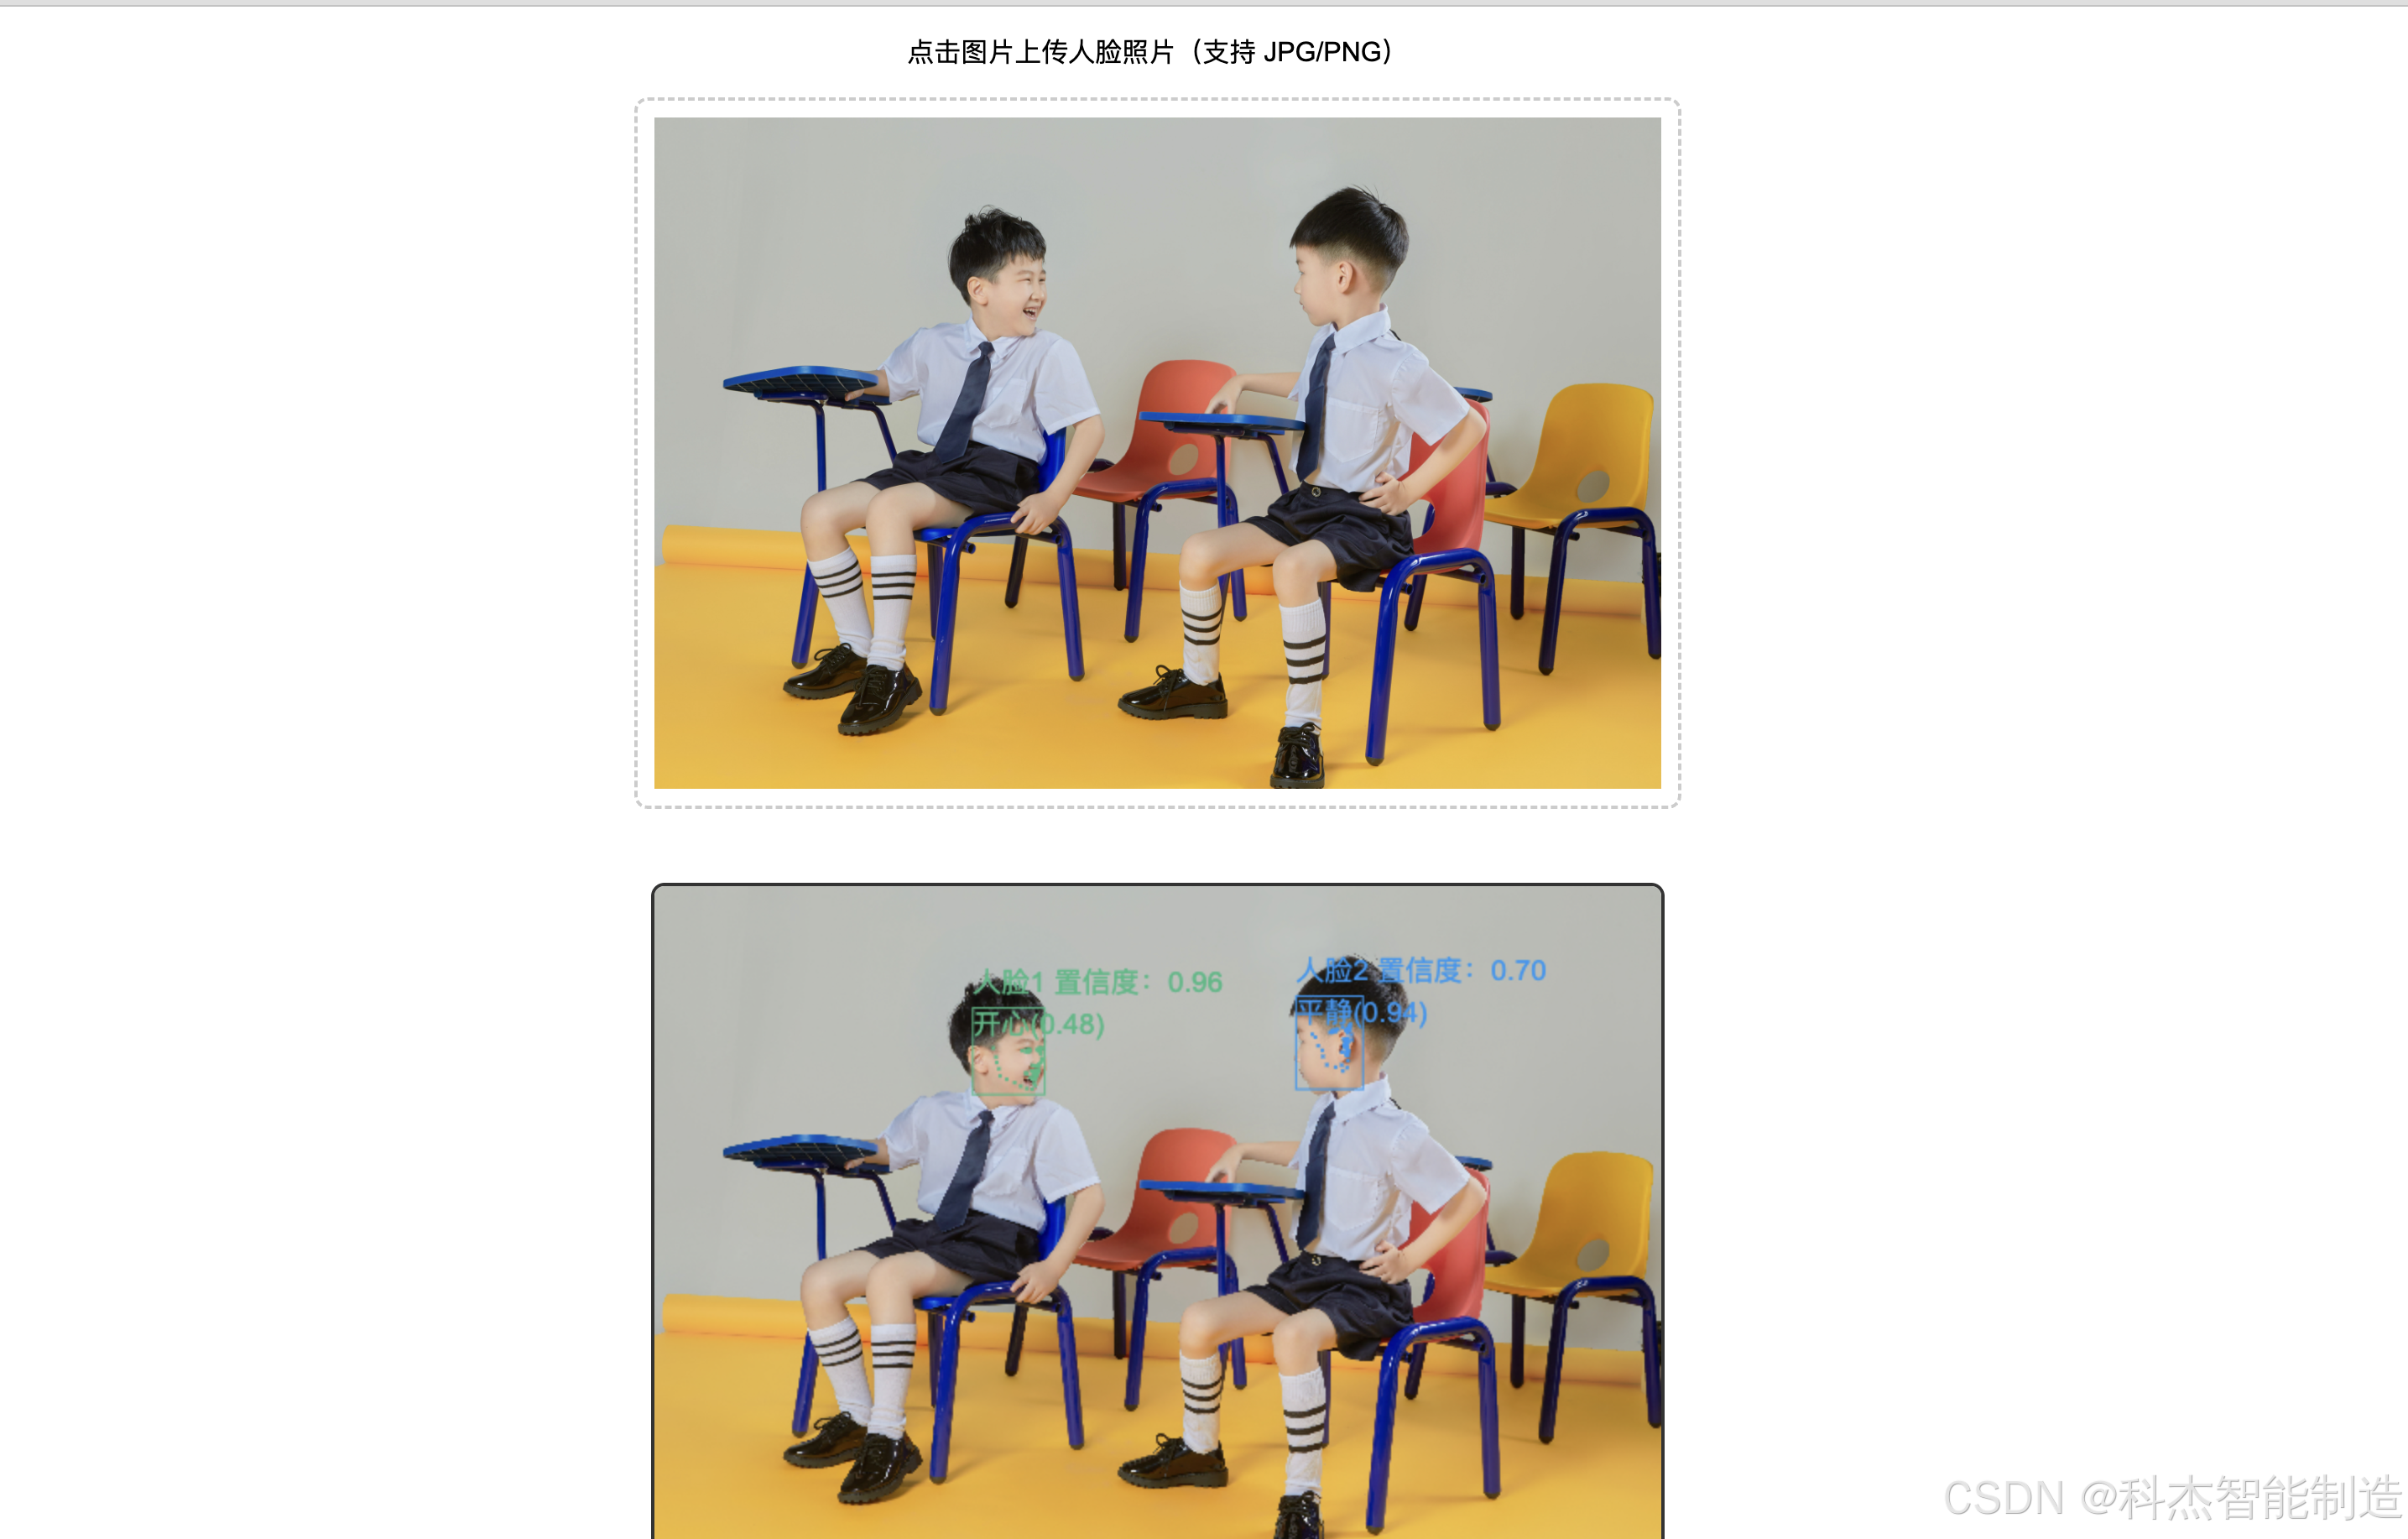
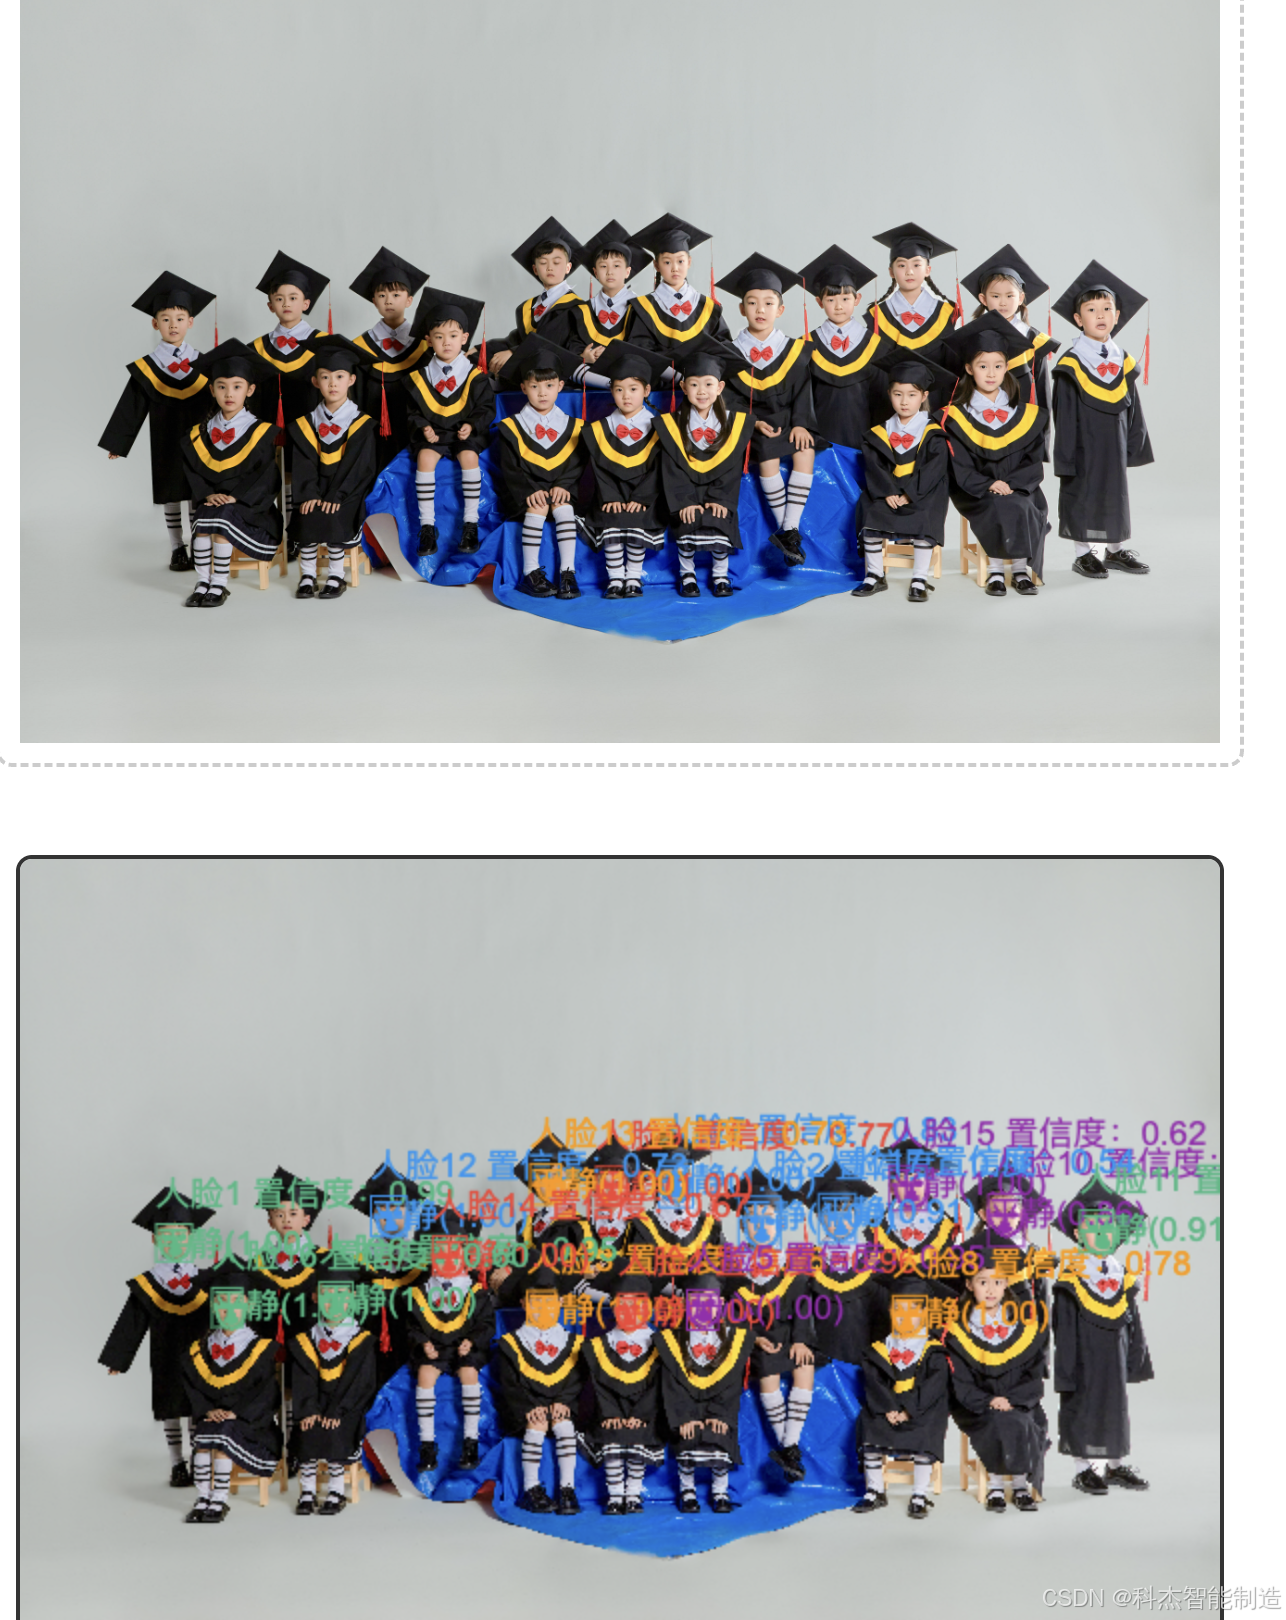
前端代码
javascript
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>简单图片人脸识别</title>
  <style>
    /* 简单样式:居中布局 + 边框提示 */
    body {
      display: flex;
      flex-direction: column;
      align-items: center;
      padding: 20px;
      font-family: Arial, sans-serif;
    }
    .container {
      margin: 20px 0;
      text-align: center;
    }
    #inputImage {
      max-width: 600px;
      border: 2px dashed #ccc;
      border-radius: 8px;
      padding: 10px;
      cursor: pointer;
      /* 限制图片最大高度,避免Canvas超出屏幕 */
      max-height: 400px;
      object-fit: contain;
    }
    #resultCanvas {
      margin-top: 20px;
      border: 2px solid #333;
      border-radius: 8px;
      /* 默认隐藏,识别后再显示 */
      display: none;
    }
    button {
      padding: 10px 20px;
      background: #42b983;
      color: white;
      border: none;
      border-radius: 4px;
      cursor: pointer;
      font-size: 16px;
      margin-top: 10px;
    }
    button:disabled {
      background: #ccc;
      cursor: not-allowed;
    }
  </style>
</head>
<body>
<h1>图片人脸识别演示</h1>

<!-- 选择图片区域 -->
<div class="container">
  <p>点击图片上传人脸照片(支持 JPG/PNG)</p>
  <input type="file" id="fileInput" accept="image/jpeg,image/png" style="display: none;">
  <img id="inputImage" src="https://via.placeholder.com/600x400?text=点击上传图片" alt="上传图片" onclick="document.getElementById('fileInput').click()">
</div>

<!-- 识别结果展示(Canvas 用于画框标注) -->
<canvas id="resultCanvas"></canvas>

<!-- 识别按钮 -->
<button id="detectBtn" disabled>开始识别</button>

<!-- 引入 faceapi 核心库(关键!) -->
<script src="./dist/face-api.min.js"></script>
<script>
  // 全局变量:存储模型加载状态、图片元素
  let modelLoaded = false;
  const inputImage = document.getElementById('inputImage');
  const fileInput = document.getElementById('fileInput');
  const detectBtn = document.getElementById('detectBtn');
  const resultCanvas = document.getElementById('resultCanvas');
  const ctx = resultCanvas.getContext('2d');
  // 存储已加载完成的图片对象(确保绘制时图片已就绪)
  let loadedImage = null;

  // 页面加载完成后,加载人脸模型(核心步骤)
  window.onload = async () => {
    try {
      // 注意:你的模型路径是 ./weights(不是默认的 ./models),确保 weights 文件夹存在且完整!
      await faceapi.loadSsdMobilenetv1Model('./weights'); // 人脸检测模型
      await faceapi.loadFaceLandmarkModel('./weights'); // 人脸特征点模型
      await faceapi.loadFaceRecognitionModel('./weights'); // 人脸识别模型
      await faceapi.loadFaceExpressionModel('./weights'); // 表情识别模型
      modelLoaded = true;
      alert('模型加载成功!请上传图片并点击识别');
    } catch (err) {
      console.error('模型加载失败:', err);
      alert('模型加载失败,请检查 weights 文件夹路径是否正确,或文件夹是否完整');
    }
  };

  // 监听图片上传,预览图片(关键优化:确保图片完全加载后再启用按钮)
  fileInput.addEventListener('change', (e) => {
    const file = e.target.files[0];
    if (!file) return;

    // 读取图片并显示在预览区
    const reader = new FileReader();
    reader.onload = (event) => {
      // 新建 Image 对象,监听 onload 事件(确保图片完全加载)
      const img = new Image();
      img.onload = () => {
        // 图片加载完成后,更新预览图和存储的图片对象
        inputImage.src = img.src;
        loadedImage = img; // 存储完整加载的图片,用于后续绘制
        // 清空之前的识别结果和 Canvas
        ctx.clearRect(0, 0, resultCanvas.width, resultCanvas.height);
        resultCanvas.style.display = 'none'; // 隐藏 Canvas,识别后再显示
        // 启用识别按钮
        detectBtn.disabled = !modelLoaded;
      };
      // 处理跨域问题(避免绘制时出现污染 Canvas 错误)
      img.crossOrigin = 'anonymous';
      img.src = event.target.result;
    };
    reader.readAsDataURL(file);
  });

  // 在 detections.forEach 循环外,定义中文映射表
  const expressionMap = {
    happy: '开心',
    sad: '难过',
    angry: '生气',
    neutral: '平静',
    surprised: '惊讶',
    fearful: '恐惧',
    disgusted: '厌恶'
  };

  // 点击识别按钮,执行人脸识别(新增表情识别逻辑)
  detectBtn.addEventListener('click', async () => {
    if (!loadedImage) {
      alert('请先上传图片并等待预览加载完成');
      return;
    }

    // 设置 Canvas 尺寸、绘制原图
    const imgWidth = loadedImage.width;
    const imgHeight = loadedImage.height;
    const maxCanvasWidth = 600;
    const scale = imgWidth > maxCanvasWidth ? maxCanvasWidth / imgWidth : 1;
    const canvasWidth = imgWidth * scale;
    const canvasHeight = imgHeight * scale;

    resultCanvas.width = canvasWidth;
    resultCanvas.height = canvasHeight;
    resultCanvas.style.display = 'block';
    ctx.clearRect(0, 0, canvasWidth, canvasHeight);
    ctx.drawImage(loadedImage, 0, 0, canvasWidth, canvasHeight);

    // .withFaceExpressions() 获取表情数据
    const options = new faceapi.SsdMobilenetv1Options({ minConfidence: 0.5 });
    const detections = await faceapi.detectAllFaces(loadedImage, options)
      .withFaceLandmarks() // 特征点(保留)
      .withFaceDescriptors() // 描述符(保留)
      .withFaceExpressions(); // 获取表情数据(关键)

    if (detections.length === 0) {
      alert('未检测到人脸');
      return;
    }

    // 循环标注每个人脸(新增表情标签绘制)
    detections.forEach((detectResult, index) => {
      const { detection, landmarks, descriptor, expressions } = detectResult; // 解构 expressions
      const { x, y, width, height } = detection.box;

      // (原有代码:计算缩放坐标、画人脸框、特征点,保留不变)
      const scaledX = x * scale;
      const scaledY = y * scale;
      const scaledWidth = width * scale;
      const scaledHeight = height * scale;

      const colors = ['#42b983', '#2196f3', '#ff9800', '#f44336', '#9c27b0'];
      const faceColor = colors[index % colors.length];

      ctx.strokeStyle = faceColor;
      ctx.lineWidth = 1;
      ctx.strokeRect(scaledX, scaledY, scaledWidth, scaledHeight);

      ctx.fillStyle = faceColor;
      const scalePoints = (points) => points.map(p => ({ x: p.x * scale, y: p.y * scale }));
      scalePoints(landmarks.getMouth()).forEach(point => ctx.fillRect(point.x, point.y, 2, 2));
      scalePoints(landmarks.getLeftEye()).forEach(point => ctx.fillRect(point.x, point.y, 2, 2));
      scalePoints(landmarks.getRightEye()).forEach(point => ctx.fillRect(point.x, point.y, 2, 2));
      scalePoints(landmarks.getNose()).forEach(point => ctx.fillRect(point.x, point.y, 2, 2));
      scalePoints(landmarks.getJawOutline()).forEach(point => ctx.fillRect(point.x, point.y, 2, 2));

      // 解析表情结果(取概率最高的表情)
      // expressions 包含:happy(开心)、sad(难过)、angry(生气)、neutral(中性)、surprised(惊讶)、fearful(恐惧)、disgusted(厌恶)
      const expression = expressions.asSortedArray()[0]; // 按概率排序,取第一个(最可能的表情)
      // 解析表情时替换为中文
      const expressionName = expressionMap[expression.expression] || expression.expression; // 表情名称(如 'happy')
      const expressionConfidence = expression.probability; // 表情置信度(0-1)

      // 绘制表情标签(在人脸框下方/上方,和编号、置信度错开)
      ctx.fillStyle = faceColor;
      ctx.font = '17px Arial';
      // 人脸编号+置信度
      const faceText = `人脸${index + 1} 置信度:${detection.score.toFixed(2)}`;
      const faceTextY = scaledY - 10 > 0 ? scaledY - 10 : scaledY + scaledHeight + 20;
      ctx.fillText(faceText, scaledX, faceTextY);

      // 表情标签(换行显示,避免重叠)
      const expressionText = `${expressionName}(${expressionConfidence.toFixed(2)})`;
      const expressionTextY = faceTextY + 25; // 向下偏移 25px(字体高度+间距)
      ctx.fillText(expressionText, scaledX, expressionTextY);

      // 打印表情结果到控制台(可选)
      console.log(`人脸${index + 1} 表情:`, expressionName, ' 置信度:', expressionConfidence);
    });

    // 包含表情识别结果
    alert(`识别成功!共检测到 ${detections.length} 个人脸,已标注表情和特征点`);
  });
</script>
</body>
</html>