import streamlit as st

from dataclasses import dataclass
from langchain.agents import create_agent
from langchain_core.documents import Document
from langgraph.checkpoint.memory import InMemorySaver
from langchain_ollama import ChatOllama, OllamaEmbeddings
from langchain_core.vectorstores import InMemoryVectorStore
from langchain.agents.middleware import dynamic_prompt, ModelRequest


# 定义上下文模式
@dataclass
class Context:
    """自定义运行时上下文模式。"""
    user_id: str


# 设置记忆
if "checkpointer" not in st.session_state:
    checkpointer = InMemorySaver()
    st.session_state['checkpointer'] = checkpointer

checkpointer = st.session_state['checkpointer']

# 聊天模型
if "model" not in st.session_state:
    model = ChatOllama(
        model="deepseek-r1:1.5b",
        base_url='http://localhost:11434',
        temperature=0.2,
        timeout=10,
        max_tokens=1000
    )
    st.session_state['model'] = model

model = st.session_state['model']

# 嵌入模型
if "embeddings" not in st.session_state:
    embeddings = OllamaEmbeddings(
        model="llama3.2:1b",
        base_url='http://localhost:11434',
    )
    st.session_state['embeddings'] = embeddings

embeddings = st.session_state['embeddings']

# 向量存储
if "vector_store" not in st.session_state:
    # 这里为了简单,使用内存向量存储
    vector_store = InMemoryVectorStore(embedding=embeddings)
    st.session_state['vector_store'] = vector_store
    # 初始化你的知识信息 rag 关键点之一
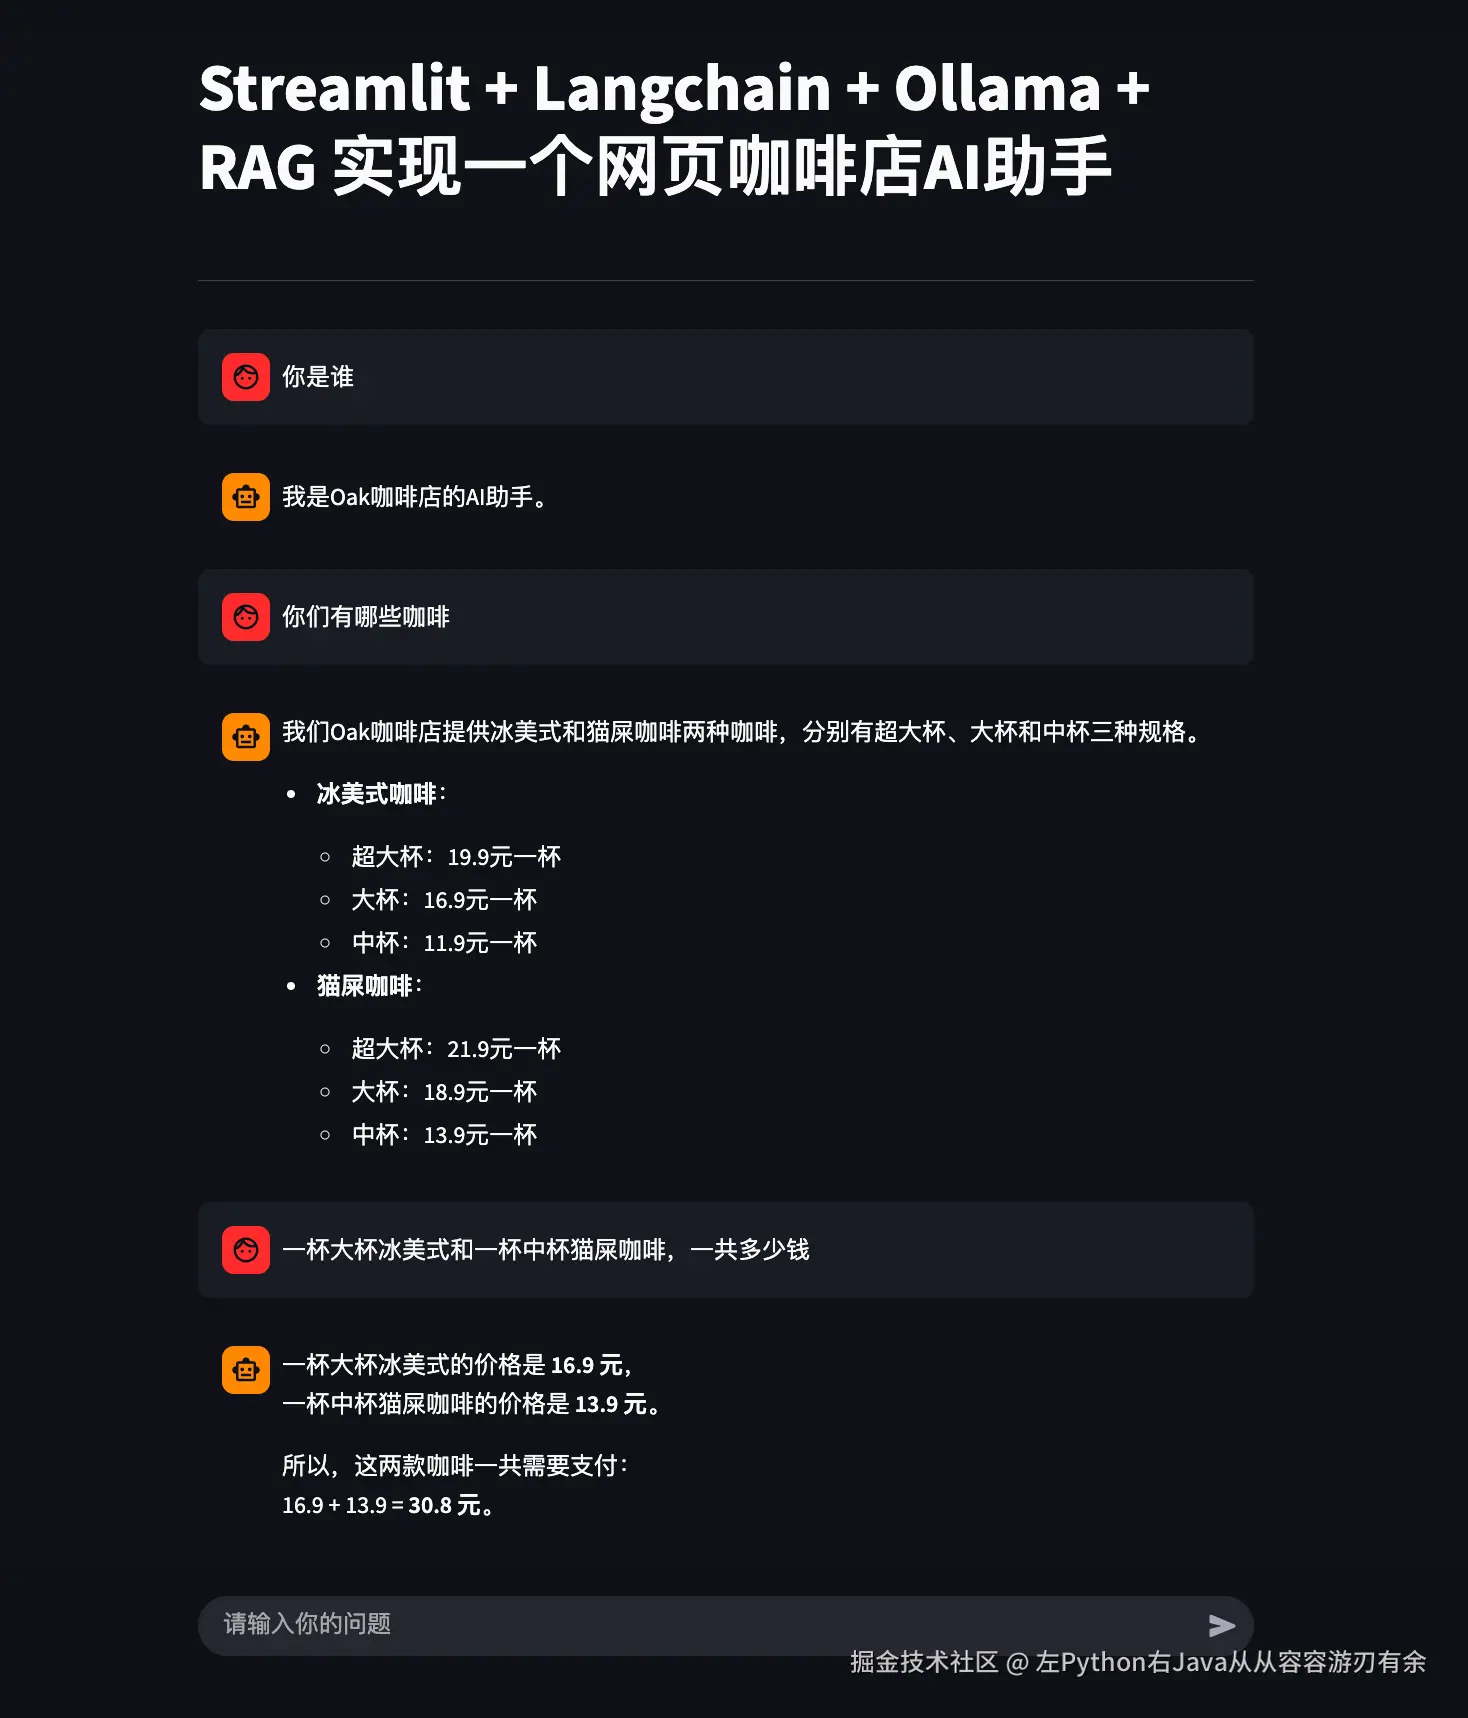
    documents = [Document(page_content="问题:你是谁?回答:我是Oak咖啡店AI助手。", id ="doc1"),
                 Document(page_content="问题:你们Oak咖啡店提供什么咖啡?回答:我们Oak咖啡店提供冰美式和猫屎咖啡两种咖啡,分超大杯、大杯和中杯三种规格", id ="doc2"),
                 Document(page_content="问题:冰美式有哪几种规格?回答:我们的咖啡分超大杯、大杯和中杯三种规格。", id ="doc3" ),
                 Document(page_content="问题:冰美式多少钱一杯?回答:我们的冰美式咖啡超大杯19.9元一杯;大杯16.9元一杯;中杯11.9元一杯。", id ="doc4"),
                 Document(page_content="问题:猫屎咖啡有哪几种规格?回答:我们的猫屎咖啡分超大杯、大杯和中杯三种规格。", id ="doc5"),
                 Document(page_content="问题:猫屎咖啡多少钱一杯?回答:我们的猫屎咖啡超大杯21.9元一杯;大杯18.9元一杯;中杯13.9元一杯。" , id ="doc6")
                 ]

    vector_store.add_documents(documents=documents)

# 向量存储
vector_store = st.session_state['vector_store']
# similar_docs = vector_store.similarity_search('user', 2)
# for doc in similar_docs:
#     print(doc)

# 存储聊天信息
if "messages" not in st.session_state:
    st.session_state['messages'] = []


# similar_docs = vector_store.similarity_search('user', 2)
# for doc in similar_docs:
#     print(doc)

# 动态提示词 RAG 实现关键点之一
@dynamic_prompt
def prompt_with_context(request: ModelRequest) -> str:
    """Inject context into state messages."""
    last_query = request.state["messages"][-1].text
    print(f"客户提问:{last_query}")

    # RAG 实现关键点之一 讲向量检索的内容追加到系统提示词 system_message 中
    retrieved_docs = vector_store.similarity_search(last_query)
    docs_content = "\n\n".join(doc.page_content for doc in retrieved_docs)
    system_message = (
        "你是Oak咖啡店AI助手. 基于下面的上下文回答用户提问:"
        f"\n\n{docs_content}"
    )
    print(system_message)
    return system_message


if "agent" not in st.session_state:
    # 创建代理
    agent = create_agent(
        model=model,
        system_prompt="""
        你是Oak咖啡店AI助手,提供Oak咖啡店咨询服务,请用友好的语气和客户沟通。
        """,
        tools=[],
        context_schema=Context,
        checkpointer=checkpointer,
        middleware=[prompt_with_context],
    )
    st.session_state["agent"] = agent

agent = st.session_state["agent"]

# 运行代理
# `thread_id` 是给定对话的唯一标识符。
config = {"configurable": {"thread_id": "1"}}

# 标题
st.title("Streamlit + Langchain + Ollama + RAG 实现一个网页咖啡店AI助手")

# 分隔符
st.divider()

# 输入问题
prompt = st.chat_input("请输入你的问题")

if prompt:
    # role : user 、 assistant  ai human
    st.session_state['messages'].append({'role': 'user', 'content': prompt})
    for message in st.session_state['messages']:
        st.chat_message(message['role']).markdown(message['content'])

    with st.spinner("🤔思考中。。。。"):
        response = agent.invoke(
            {"messages": [{"role": "user", "content": prompt}]},
            config=config,
            context=Context(user_id="1")
        )
        # print(response)
        st.session_state['messages'].append({'role': 'assistant', 'content': response['messages'][-1].content})
        st.chat_message('assistant').markdown(response['messages'][-1].content)