各种attention的变体:MHA,GQA,MQA,MLA(DeepSeek-V2)详解

参考文章:DeepSeek-V2:

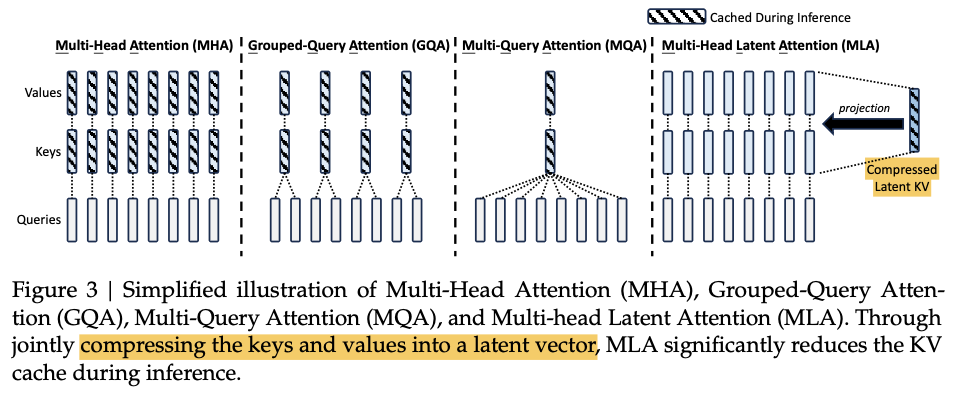
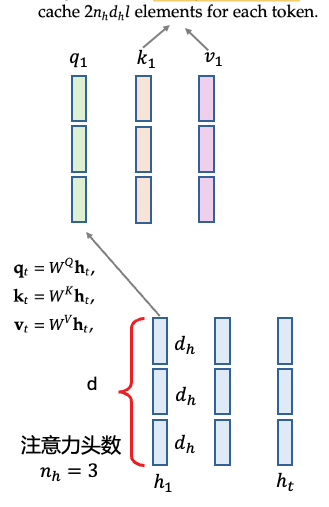
Multi-Head Attention (MHA)示意图:
Grouped-Query Attention (GQA)
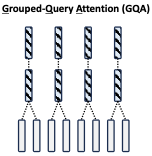
减小KV head的数量,多个Query head共用一个KV head

Multi-Query Attention (MQA)
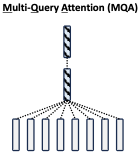
只有一个KV head,多个Query head共用一个KVhead

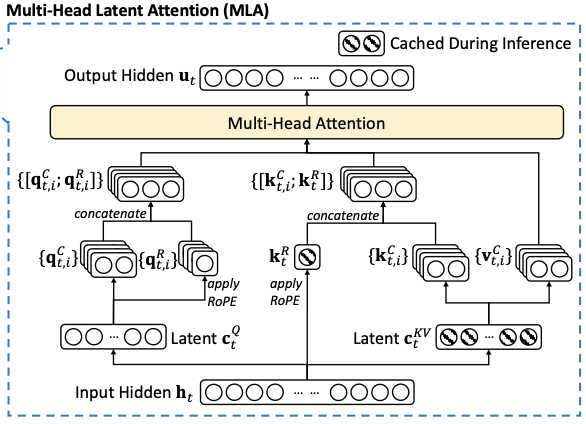
Multi-head Latent Attention(MLA)示意图:

MLA在DeepSeek-V2论文中被提出,

在生成QKV时,先将向量都down projection到低维度。

对于KV head部分,都由一个共用的低维度向量表示来up pojection出来多个head

在推理时,KV cache只用保存这个低维度的向量,在计算时由up projection还原到多个head的高维空间,这样做的好处是减小了KV cache
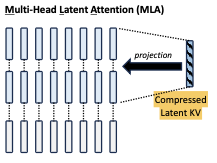
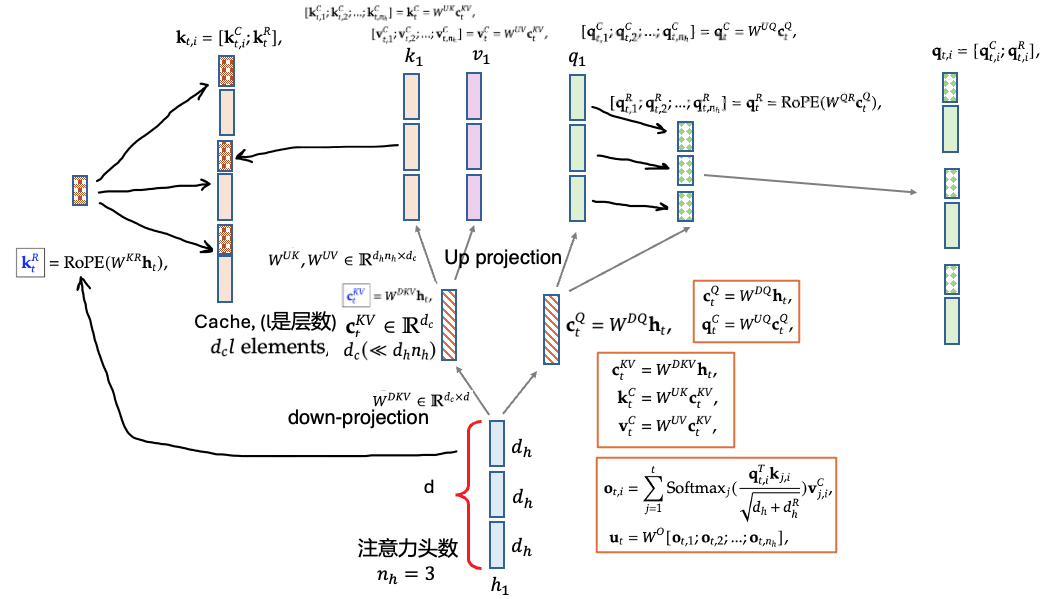
原论文中画的MLA的示意图:

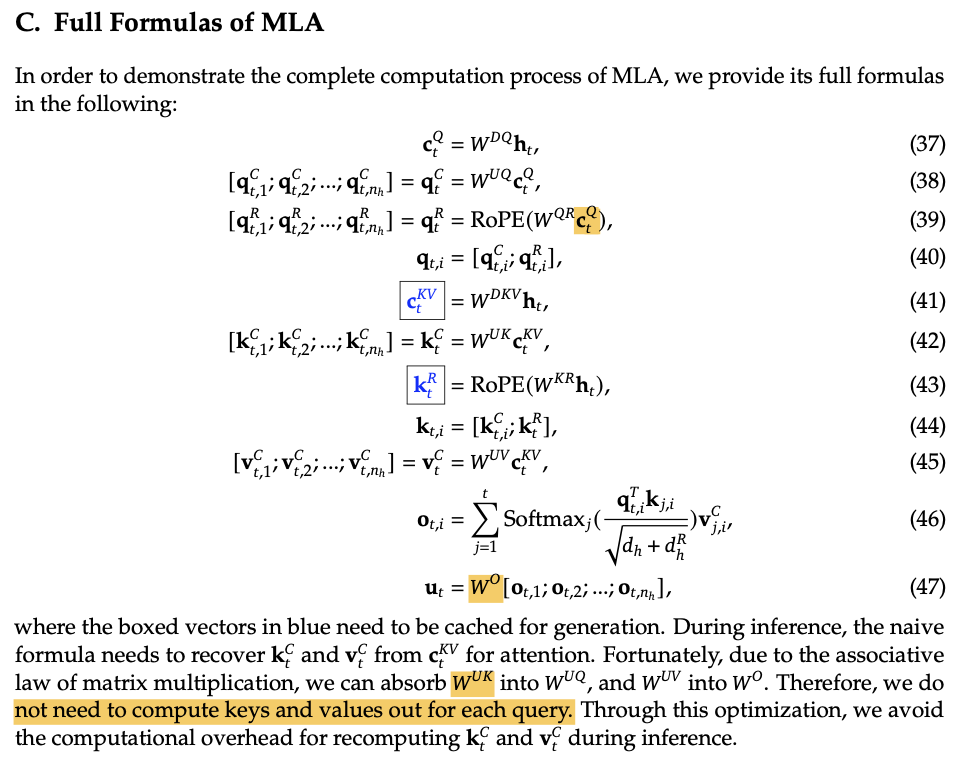
具体计算方式:

其中的W^UK可以和W^UQ合并,W^UV和W^O可以合并
相关推荐
愤怒的代码几秒前
什么是Paged Attention?
人工智能·agent
樱木花道長8 分钟前
AMD Ross 深度系列 7:六组对照实验看Ross如何赋能AI完成Vivado 硬核IP配置
人工智能·fpga开发
OpenVINO 中文社区9 分钟前
英特尔 × ADG:从 Agent 落地到 3DGS 重建,GDPS 2026 空间计算实战工作坊技术复盘
人工智能·3d·空间计算
W***259213 分钟前
视频怎么单独提取声音:全设备通用操作指南与后续创作全流程
人工智能
龙孚信息15 分钟前
一座塔,与三十年的文件夹
人工智能
LV技术派15 分钟前
【成为 AI Native Builder · 01】开篇:为什么 AI 总在返工?
人工智能·程序员·ai编程
QuZhengRong20 分钟前
【AI】大模型推理中 KV Cache 原理解析
人工智能·大模型·agent·提示词·推理
论文复现现场25 分钟前
2026 低成本 AI Agent 模型怎么选?DeepSeek V4.1 Flash、Qwen3.8 Flash、GLM-5.3 Flash 对比
数据库·人工智能·qwen·ai agent·glm·deepseek
SEO_juper26 分钟前
Go 站点地图生成器:从首页爬全站,一键生成 sitemap.xml
xml·开发语言·人工智能·golang·node.js·seo·外贸独立站
长弓三石27 分钟前
Spring Boot 4.1 + AgentScope:企业级 Agent 平台的 MCP 双向集成实战
人工智能·spring boot·后端·harness·开源智能体