SHAP值的解读
SHAP 在机器学习中的应用
开店=机器学习
合伙人 = 特征
总收入 = 预测值 - 基准值
每人贡献 = 每个特征的 SHAP 值
基准值(Base Value):模型在所有样本上的平均预测值
三人合伙前,收入是 0,三人合伙后,收入是 100万,要分配的"蛋糕"就是 100万-0=100 万
基准值 = 没有任何特征信息时的"默认"预测(相当于"0"的起点),这个值一般就是平均值,把训练集的所有样本都输入模型,得到所有预测值取平均值,在没有关于这个特定样本的区分性信息时,最合理的猜测就是平均值
预测值 = 加入所有特征后的预测(相当于"100 万"的终点)
要分配的"蛋糕"=预测值 -基准值
核心公式:
模型预测值 = 基准值+SHAP(特征 1)+SHAP(特征 2)+..+SHAP(特征 N)
SHAP 值加起来 =预测值与基准值的差!
那么如何实现 shaply 值动态变化呢?上面说的是平均这一家店是一个样本,对于多家店每个店都是样本,所以特征贡献不同那么对于一个样本,如果控制变量计算特征贡献呢?真实在做的时候肯定是没法实现控制其他特征不动,检测单个特征的贡献,其实还是多样本比对了,shap 值本质上也是一个近似值。
虽然不完美,但 SHAP 是目前理论最完善、应用最广泛的解释方法。
SHAP 值的计算用训练还是测试集?
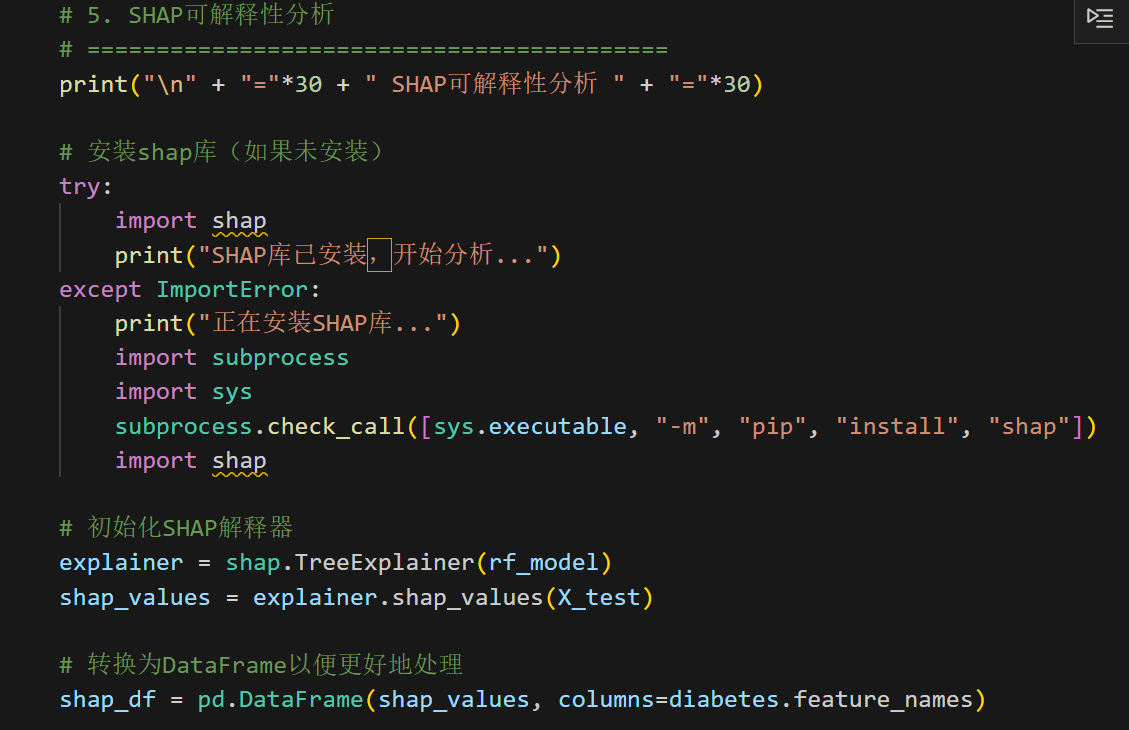
先说结论,两者均可,但是为了图好看一般都是选择训练集。
- 做机器学习的专业大多都是交叉学科,本身你的研究多是针对私有数据集,不会关注你的泛化性。所以不必因为这个纠结。
- shap 值是每个样本的每个特征都会得到对应类别的值,所以如果你的数据量本身就不大,用训练集来绘制,点多会让图美观很多,或者也可以对测试集插值也可以起到一样的效果
- 补充一个 shap图美观的小技巧,可以绘制出每一个类别 shap 曲线的置信区间,因为机器学习多是点估计,而区间估计会让你的结果更加具有信服力,利用bootstrap 重采样思想可以绘制出置信区间,自己写一下 shap 图函数,不用借助 shap 库的接口。