本文是 refine-rag 系列教程的第一篇,带你体验一下 RAG 的简单流程。 本文所有代码都在:github.com/zonezoen/re...
前言
在学习 RAG 之前,我们先来对比一下 RAG 和 AI Agent 的概念,只有先了解这些概念,才能继续往前推进。
什么是RAG
简单来说就是允许你查阅书本,再来回答问题。
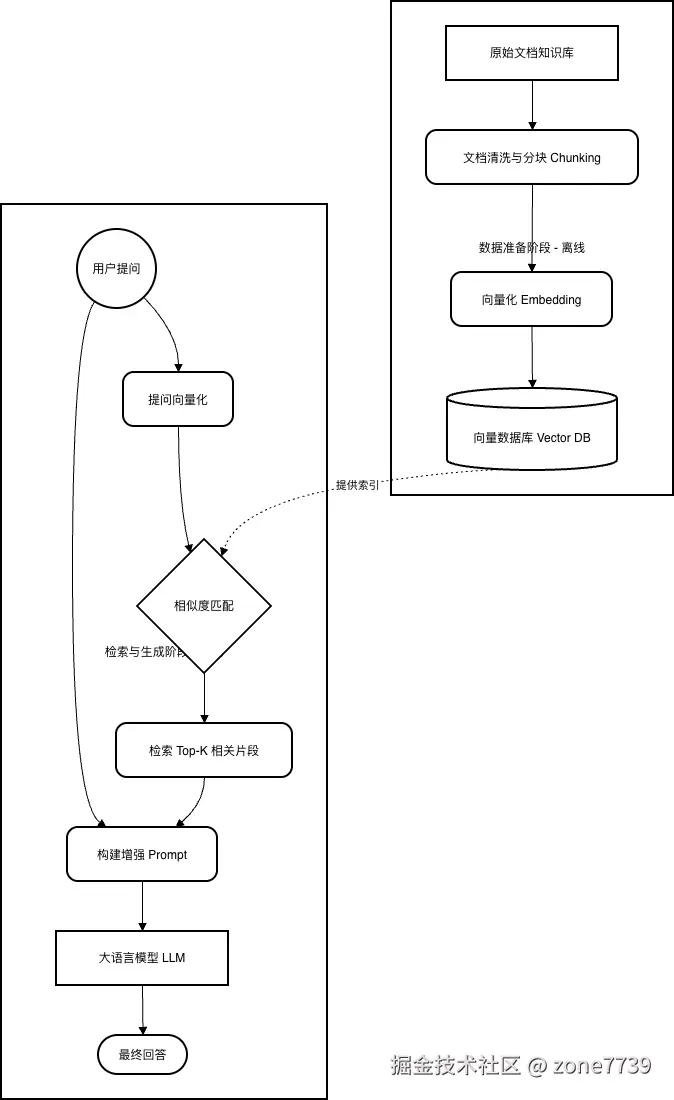
标准一点来说(也是简化过的):
- 整理原始文档,比如:pdf、word、excel、ppt 等
- 把整理好的文档内容进行清洗、切块
- 把切块好的数据向量化,并存储到向量数据库中
- 用户问一个问题
- 把这个问题的字符串向量化
- 然后根据【问题向量】去向量数据库查找相似的知识点
- 把查到的知识和问题一起传递给大模型
- 大模型根据查到的知识点来回答问题 当然了,这个流程也是简化过的,不过不用在意,这个只是便于你理解这个概念。
还有你需要知道的是:RAG 可以解决一些时效性的问题和幻觉问题。相比 Fing-turning 微调,RAG 更节省成本,而且数据可以溯源,可以知道相关的知识点源自哪个文档。
或许看这个流程图或许会更直观一点
什么是AI Agent
如果把 RAG 比作是查知识库,那么 AI Agent 就是可以执行具体任务的助手。主要包括这几个特点:
- 规划:规划步骤,比如说买机票可以先查日期,再查天气,然后买机票
- 记忆:可以记住聊天上下文
- 工具使用:可以决定使用查天气的 API 还是执行一段 Python 代码
- 执行:规划好之后,可以执行具体的任务,并根据结果来执行下一步任务
主流RAG框架
目前主流的 RAG 框架有 LlamaIndex、langchain、Dify 等,我这边选择前面两个来做个示例:
大模型也分别选了 千问和 DeepSeek 来做展示:
环境准备
1. Python 环境要求
- Python 3.8 或更高版本(推荐 3.10+)
- 建议使用虚拟环境
2. 安装依赖包
LlamaIndex 示例所需依赖:
bash
pip install llama-index
pip install llama-index-llms-dashscope
pip install llama-index-embeddings-dashscope
pip install dashscope
pip install python-dotenv
LangChain 示例所需依赖:
bash
pip install langchain
pip install langchain-community
pip install langchain-huggingface
pip install langchain-deepseek
pip install langchain-text-splitters
pip install python-dotenv
pip install sentence-transformers  # HuggingFace embeddings 依赖
一键安装所有依赖:
bash
pip install llama-index llama-index-llms-dashscope llama-index-embeddings-dashscope \
            dashscope langchain langchain-community langchain-huggingface \
            langchain-deepseek langchain-text-splitters python-dotenv sentence-transformers
3. API Key 配置
本文所有代码都在:github.com/zonezoen/re... 创建 .env 文件,放到项目根目录:
ini
# DeepSeek API 配置
DEEPSEEK_API_KEY=sk-xxx
# 千问
DASHSCOPE_API_KEY=sk-yyy
如何获取 API Key:
- DeepSeek: platform.deepseek.com/
- 千问(DashScope): dashscope.aliyun.com/
LlamaIndex 示例(千问)
文件名: 01_LlamaIndex.py
python
import os
from llama_index.llms.dashscope import DashScope, DashScopeGenerationModels
from llama_index.embeddings.dashscope import DashScopeEmbedding
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader, Settings

from dotenv import load_dotenv

os.environ['USER_AGENT'] = 'my-rag-app/1.0'
load_dotenv()
DATA_DIR = "./data"

# 1. 配置 LLM
Settings.llm = DashScope(
    model_name=DashScopeGenerationModels.QWEN_MAX,
    api_key=os.getenv("DASHSCOPE_API_KEY")
)

# 2. 设置嵌入模型
Settings.embed_model = DashScopeEmbedding(
    model_name='text-embedding-v2',
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    timeout=60,  # 增加超时时间
    max_retries=5  # 增加重试次数
)

# 3. 加载与索引
if not os.path.exists(DATA_DIR):
    print(f"错误:未找到路径 {DATA_DIR}")
else:
    # 建议直接使用绝对路径,避免相对路径带来的困扰
    print("正在加载文档...")
    documents = SimpleDirectoryReader(DATA_DIR).load_data()

    print("正在创建索引(此步涉及 Embedding 接口调用)...")
    index = VectorStoreIndex.from_documents(documents)

    # 4. 查询
    query_engine = index.as_query_engine()

    print("正在提问...")
    response = query_engine.query("2026春运时间是什么时候?")
    print(f"AI 回答结果:\n{response}")
运行方式:
bash
python 01_LlamaIndex.py运行结果:
erlang
正在加载文档...
正在创建索引(此步涉及 Embedding 接口调用)...
正在提问...
AI 回答结果:
2026年春运的时间是从2月2日至3月13日。
LangChain 示例(DeepSeek)
文件名: 02_LangChain_DeepSeek.py
python
import os
from dotenv import load_dotenv

os.environ['USER_AGENT'] = 'my-rag-app/1.0'
load_dotenv()

# 1. 加载数据
from langchain_community.document_loaders import TextLoader

# 随便复制一些即时新闻放到 txt 文件中,例如:https://baike.baidu.com/item/2026%E5%B9%B4%E6%98%A5%E8%BF%90/66941026?fromModule=home_hotspot
loader = TextLoader(
    file_path="data/a.txt",
    encoding="utf-8"  # 如果是中文文件,确保使用 utf-8 编码
)

docs = loader.load()

# 2. 文档分块
from langchain_text_splitters import RecursiveCharacterTextSplitter

text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
all_splits = text_splitter.split_documents(docs)

# 3. 设置嵌入模型
# 使用本地 HuggingFace 模型(推荐,免费且稳定),可能需要科学网络
from langchain_huggingface import HuggingFaceEmbeddings

embeddings = HuggingFaceEmbeddings(
    model_name="BAAI/bge-small-zh-v1.5",  # 中文模型
    model_kwargs={'device': 'cpu'},
    encode_kwargs={'normalize_embeddings': True}
)

# 4. 存到向量数据库中,为了方便测试,这里使用内存数据库
from langchain_core.vectorstores import InMemoryVectorStore

vector_store = InMemoryVectorStore(embeddings)
vector_store.add_documents(all_splits)

# 5. 构建用户查询,针对前面的即时新闻提问
question = "2026春运时间是什么时候?"

# 6. 在向量数据库中搜索最相似的文档
retrived_docs = vector_store.similarity_search(question, k=3)
docs_content = "\n\n".join(doc.page_content for doc in retrived_docs)

# 7. 构建提示模板
from langchain_core.prompts import ChatPromptTemplate

prompt = ChatPromptTemplate.from_template(
    """
    基于以下上下文回答问题。如果没有结果,就说没有找到对应信息。
                上下文: {context}
                问题: {question}
                回答:
    """
)

# 8. 把结果和问题都发给大模型,生成答案
from langchain_deepseek import ChatDeepSeek

llm = ChatDeepSeek(
    model="deepseek-chat",  # DeepSeek API 支持的模型名称
    temperature=0.7,  # 随机性
    max_tokens=2048,  # 最大输出长度
    api_key=os.getenv("DEEPSEEK_API_KEY")  # 从环境变量加载API key
)

answer = llm.invoke(prompt.format(question=question, context=docs_content))
print(answer.content)  # 只打印回答内容
运行方式:
bash
python 02_LangChain_DeepSeek.py运行结果:
yaml
2026年春运时间为2026年2月2日至2026年3月13日。学习路径
- 简易RAG 学习
- LCEL 语法学习
- LangChain 读取数据
- LangChain 读取文本数据
- LangChain 读取图片数据
- LangChain 读取 PDF 数据
- LangChain 读取表格数据
- 文本切块
- 向量嵌入
- 向量存储
- 检索前处理
- 索引优化
- 检索后处理
- 响应生成
- 系统评估
项目地址
本文所有代码示例都在 GitHub 开源:
欢迎 Star 和 Fork,一起学习 RAG 技术!