python
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import warnings
import time
import os
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score, classification_report, confusion_matrix
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset
from sklearn.preprocessing import StandardScaler

warnings.filterwarnings("ignore")

# 设置中文字体
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

# 检查GPU是否可用
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print(f"Using device: {device}")

# 读取数据
data = pd.read_csv('E:\PyStudy\data.csv')

# 预处理代码(保持不变)
discrete_features = data.select_dtypes(include=['object']).columns.tolist()

# Home Ownership 标签编码
home_ownership_mapping = {
    'Own Home': 1,
    'Rent': 2,
    'Have Mortgage': 3,
    'Home Mortgage': 4
}
data['Home Ownership'] = data['Home Ownership'].map(home_ownership_mapping)

# Years in current job 标签编码
years_in_job_mapping = {
    '< 1 year': 1,
    '1 year': 2,
    '2 years': 3,
    '3 years': 4,
    '4 years': 5,
    '5 years': 6,
    '6 years': 7,
    '7 years': 8,
    '8 years': 9,
    '9 years': 10,
    '10+ years': 11
}
data['Years in current job'] = data['Years in current job'].map(years_in_job_mapping)

# Purpose 独热编码
data = pd.get_dummies(data, columns=['Purpose'])
data2 = pd.read_csv("data.csv")
list_final = []
for i in data.columns:
    if i not in data2.columns:
        list_final.append(i)
for i in list_final:
    data[i] = data[i].astype(int)

# Term 0 - 1 映射
term_mapping = {
    'Short Term': 0,
    'Long Term': 1
}
data['Term'] = data['Term'].map(term_mapping)
data.rename(columns={'Term': 'Long Term'}, inplace=True)

# 连续特征用中位数补全
continuous_features = data.select_dtypes(include=['int64', 'float64']).columns.tolist()
for feature in continuous_features:
    mode_value = data[feature].mode()[0]
    data[feature].fillna(mode_value, inplace=True)

# 划分数据集
X = data.drop(['Credit Default'], axis=1)
y = data['Credit Default']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 数据标准化(对神经网络很重要)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 转换为PyTorch张量并移动到GPU
X_train_tensor = torch.FloatTensor(X_train_scaled).to(device)
y_train_tensor = torch.LongTensor(y_train.values).to(device)
X_test_tensor = torch.FloatTensor(X_test_scaled).to(device)
y_test_tensor = torch.LongTensor(y_test.values).to(device)

# 创建数据集和数据加载器(可选)
train_dataset = TensorDataset(X_train_tensor, y_train_tensor)
train_loader = DataLoader(train_dataset, batch_size=64, shuffle=True)

input_size = X_train_scaled.shape[1]

class MLP(nn.Module):
    def __init__(self, input_dim, hidden_dim=128, output_dim=2):  # 二分类输出2
        super(MLP, self).__init__()

        # 动态设置输入维度
        self.fc1 = nn.Linear(input_dim, hidden_dim)  # 输入层到隐藏层
        self.bn1 = nn.BatchNorm1d(hidden_dim)  # 批归一化
        self.relu = nn.ReLU()
        self.dropout = nn.Dropout(0.3)  # Dropout防止过拟合

        self.fc2 = nn.Linear(hidden_dim, hidden_dim // 2)
        self.bn2 = nn.BatchNorm1d(hidden_dim // 2)

        self.fc3 = nn.Linear(hidden_dim // 2, hidden_dim // 4)

        self.fc4 = nn.Linear(hidden_dim // 4, output_dim)  # 输出层

    def forward(self, x):
        out = self.fc1(x)
        out = self.bn1(out)
        out = self.relu(out)
        out = self.dropout(out)

        out = self.fc2(out)
        out = self.bn2(out)
        out = self.relu(out)
        out = self.dropout(out)

        out = self.fc3(out)
        out = self.relu(out)

        out = self.fc4(out)
        return out

# 定义早停类
class EarlyStopping:
    def __init__(self, patience=10, min_delta=0, save_path='best_model.pth'):
        """
        Args:
            patience: 容忍多少个epoch没有改善
            min_delta: 最小改善量
            save_path: 最佳模型保存路径
        """
        self.patience = patience
        self.min_delta = min_delta
        self.save_path = save_path
        self.counter = 0
        self.best_loss = None
        self.early_stop = False

    def __call__(self, val_loss, model):
        if self.best_loss is None:
            self.best_loss = val_loss
            self.save_checkpoint(model)
        elif val_loss > self.best_loss - self.min_delta:
            self.counter += 1
            print(f'EarlyStopping counter: {self.counter} out of {self.patience}')
            if self.counter >= self.patience:
                self.early_stop = True
        else:
            self.best_loss = val_loss
            self.save_checkpoint(model)
            self.counter = 0

    def save_checkpoint(self, model):
        """保存最佳模型"""
        torch.save(model.state_dict(), self.save_path)
        print(f'Validation loss decreased. Saving model to {self.save_path}')

# 模型路径
model_path = 'credit_model.pth'
best_model_path = 'best_credit_model.pth'

# 检查是否有已保存的模型
if os.path.exists(model_path):
    print("加载已保存的模型权重...")
    model = MLP(input_dim=input_size).to(device)
    model.load_state_dict(torch.load(model_path))
    print("模型权重加载成功!")
else:
    print("训练新模型...")
    # 实例化模型并移动到GPU
    model = MLP(input_dim=input_size).to(device)

    # 分类问题使用交叉熵损失函数
    criterion = nn.CrossEntropyLoss()

    # 使用Adam优化器(通常比SGD更好)
    optimizer = optim.Adam(model.parameters(), lr=0.001)

    # 初始化早停
    early_stopping = EarlyStopping(patience=15, min_delta=0.001, save_path=best_model_path)

    # 训练模型
    num_epochs = 20000
    losses = []
    val_losses = []

    start_time = time.time()

    for epoch in range(num_epochs):
        # 训练模式
        model.train()
        train_loss = 0

        # 使用数据加载器进行批处理
        for batch_X, batch_y in train_loader:
            optimizer.zero_grad()

            # 前向传播
            outputs = model(batch_X)
            loss = criterion(outputs, batch_y)

            # 反向传播和优化
            loss.backward()
            optimizer.step()

            train_loss += loss.item()

        avg_train_loss = train_loss / len(train_loader)
        losses.append(avg_train_loss)

        # 验证模式
        model.eval()
        with torch.no_grad():
            val_outputs = model(X_test_tensor)
            val_loss = criterion(val_outputs, y_test_tensor)
            val_losses.append(val_loss.item())

            # 计算准确率
            _, predicted = torch.max(val_outputs, 1)
            accuracy = accuracy_score(y_test_tensor.cpu(), predicted.cpu())

        # 早停检查
        early_stopping(val_loss.item(), model)

        # 打印训练信息
        if (epoch + 1) % 10 == 0:
            print(f'Epoch [{epoch+1}/{num_epochs}], '
                  f'Train Loss: {avg_train_loss:.4f}, '
                  f'Val Loss: {val_loss.item():.4f}, '
                  f'Accuracy: {accuracy:.4f}')

        if early_stopping.early_stop:
            print("早停触发!")
            break

    training_time = time.time() - start_time
    print(f'Training time: {training_time:.2f} seconds')

    # 保存最终模型
    torch.save(model.state_dict(), model_path)
    print(f"模型已保存到 {model_path}")

    # 可视化损失曲线
    plt.figure(figsize=(12, 4))

    plt.subplot(1, 2, 1)
    plt.plot(losses, label='Training Loss')
    plt.plot(val_losses, label='Validation Loss')
    plt.xlabel('Epoch')
    plt.ylabel('Loss')
    plt.title('Training and Validation Loss')
    plt.legend()
    plt.grid(True)

    plt.subplot(1, 2, 2)
    plt.plot(losses)
    plt.xlabel('Epoch')
    plt.ylabel('Loss')
    plt.title('Training Loss over Epochs')
    plt.grid(True)

    plt.tight_layout()
    plt.show()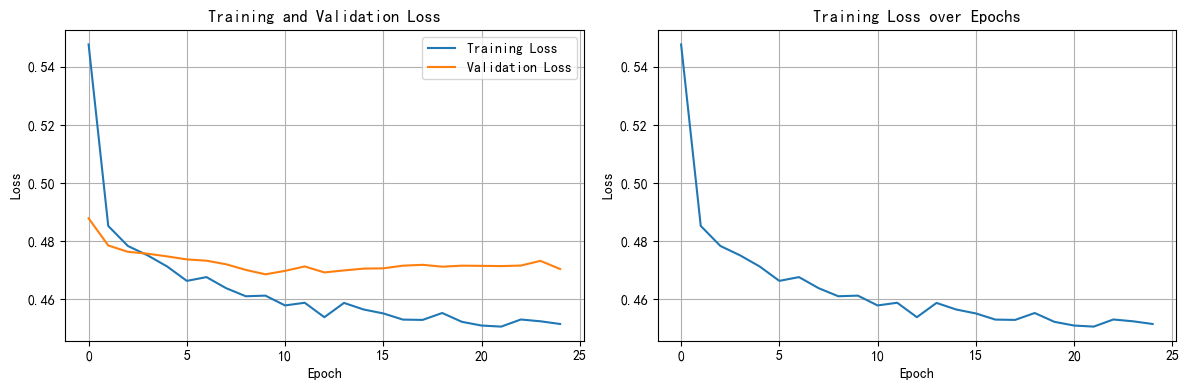
python
# ==================== 加载权重后继续训练50轮 ====================
print("\n" + "="*50)
print("开始继续训练50轮...")
print("="*50)

# 确保模型在正确的设备上
model = MLP(input_dim=input_size).to(device)

# 如果存在最佳模型,加载最佳模型权重
if os.path.exists(best_model_path):
    print(f"加载最佳模型权重: {best_model_path}")
    model.load_state_dict(torch.load(best_model_path, map_location=device))
elif os.path.exists(model_path):
    print(f"加载最终模型权重: {model_path}")
    model.load_state_dict(torch.load(model_path, map_location=device))

# 继续训练的优化器和损失函数
optimizer = optim.Adam(model.parameters(), lr=0.0005)  # 使用更小的学习率继续训练
criterion = nn.CrossEntropyLoss()

# 早停策略
continue_early_stopping = EarlyStopping(patience=10, min_delta=0.0005, save_path='continue_best_model.pth')

# 继续训练
continue_epochs = 50
continue_losses = []
continue_val_losses = []

start_time = time.time()

for epoch in range(continue_epochs):
    # 训练模式
    model.train()
    train_loss = 0

    for batch_X, batch_y in train_loader:
        optimizer.zero_grad()

        # 前向传播
        outputs = model(batch_X)
        loss = criterion(outputs, batch_y)

        # 反向传播和优化
        loss.backward()
        optimizer.step()

        train_loss += loss.item()

    avg_train_loss = train_loss / len(train_loader)
    continue_losses.append(avg_train_loss)

    # 验证模式
    model.eval()
    with torch.no_grad():
        val_outputs = model(X_test_tensor)
        val_loss = criterion(val_outputs, y_test_tensor)
        continue_val_losses.append(val_loss.item())

        # 计算准确率
        _, predicted = torch.max(val_outputs, 1)
        accuracy = accuracy_score(y_test_tensor.cpu().numpy(), predicted.cpu().numpy())

    # 早停检查
    continue_early_stopping(val_loss.item(), model)

    # 打印训练信息
    print(f'Continue Epoch [{epoch+1}/{continue_epochs}], '
          f'Train Loss: {avg_train_loss:.4f}, '
          f'Val Loss: {val_loss.item():.4f}, '
          f'Accuracy: {accuracy:.4f}')

    if continue_early_stopping.early_stop:
        print("继续训练早停触发!")
        break

continue_training_time = time.time() - start_time
print(f'继续训练时间: {continue_training_time:.2f} seconds')

# 保存继续训练后的模型
torch.save(model.state_dict(), 'final_continue_model.pth')
print("继续训练完成,模型已保存为 'final_continue_model.pth'")

# 可视化继续训练的损失曲线
plt.figure(figsize=(12, 4))

plt.subplot(1, 2, 1)
plt.plot(continue_losses, label='Continue Training Loss')
plt.plot(continue_val_losses, label='Continue Validation Loss')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.title('Continue Training Loss')
plt.legend()
plt.grid(True)

plt.subplot(1, 2, 2)
epoch_range = range(len(continue_losses))
plt.plot(epoch_range, continue_losses, 'b-', label='Train Loss')
plt.plot(epoch_range, continue_val_losses, 'r-', label='Val Loss')
plt.fill_between(epoch_range, continue_losses, continue_val_losses, alpha=0.2)
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.title('Continue Training Overview')
plt.legend()
plt.grid(True)

plt.tight_layout()
plt.show()

# ==================== 最终测试评估 ====================
print("\n" + "="*50)
print("在测试集上评估模型")
print("="*50)

# 确保模型处于评估模式
model.eval()

# 在测试集上进行预测
with torch.no_grad():
    # 注意:这里应该使用 X_test_tensor,而不是 X_test
    outputs = model(X_test_tensor)

    # 获取预测类别
    _, predicted = torch.max(outputs, 1)

    # 将张量转换为numpy数组进行比较
    y_pred = predicted.cpu().numpy()
    y_true = y_test_tensor.cpu().numpy()

    # 计算准确率
    correct = (y_pred == y_true).sum()
    total = len(y_true)
    accuracy = correct / total

    print(f'测试集准确率: {accuracy * 100:.2f}%')
    print(f'正确预测数: {correct}/{total}')

    # 计算更详细的评估指标
    from sklearn.metrics import classification_report, confusion_matrix

    print("\n分类报告:")
    print(classification_report(y_true, y_pred, target_names=['Non-Default', 'Default']))

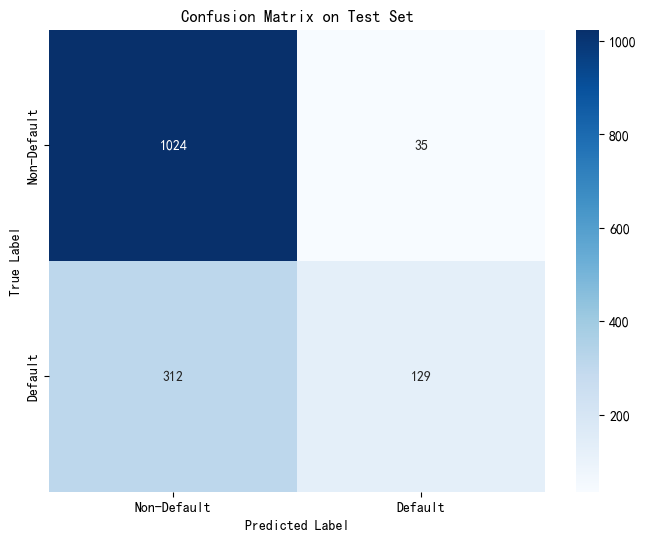
    # 绘制混淆矩阵
    cm = confusion_matrix(y_true, y_pred)
    plt.figure(figsize=(8, 6))
    sns.heatmap(cm, annot=True, fmt='d', cmap='Blues',
                xticklabels=['Non-Default', 'Default'],
                yticklabels=['Non-Default', 'Default'])
    plt.xlabel('Predicted Label')
    plt.ylabel('True Label')
    plt.title('Confusion Matrix on Test Set')
    plt.show()

# 清理GPU缓存
if torch.cuda.is_available():
    torch.cuda.empty_cache()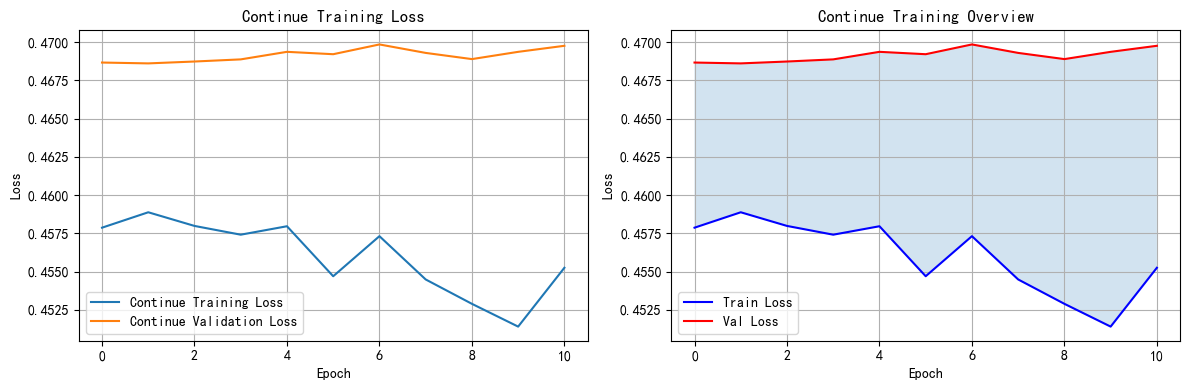
==================================================
在测试集上评估模型
==================================================
测试集准确率: 76.87%
正确预测数: 1153/1500
分类报告:
precision recall f1-score support
Non-Default 0.77 0.97 0.86 1059
Default 0.79 0.29 0.43 441
accuracy 0.77 1500
macro avg 0.78 0.63 0.64 1500
weighted avg 0.77 0.77 0.73 1500