1.迭代与周期
迭代不代表周期。
2.curriculum监督
2.1 伪标签
伪标签Pseudo-Labeling (PL)是半监督学习中常用的方法,核心思路是 "用已训练的模型给未标记数据'贴标签',再用这些'伪标签数据 + 真实标签数据'一起训练模型"
使用伪标签训练步骤: 1)用少量真实标记数据 (比如 10% 带标签的图像)训练一个初始模型称 为 "教师模型" 。2)用这个初始模型对大量未标记数据(比如 90% 无标签的图像预 测,将 "预测概率最高的类别" 作为这些未标记数据的 "伪标签"。3)把 "真实标签数据 + 筛选后的高置信度伪标签数据" 混合,重新训练模型(更新模型参数),完成一个 "自训练周期"。4)重复步骤 2-3:用新训练的模型再生成一批伪标签,继续混合训练,直到模型性能稳定。
伪标签训练缺点: 若初始模型有偏差(比如对 "狗" 的预测准确率低),生成的伪标签会带有错误;而后续训练又用这些错误伪标签更新参数,会导致偏差不断累积------ 这就是下文要提的 "概念漂移"。
2.1 课程标签curriculum labeling(CL)
两大特点从训练方式上解决之前伪标签训练遇到的"一错再错问题",分别为:
1)课程学习原则: 模仿人类 "从易到难" 的学习逻辑,先让模型用 "简单的未标记数据" (即模型预测置信度极高、几乎不会错的数据,比如预测 "猫" 概率 99% 的数据)生成伪标签并训练;随着模型能力提升,再逐步引入 "较难的未标记数据"(比如预测置信度 85% 的数据),减少错误伪标签的干扰。
2)周期前参数重启 :每次开始新的自训练周期前,不沿用上个周期训练后的模型参数 ,而是重新加载 "初始模型的参数"(或基于真实标签数据重新训练一个干净的初始模型),再用这个 "无偏差的初始模型" 去生成当前周期的伪标签,之后结合 "课程学习" 筛选数据并训练。
3.启用梯度检查点(Gradient Checkpointing)
解决问题:GPU训练使用显存过大
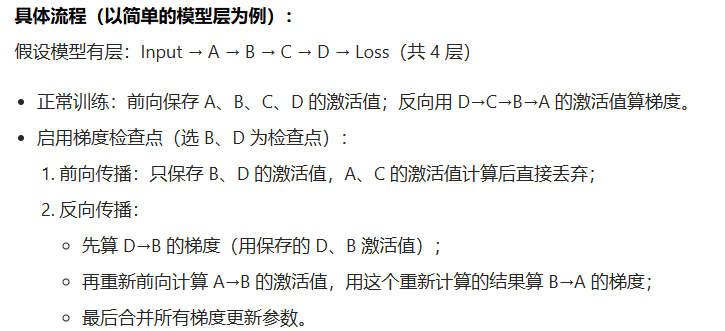
问题产生原因: 当模型极深(比如 GPT-3、ViT-L)或批次量很大时,前向传播会产生海量中间激活值 ,这些数据会占满 GPU 显存,导致训练中断(报 OOM 错误)。而梯度检查点的核心就是 "牺牲少量计算时间,换取显存空间"。
使用步骤:不保存所有中间激活值,只选择性保存部分 "检查点" 位置的激活值;反向传播时,对非检查点的层,重新计算其激活值,而非直接读取显存中的缓存。
示例:
4.训练模型输出图片偏黄/偏绿
问题示例:
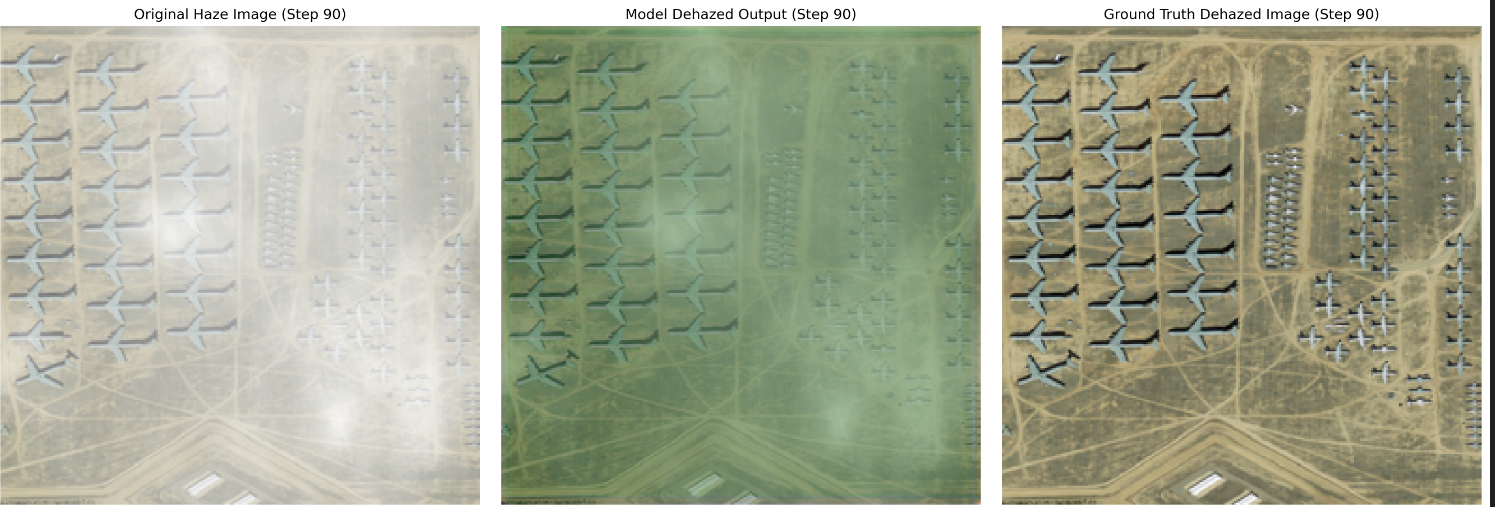
问题分析原因 :核心是图像数据的归一化 / 反归一化逻辑错误 、颜色通道处理不当 或模型训练偏差导致的像素值分布异常。
**解决方法:**1. 自动检测归一化范围并正确反归一化(-1,1/0,1/0,255)
-
BGR→RGB 通道转换
-
添加通道均衡损失约束颜色分布
-
禁用插值缩放,使用原始图像尺寸保存