随机梯度下降(SGD)与 Adam 优化器的区别与联系(公式化 + 简洁版)
你希望清晰了解两者的核心差异、关联及公式表达,下面将从核心定义、公式、联系、区别四个维度展开,确保简洁明了。
一、核心定义(先明确基础)
- 随机梯度下降(SGD):每次迭代仅使用 ** 单个样本(或小批量样本)** 计算梯度,更新模型参数,是批量梯度下降(BGD)的简化版,兼顾训练效率与收敛效果。
- Adam(Adaptive Moment Estimation) :自适应学习率优化器,融合了动量(Momentum)和RMSprop的优点,能自适应调整每个参数的学习率,是当前深度学习中最常用的优化器之一。
二、公式化表达
1. 随机梯度下降(SGD,含基础版 + 动量版)
(1)基础 SGD 公式
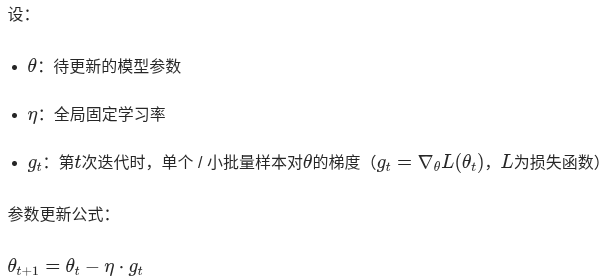
(2)SGD + 动量(Momentum,优化基础版震荡问题)
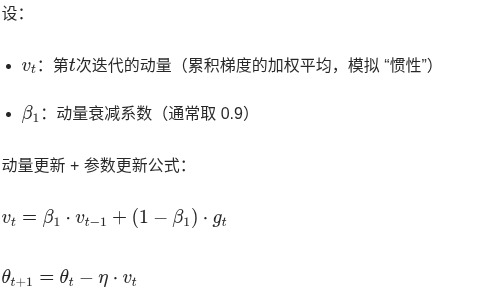
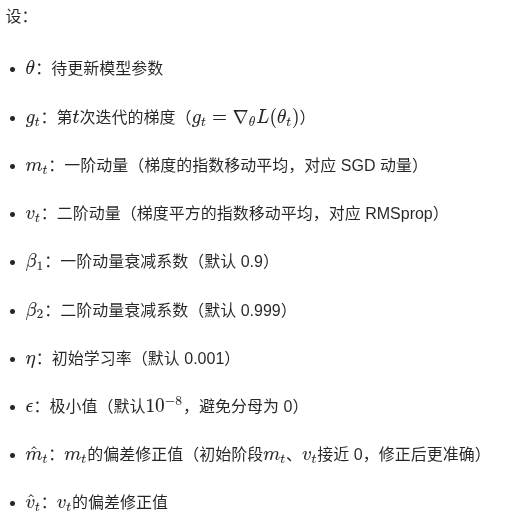
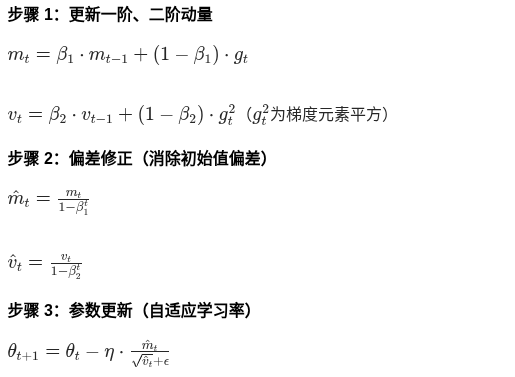
2. Adam 优化器公式
Adam 引入一阶动量(梯度均值)和二阶动量(梯度方差),实现自适应学习率,核心公式如下:
设:
三、两者的联系
- 核心目标一致 :均为最小化损失函数
,通过梯度下降更新模型参数。
- Adam 包含 SGD 动量的思想 :Adam 的一阶动量
- 均支持小批量训练:两者都可基于小批量样本(Mini-Batch)计算梯度,平衡训练效率与梯度估计的准确性。
四、两者的核心区别
| 对比维度 | 随机梯度下降(SGD) | Adam 优化器 |
|---|---|---|
| 学习率特性 | 全局固定学习率\(\eta\),所有参数共享 | 自适应学习率,每个参数有独立学习率 |
| 动量机制 | 仅一阶动量(可选,基础 SGD 无动量) | 同时包含一阶动量(梯度均值)+ 二阶动量(梯度方差) |
| 收敛速度 | 较慢,易在鞍点 / 局部最优附近震荡 | 较快,自适应调整减少震荡 |
| 超参数敏感性 | 对学习率η敏感,需手动调优 | 对初始超参数 |
| 过拟合风险 | 相对较低(训练过程波动带来一定正则化效果) | 相对较高(收敛过快易过拟合,可通过权重衰减缓解) |
| 计算复杂度 | 低,仅需计算梯度和简单参数更新 | 稍高,需额外维护一阶 / 二阶动量变量 |
| 适用场景 | 数据量较大、模型简单,或需要强正则化场景 | 数据量较小、模型复杂(如深度神经网络),追求快速收敛场景 |
总结
- 公式核心:SGD 是 "固定学习率 + 梯度直接更新",Adam 是 "一阶 / 二阶动量 + 偏差修正 + 自适应学习率更新";
- 联系:均为梯度下降优化算法,Adam 继承了 SGD 的动量思想;
- 区别:核心在 "学习率是否自适应" 和 "动量维度多少",导致收敛速度、适用场景等差异。